


 Heim
Metakognition könnte der Schlüssel zur Beendigung von Halluzinationen in großen Modellen sein
Halluzinationen großer Modelle – bei denen KI sachliche Fehler mit absoluter Überzeugung präsentiert – stellen seit langem eine zentrale Herausforderung in der KI-Branche dar. Dieses Problem wird in risikoreichen Bereichen wie dem Gesundheitswesen und dem Rechtswesen besonders kritisch.
Seit Jahren verfolgt die Branche hauptsächlich zwei Strategien, um Halluzinationen zu bekämpfen: Die eine besteht darin, die Trainingsdaten massiv zu erweitern, um die KI „allwissend“ zu machen; die andere darin, Abwehrmechanismen zu entwickeln, die die KI dazu anhalten, bei Unsicherheit „zu schweigen“. Beide Ansätze weisen jedoch klare Grenzen auf. Der erste Ansatz kann nicht jede existierende Tatsache abdecken, wodurch blinde Flecken entstehen. Der zweite führt oft zu einer hohen „Nutzungssteuer“: In dem Bestreben, Fehler zu beseitigen, weigert sich die KI letztendlich, viele richtige Fragen zu beantworten, was die Benutzererfahrung erheblich beeinträchtigt.
Kürzlich bietet eine gemeinsam von Google Research und der Universität Tel Aviv verfasste Studie eine neue Perspektive auf dieses Dilemma: Metakognition. Die Studie legt nahe, dass der Schlüssel zur Lösung des Problems der Halluzinationen nicht darin besteht, die KI zu zwingen, niemals Fehler zu machen, sondern ihr zu ermöglichen, „zu wissen, was sie weiß – und was sie nicht weiß“.
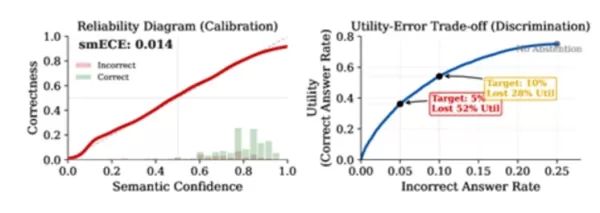
Abbildung: Der Unterschied zwischen Kalibrierung und Unterscheidungsvermögen. Links ist ein gut kalibriertes Modell dargestellt (rote Linie nahe der Diagonalen), während rechts die harte Realität deutlich wird: Selbst bei perfekter Kalibrierung erfordert die Senkung der Fehlerquote von 25 % auf 5 % den Verlust von 52 % der richtigen Antworten.
Die Arbeit definiert Halluzinationen neu: Das Kernproblem ist nicht, ob KI-Ausgaben falsch sind, sondern ob sie Nutzer mit einem selbstbewussten Ton in die Irre führen, wenn das System unsicher ist. Die Forscher argumentieren, dass KI die Fähigkeit zur „ehrlichen Unsicherheit“ besitzen sollte. Das heißt: Wenn der interne Zustand des Modells Zögern oder geringe Sicherheit signalisiert, sollte seine Sprache Vorsicht und Zurückhaltung widerspiegeln – anstatt so zu tun, als würde es absolute Fakten darlegen.
Metakognition bezieht sich auf das Bewusstsein der KI für ihre eigenen kognitiven Prozesse. Dies erfordert, dass große Modelle ihre internen Zustände sensibel wahrnehmen und auf der Grundlage dieser Wahrnehmung ihre Konfidenzniveaus ehrlich zum Ausdruck bringen. Im Zeitalter der KI-Agenten ist diese Fähigkeit besonders wichtig. Ein KI-System ohne Metakognition ist wie ein Pilot ohne Cockpit – es kann weder entscheiden, wann externe Hilfsmittel herangezogen werden müssen, noch die Zuverlässigkeit von Suchergebnissen überprüfen, was es anfällig für den Missbrauch von Hilfsmitteln und sogar für „Blindflug“ macht.
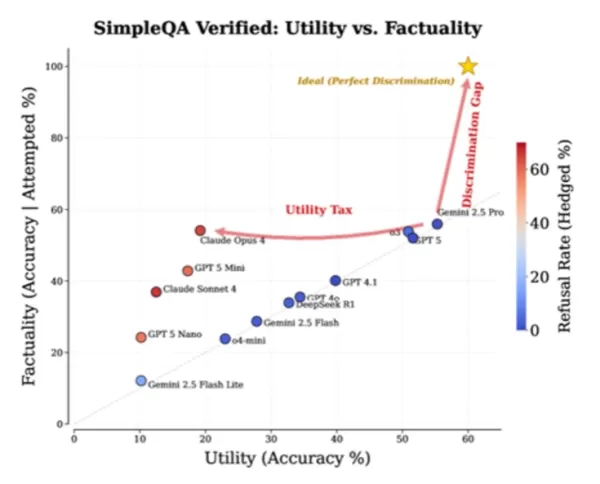
Abbildung: Tatsächliche Leistung führender Modelle bei SimpleQA Verified. Der fünfzackige Stern oben rechts markiert das ideale Ziel; „Discrimination Gap“ gibt den Abstand zwischen aktuellen Modellen und diesem Ideal an, während „Utility Tax“ die Kosten zeigt, die Claude Opus4 auf sich nimmt, um eine hohe Genauigkeit zu erreichen.
Natürlich ist die Umsetzung dieses Ansatzes mit erheblichen Herausforderungen verbunden. Zum Beispiel stellt sich die Frage, wie man „echte Metakognition“ von „absichtlich vorgetäuschter Unsicherheit“ unterscheiden kann und wie sich die negativen Auswirkungen von RLHF (Reinforcement Learning from Human Feedback) vermeiden lassen – da Menschen dazu neigen, selbstbewusste Antworten zu bevorzugen, was die KI in gewisser Weise tatsächlich dazu ermutigt, zu lernen, Selbstsicherheit vorzutäuschen.
Für die Zukunft der KI-Entwicklung bietet die Studie praktische Empfehlungen: Bewertungsmetriken für Anti-Halluzinations-Technologien sollten sich nicht mehr ausschließlich auf die Genauigkeit konzentrieren, sondern stattdessen das Gleichgewicht zwischen „Nutzen und Fehlerquote“ bewerten. KI muss keine unfehlbare Maschine werden, aber sie muss eine grundlegende fachliche Eigenschaft besitzen: die Fähigkeit, ehrlich zwischen „Ich bin mir sicher“ und „Ich rate“ zu unterscheiden. Dieses klare Bewusstsein für die Grenzen des eigenen Wissens ist der wesentliche Weg zur Verbesserung der Glaubwürdigkeit und des praktischen Nutzens der KI.
Verwandter Artikel
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Halluzinationen großer Modelle – bei denen KI sachliche Fehler mit absoluter Überzeugung präsentiert – stellen seit langem eine zentrale Herausforderung in der KI-Branche dar. Dieses Problem wird in risikoreichen Bereichen wie dem Gesundheitswesen und dem Rechtswesen besonders kritisch.
Seit Jahren verfolgt die Branche hauptsächlich zwei Strategien, um Halluzinationen zu bekämpfen: Die eine besteht darin, die Trainingsdaten massiv zu erweitern, um die KI „allwissend“ zu machen; die andere darin, Abwehrmechanismen zu entwickeln, die die KI dazu anhalten, bei Unsicherheit „zu schweigen“. Beide Ansätze weisen jedoch klare Grenzen auf. Der erste Ansatz kann nicht jede existierende Tatsache abdecken, wodurch blinde Flecken entstehen. Der zweite führt oft zu einer hohen „Nutzungssteuer“: In dem Bestreben, Fehler zu beseitigen, weigert sich die KI letztendlich, viele richtige Fragen zu beantworten, was die Benutzererfahrung erheblich beeinträchtigt.
Kürzlich bietet eine gemeinsam von Google Research und der Universität Tel Aviv verfasste Studie eine neue Perspektive auf dieses Dilemma: Metakognition. Die Studie legt nahe, dass der Schlüssel zur Lösung des Problems der Halluzinationen nicht darin besteht, die KI zu zwingen, niemals Fehler zu machen, sondern ihr zu ermöglichen, „zu wissen, was sie weiß – und was sie nicht weiß“.
Abbildung: Der Unterschied zwischen Kalibrierung und Unterscheidungsvermögen. Links ist ein gut kalibriertes Modell dargestellt (rote Linie nahe der Diagonalen), während rechts die harte Realität deutlich wird: Selbst bei perfekter Kalibrierung erfordert die Senkung der Fehlerquote von 25 % auf 5 % den Verlust von 52 % der richtigen Antworten.
Die Arbeit definiert Halluzinationen neu: Das Kernproblem ist nicht, ob KI-Ausgaben falsch sind, sondern ob sie Nutzer mit einem selbstbewussten Ton in die Irre führen, wenn das System unsicher ist. Die Forscher argumentieren, dass KI die Fähigkeit zur „ehrlichen Unsicherheit“ besitzen sollte. Das heißt: Wenn der interne Zustand des Modells Zögern oder geringe Sicherheit signalisiert, sollte seine Sprache Vorsicht und Zurückhaltung widerspiegeln – anstatt so zu tun, als würde es absolute Fakten darlegen.
Metakognition bezieht sich auf das Bewusstsein der KI für ihre eigenen kognitiven Prozesse. Dies erfordert, dass große Modelle ihre internen Zustände sensibel wahrnehmen und auf der Grundlage dieser Wahrnehmung ihre Konfidenzniveaus ehrlich zum Ausdruck bringen. Im Zeitalter der KI-Agenten ist diese Fähigkeit besonders wichtig. Ein KI-System ohne Metakognition ist wie ein Pilot ohne Cockpit – es kann weder entscheiden, wann externe Hilfsmittel herangezogen werden müssen, noch die Zuverlässigkeit von Suchergebnissen überprüfen, was es anfällig für den Missbrauch von Hilfsmitteln und sogar für „Blindflug“ macht.
Abbildung: Tatsächliche Leistung führender Modelle bei SimpleQA Verified. Der fünfzackige Stern oben rechts markiert das ideale Ziel; „Discrimination Gap“ gibt den Abstand zwischen aktuellen Modellen und diesem Ideal an, während „Utility Tax“ die Kosten zeigt, die Claude Opus4 auf sich nimmt, um eine hohe Genauigkeit zu erreichen.
Natürlich ist die Umsetzung dieses Ansatzes mit erheblichen Herausforderungen verbunden. Zum Beispiel stellt sich die Frage, wie man „echte Metakognition“ von „absichtlich vorgetäuschter Unsicherheit“ unterscheiden kann und wie sich die negativen Auswirkungen von RLHF (Reinforcement Learning from Human Feedback) vermeiden lassen – da Menschen dazu neigen, selbstbewusste Antworten zu bevorzugen, was die KI in gewisser Weise tatsächlich dazu ermutigt, zu lernen, Selbstsicherheit vorzutäuschen.
Für die Zukunft der KI-Entwicklung bietet die Studie praktische Empfehlungen: Bewertungsmetriken für Anti-Halluzinations-Technologien sollten sich nicht mehr ausschließlich auf die Genauigkeit konzentrieren, sondern stattdessen das Gleichgewicht zwischen „Nutzen und Fehlerquote“ bewerten. KI muss keine unfehlbare Maschine werden, aber sie muss eine grundlegende fachliche Eigenschaft besitzen: die Fähigkeit, ehrlich zwischen „Ich bin mir sicher“ und „Ich rate“ zu unterscheiden. Dieses klare Bewusstsein für die Grenzen des eigenen Wissens ist der wesentliche Weg zur Verbesserung der Glaubwürdigkeit und des praktischen Nutzens der KI.








 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












