


 Maison
TIPSv2 de Google DeepMind : une IA qui comprend véritablement les images, et ne se contente pas d'y jeter un simple coup d'œil
La compréhension des images par l'IA présente actuellement une limite majeure.
À la question « Que voit-on sur cette image ? », elle peut fournir une réponse détaillée. En revanche, si l'on demande « Où se trouve la patte arrière gauche du panda ? », les réponses sont vagues. Il ne s'agit pas d'une faille propre à un modèle spécifique, mais d'un problème récurrent dans l'ensemble du domaine des grands modèles visuels-linguistiques : une forte compréhension globale, mais une localisation locale faible.
Google DeepMind a présenté TIPSv2 dans son dernier article, spécialement conçu pour résoudre ce problème complexe.
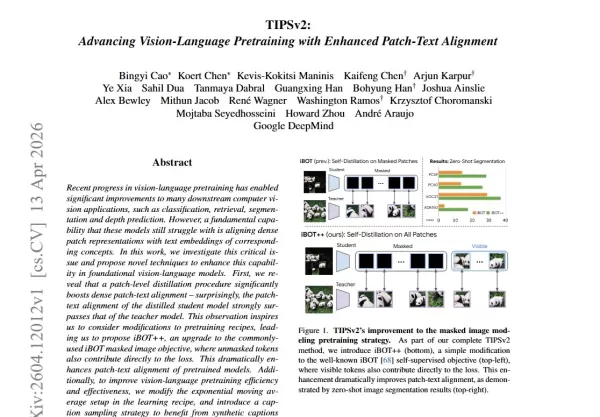
L'équipe de recherche a fait une observation contre-intuitive : dans les tâches de segmentation fine, les petits modèles « élèves » surpassent souvent les grands modèles « enseignants ». Cela s'explique par le fait que la distillation supprime le mécanisme de masquage, obligeant le modèle à apprendre chaque détail de l'image entière, ce qui crée une forme de « supervision sur toute la surface ». Fort de cette intuition, TIPSv2 a introduit trois améliorations clés.
Premièrement, iBOT++. Le pré-entraînement traditionnel ne calcule la perte que pour les régions masquées, laissant les zones visibles dans un état négligé qui entraîne une dérive de la sémantique locale. iBOT++ exige du modèle qu’il assure une supervision précise sur toutes les zones visibles, faisant passer la tâche d’un « jeu de puzzle » à une « lecture attentive de l’intégralité du texte ». Cette seule amélioration a boosté les performances de segmentation en zéro-shot de 14,1 points de pourcentage.
Deuxièmement, l’EMA « Head-only ». L’entraînement auto-supervisé traditionnel nécessite de conserver en mémoire deux grands modèles presque identiques, ce qui est très gourmand en ressources. TIPSv2 a découvert que la perte contrastive image-texte suffit à elle seule à stabiliser le réseau de base ; l’EMA n’a donc besoin d’être appliquée qu’à la tête de projection finale, éliminant ainsi la nécessité de dupliquer le réseau de base. Cela réduit le nombre de paramètres d’entraînement d’environ 42 %, ce qui accélère le processus sans perte de performance notable.
Troisièmement, l'appariement de textes à granularité multiple. Pendant l'entraînement, des descriptions web courtes, des descriptions moyennement détaillées et des descriptions longues générées par Gemini sont mélangées de manière aléatoire et introduites dans le modèle, en alternant entre des tâches faciles et difficiles. Cela empêche le modèle de se reposer sur ses lauriers lors de tâches simples tout en garantissant qu'aucun détail n'est négligé.
Les résultats finaux sont convaincants. TIPSv2 a fait l’objet d’une évaluation « frozen » sur neuf tâches et 20 ensembles de données de référence. La segmentation sémantique « zero-shot » a établi une nouvelle référence dans le secteur, tandis que la recherche et la classification image-texte ont surpassé les modèles de comparaison comportant 56 % de paramètres en plus. Les tâches purement visuelles se sont également classées parmi les plus performantes.
Le code et les poids du modèle de TIPSv2 sont entièrement open source. Pour les équipes travaillant dans l'imagerie médicale, la conduite autonome, l'inspection industrielle et d'autres domaines exigeant une compréhension d'images de haute précision, cette solution mérite d'être examinée de près.
Article : https://www.alphaxiv.org/abs/2604.12012
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (0)
La compréhension des images par l'IA présente actuellement une limite majeure.
À la question « Que voit-on sur cette image ? », elle peut fournir une réponse détaillée. En revanche, si l'on demande « Où se trouve la patte arrière gauche du panda ? », les réponses sont vagues. Il ne s'agit pas d'une faille propre à un modèle spécifique, mais d'un problème récurrent dans l'ensemble du domaine des grands modèles visuels-linguistiques : une forte compréhension globale, mais une localisation locale faible.
Google DeepMind a présenté TIPSv2 dans son dernier article, spécialement conçu pour résoudre ce problème complexe.
L'équipe de recherche a fait une observation contre-intuitive : dans les tâches de segmentation fine, les petits modèles « élèves » surpassent souvent les grands modèles « enseignants ». Cela s'explique par le fait que la distillation supprime le mécanisme de masquage, obligeant le modèle à apprendre chaque détail de l'image entière, ce qui crée une forme de « supervision sur toute la surface ». Fort de cette intuition, TIPSv2 a introduit trois améliorations clés.
Premièrement, iBOT++. Le pré-entraînement traditionnel ne calcule la perte que pour les régions masquées, laissant les zones visibles dans un état négligé qui entraîne une dérive de la sémantique locale. iBOT++ exige du modèle qu’il assure une supervision précise sur toutes les zones visibles, faisant passer la tâche d’un « jeu de puzzle » à une « lecture attentive de l’intégralité du texte ». Cette seule amélioration a boosté les performances de segmentation en zéro-shot de 14,1 points de pourcentage.
Deuxièmement, l’EMA « Head-only ». L’entraînement auto-supervisé traditionnel nécessite de conserver en mémoire deux grands modèles presque identiques, ce qui est très gourmand en ressources. TIPSv2 a découvert que la perte contrastive image-texte suffit à elle seule à stabiliser le réseau de base ; l’EMA n’a donc besoin d’être appliquée qu’à la tête de projection finale, éliminant ainsi la nécessité de dupliquer le réseau de base. Cela réduit le nombre de paramètres d’entraînement d’environ 42 %, ce qui accélère le processus sans perte de performance notable.
Troisièmement, l'appariement de textes à granularité multiple. Pendant l'entraînement, des descriptions web courtes, des descriptions moyennement détaillées et des descriptions longues générées par Gemini sont mélangées de manière aléatoire et introduites dans le modèle, en alternant entre des tâches faciles et difficiles. Cela empêche le modèle de se reposer sur ses lauriers lors de tâches simples tout en garantissant qu'aucun détail n'est négligé.
Les résultats finaux sont convaincants. TIPSv2 a fait l’objet d’une évaluation « frozen » sur neuf tâches et 20 ensembles de données de référence. La segmentation sémantique « zero-shot » a établi une nouvelle référence dans le secteur, tandis que la recherche et la classification image-texte ont surpassé les modèles de comparaison comportant 56 % de paramètres en plus. Les tâches purement visuelles se sont également classées parmi les plus performantes.
Le code et les poids du modèle de TIPSv2 sont entièrement open source. Pour les équipes travaillant dans l'imagerie médicale, la conduite autonome, l'inspection industrielle et d'autres domaines exigeant une compréhension d'images de haute précision, cette solution mérite d'être examinée de près.
Article : https://www.alphaxiv.org/abs/2604.12012








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai












