


 Heim
TIPSv2 von Google DeepMind: Eine KI, die Bilder wirklich versteht und nicht nur flüchtig betrachtet
Das Bildverständnis durch KI weist derzeit eine wesentliche Einschränkung auf.
Auf die Frage „Was ist auf diesem Bild zu sehen?“ kann es eine detaillierte Antwort geben. Die Frage „Wo befindet sich das linke Hinterbein des Pandas?“ führt jedoch zu vagen Antworten. Dies ist kein Fehler eines bestimmten Modells, sondern ein hartnäckiges Problem im gesamten Bereich der großen visuell-sprachlichen Modelle: starkes globales Verständnis, aber schwache lokale Lokalisierung.
Google DeepMind hat in seiner neuesten Veröffentlichung TIPSv2 vorgestellt, das speziell zur Lösung dieses schwierigen Problems entwickelt wurde.
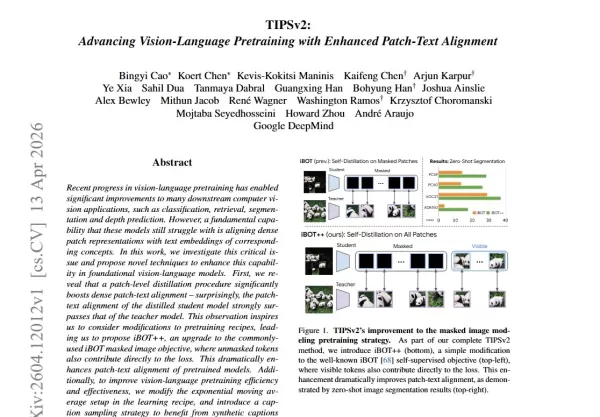
Das Forschungsteam machte eine kontraintuitive Beobachtung: Bei feinmaschigen Segmentierungsaufgaben schneiden kleinere „Schüler“-Modelle häufig besser ab als größere „Lehrer“-Modelle. Dies geschieht, weil durch die Destillation der Maskierungsmechanismus entfernt wird, wodurch das Modell gezwungen ist, jedes Detail des gesamten Bildes zu lernen, was eine Form der „Vollbereichsüberwachung“ schafft. Motiviert durch diese Erkenntnis führte TIPSv2 drei wesentliche Verbesserungen ein.
Erstens: iBOT++. Bei herkömmlichem Vortraining wird der Verlust nur für maskierte Bereiche berechnet, wodurch sichtbare Bereiche vernachlässigt werden, was zu einer Abweichung der lokalen Semantik führt. iBOT++ verlangt vom Modell eine präzise Überwachung aller sichtbaren Bereiche und wertet die Aufgabe damit effektiv von einem „Puzzlespiel“ zu einem „sorgfältigen Lesen des gesamten Textes“ auf. Diese einzelne Verbesserung steigerte die Zero-Shot-Segmentationsleistung um 14,1 Prozentpunkte.
Zweitens: Head-only EMA. Herkömmliches selbstüberwachtes Training erfordert, zwei nahezu identische große Modelle im Speicher zu halten, was sehr ressourcenintensiv ist. TIPSv2 hat herausgefunden, dass der bild-text-kontrastive Verlust allein ausreicht, um das Backbone-Netzwerk zu stabilisieren, sodass EMA nur auf den finalen Projektionskopf angewendet werden muss, wodurch die Notwendigkeit entfällt, das Backbone zu duplizieren. Dies reduziert die Anzahl der Trainingsparameter um etwa 42 % und beschleunigt den Prozess fast ohne Leistungseinbußen.
Drittens: Textpaarung mit mehreren Granularitätsstufen. Während des Trainings werden kurze Webbeschreibungen, mitteldetailierte Beschreibungen und lange Beschreibungen, die von Gemini generiert wurden, zufällig gemischt und dem Modell zugeführt, wobei zwischen einfachen und schwierigen Aufgaben abgewechselt wird. Dies verhindert, dass sich das Modell bei einfachen Aufgaben ausruht, und stellt gleichzeitig sicher, dass keine Details übersehen werden.
Die Endergebnisse sind überzeugend. TIPSv2 wurde einer Frozen-Evaluation über neun Aufgaben und 20 maßgebliche Datensätze unterzogen. Die Zero-Shot-Semantiksegmentierung erreichte einen neuen Branchen-Benchmark, während die Bild-Text-Suche und -Klassifizierung Vergleichsmodelle mit 56 % mehr Parametern übertraf. Auch rein visuelle Aufgaben gehörten zu den Spitzenreitern.
Der Code und die Modellgewichte für TIPSv2 sind vollständig als Open Source verfügbar. Für Teams, die in den Bereichen medizinische Bildgebung, autonomes Fahren, industrielle Inspektion und anderen Domänen arbeiten, die ein hochpräzises Bildverständnis erfordern, ist diese Lösung einen genauen Blick wert.
Artikel: https://www.alphaxiv.org/abs/2604.12012
Verwandter Artikel
 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Empfehlungen zu verwandten Spezialthemen
SEO
 Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
 13 Tools
 xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

 Kommentare (0)
Das Bildverständnis durch KI weist derzeit eine wesentliche Einschränkung auf.
Auf die Frage „Was ist auf diesem Bild zu sehen?“ kann es eine detaillierte Antwort geben. Die Frage „Wo befindet sich das linke Hinterbein des Pandas?“ führt jedoch zu vagen Antworten. Dies ist kein Fehler eines bestimmten Modells, sondern ein hartnäckiges Problem im gesamten Bereich der großen visuell-sprachlichen Modelle: starkes globales Verständnis, aber schwache lokale Lokalisierung.
Google DeepMind hat in seiner neuesten Veröffentlichung TIPSv2 vorgestellt, das speziell zur Lösung dieses schwierigen Problems entwickelt wurde.
Das Forschungsteam machte eine kontraintuitive Beobachtung: Bei feinmaschigen Segmentierungsaufgaben schneiden kleinere „Schüler“-Modelle häufig besser ab als größere „Lehrer“-Modelle. Dies geschieht, weil durch die Destillation der Maskierungsmechanismus entfernt wird, wodurch das Modell gezwungen ist, jedes Detail des gesamten Bildes zu lernen, was eine Form der „Vollbereichsüberwachung“ schafft. Motiviert durch diese Erkenntnis führte TIPSv2 drei wesentliche Verbesserungen ein.
Erstens: iBOT++. Bei herkömmlichem Vortraining wird der Verlust nur für maskierte Bereiche berechnet, wodurch sichtbare Bereiche vernachlässigt werden, was zu einer Abweichung der lokalen Semantik führt. iBOT++ verlangt vom Modell eine präzise Überwachung aller sichtbaren Bereiche und wertet die Aufgabe damit effektiv von einem „Puzzlespiel“ zu einem „sorgfältigen Lesen des gesamten Textes“ auf. Diese einzelne Verbesserung steigerte die Zero-Shot-Segmentationsleistung um 14,1 Prozentpunkte.
Zweitens: Head-only EMA. Herkömmliches selbstüberwachtes Training erfordert, zwei nahezu identische große Modelle im Speicher zu halten, was sehr ressourcenintensiv ist. TIPSv2 hat herausgefunden, dass der bild-text-kontrastive Verlust allein ausreicht, um das Backbone-Netzwerk zu stabilisieren, sodass EMA nur auf den finalen Projektionskopf angewendet werden muss, wodurch die Notwendigkeit entfällt, das Backbone zu duplizieren. Dies reduziert die Anzahl der Trainingsparameter um etwa 42 % und beschleunigt den Prozess fast ohne Leistungseinbußen.
Drittens: Textpaarung mit mehreren Granularitätsstufen. Während des Trainings werden kurze Webbeschreibungen, mitteldetailierte Beschreibungen und lange Beschreibungen, die von Gemini generiert wurden, zufällig gemischt und dem Modell zugeführt, wobei zwischen einfachen und schwierigen Aufgaben abgewechselt wird. Dies verhindert, dass sich das Modell bei einfachen Aufgaben ausruht, und stellt gleichzeitig sicher, dass keine Details übersehen werden.
Die Endergebnisse sind überzeugend. TIPSv2 wurde einer Frozen-Evaluation über neun Aufgaben und 20 maßgebliche Datensätze unterzogen. Die Zero-Shot-Semantiksegmentierung erreichte einen neuen Branchen-Benchmark, während die Bild-Text-Suche und -Klassifizierung Vergleichsmodelle mit 56 % mehr Parametern übertraf. Auch rein visuelle Aufgaben gehörten zu den Spitzenreitern.
Der Code und die Modellgewichte für TIPSv2 sind vollständig als Open Source verfügbar. Für Teams, die in den Bereichen medizinische Bildgebung, autonomes Fahren, industrielle Inspektion und anderen Domänen arbeiten, die ein hochpräzises Bildverständnis erfordern, ist diese Lösung einen genauen Blick wert.
Artikel: https://www.alphaxiv.org/abs/2604.12012








 Suno fügt Wasserzeichen in Songs ein, während Rechtsstreitigkeiten andauern
Suno, die Plattform, die es Nutzern ermöglicht, KI-generierte Musik zu erstellen, hat neue Funktionen vorgestellt, um plattformproduzierte Tracks zu kennzeichnen, Downloads einzuschränken und die Community-Richtlinien zu aktualisieren, um unbefugte K
 Musk räumt ein, dass Grok-Build Benutzercode geleakt hat, verspricht aber, alle historischen Daten zu löschen
Elon Musk wandte sich direkt an die Datenschutzkontroverse um Grok Build, beginnend mit einem einfachen „True“, um die Gültigkeit des Vorfalls zu bestätigen. Er versprach, dass alle zuvor bei SpaceXAI hochgeladenen Benutzerdaten unwiderruflich gelösc
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai












