


 Hogar
TIPSv2 de Google DeepMind: una IA que realmente entiende las imágenes, no solo las ojea
Actualmente, la comprensión de imágenes por parte de la IA presenta una limitación fundamental.
Cuando se le pregunta «¿Qué hay en esta imagen?», puede dar una respuesta detallada. Sin embargo, si se le pregunta «¿Dónde está la pata trasera izquierda del panda?», las respuestas son vagas. No se trata de un defecto de ningún modelo concreto, sino de un problema persistente en todo el ámbito de los grandes modelos de lenguaje visual: una sólida comprensión global, pero una localización local deficiente.
Google DeepMind presentó TIPSv2 en su último artículo, diseñado específicamente para abordar este complejo problema.
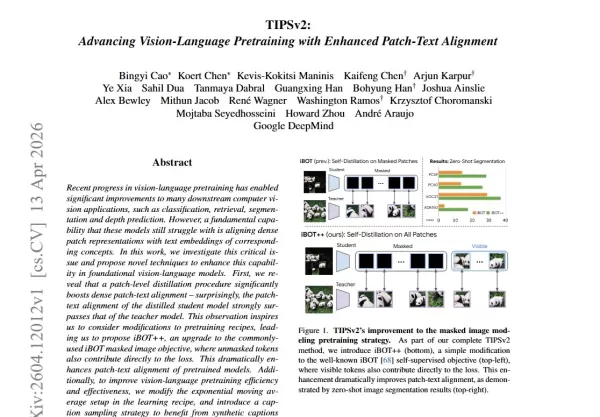
El equipo de investigación observó un hallazgo contraintuitivo: en tareas de segmentación de alta resolución, los modelos «estudiantes» más pequeños suelen superar a los modelos «profesores» más grandes. Esto ocurre porque la destilación elimina el mecanismo de enmascaramiento, lo que obliga al modelo a aprender cada detalle de toda la imagen, creando una forma de «supervisión de área completa». Motivado por esta idea, TIPSv2 introdujo tres mejoras clave.
En primer lugar, iBOT++. El preentrenamiento tradicional solo calcula la pérdida para las regiones enmascaradas, dejando las áreas visibles en un estado de descuido que provoca la deriva de la semántica local. iBOT++ exige que el modelo proporcione una supervisión precisa sobre todas las áreas visibles, lo que eleva efectivamente la tarea de un «juego de rompecabezas» a «leer atentamente todo el texto». Esta única mejora aumentó el rendimiento de la segmentación sin entrenamiento previo en 14,1 puntos porcentuales.
En segundo lugar, EMA solo para la cabeza. El entrenamiento autosupervisado tradicional requiere mantener en memoria dos modelos grandes casi idénticos, lo que consume muchos recursos. TIPSv2 descubrió que la pérdida contrastiva imagen-texto por sí sola es suficiente para estabilizar la red troncal, por lo que EMA solo necesita aplicarse a la cabeza de proyección final, eliminando la necesidad de duplicar la red troncal. Esto reduce el número de parámetros de entrenamiento en aproximadamente un 42 %, lo que lo hace más rápido sin apenas pérdida de rendimiento.
En tercer lugar, el emparejamiento de texto multigranularidad. Durante el entrenamiento, las descripciones web breves, las descripciones de detalle medio y las descripciones largas generadas por Gemini se mezclan aleatoriamente y se introducen en el modelo, alternando entre tareas fáciles y difíciles. Esto evita que el modelo se relaje en las tareas sencillas, al tiempo que garantiza que no se pase por alto ningún detalle.
Los resultados finales son convincentes. TIPSv2 se sometió a una evaluación congelada en nueve tareas y 20 conjuntos de datos de referencia. La segmentación semántica «zero-shot» alcanzó un nuevo punto de referencia en el sector, mientras que la recuperación y clasificación de imagen-texto superó a los modelos de comparación con un 56 % más de parámetros. Las tareas puramente visuales también se situaron entre las de mejor rendimiento.
El código y los pesos del modelo de TIPSv2 son totalmente de código abierto. Para los equipos que trabajan en imágenes médicas, conducción autónoma, inspección industrial y otros ámbitos que exigen una comprensión de imágenes de alta precisión, merece la pena examinar detenidamente esta solución.
Artículo: https://www.alphaxiv.org/abs/2604.12012
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (0)
0/500
Actualmente, la comprensión de imágenes por parte de la IA presenta una limitación fundamental.
Cuando se le pregunta «¿Qué hay en esta imagen?», puede dar una respuesta detallada. Sin embargo, si se le pregunta «¿Dónde está la pata trasera izquierda del panda?», las respuestas son vagas. No se trata de un defecto de ningún modelo concreto, sino de un problema persistente en todo el ámbito de los grandes modelos de lenguaje visual: una sólida comprensión global, pero una localización local deficiente.
Google DeepMind presentó TIPSv2 en su último artículo, diseñado específicamente para abordar este complejo problema.
El equipo de investigación observó un hallazgo contraintuitivo: en tareas de segmentación de alta resolución, los modelos «estudiantes» más pequeños suelen superar a los modelos «profesores» más grandes. Esto ocurre porque la destilación elimina el mecanismo de enmascaramiento, lo que obliga al modelo a aprender cada detalle de toda la imagen, creando una forma de «supervisión de área completa». Motivado por esta idea, TIPSv2 introdujo tres mejoras clave.
En primer lugar, iBOT++. El preentrenamiento tradicional solo calcula la pérdida para las regiones enmascaradas, dejando las áreas visibles en un estado de descuido que provoca la deriva de la semántica local. iBOT++ exige que el modelo proporcione una supervisión precisa sobre todas las áreas visibles, lo que eleva efectivamente la tarea de un «juego de rompecabezas» a «leer atentamente todo el texto». Esta única mejora aumentó el rendimiento de la segmentación sin entrenamiento previo en 14,1 puntos porcentuales.
En segundo lugar, EMA solo para la cabeza. El entrenamiento autosupervisado tradicional requiere mantener en memoria dos modelos grandes casi idénticos, lo que consume muchos recursos. TIPSv2 descubrió que la pérdida contrastiva imagen-texto por sí sola es suficiente para estabilizar la red troncal, por lo que EMA solo necesita aplicarse a la cabeza de proyección final, eliminando la necesidad de duplicar la red troncal. Esto reduce el número de parámetros de entrenamiento en aproximadamente un 42 %, lo que lo hace más rápido sin apenas pérdida de rendimiento.
En tercer lugar, el emparejamiento de texto multigranularidad. Durante el entrenamiento, las descripciones web breves, las descripciones de detalle medio y las descripciones largas generadas por Gemini se mezclan aleatoriamente y se introducen en el modelo, alternando entre tareas fáciles y difíciles. Esto evita que el modelo se relaje en las tareas sencillas, al tiempo que garantiza que no se pase por alto ningún detalle.
Los resultados finales son convincentes. TIPSv2 se sometió a una evaluación congelada en nueve tareas y 20 conjuntos de datos de referencia. La segmentación semántica «zero-shot» alcanzó un nuevo punto de referencia en el sector, mientras que la recuperación y clasificación de imagen-texto superó a los modelos de comparación con un 56 % más de parámetros. Las tareas puramente visuales también se situaron entre las de mejor rendimiento.
El código y los pesos del modelo de TIPSv2 son totalmente de código abierto. Para los equipos que trabajan en imágenes médicas, conducción autónoma, inspección industrial y otros ámbitos que exigen una comprensión de imágenes de alta precisión, merece la pena examinar detenidamente esta solución.
Artículo: https://www.alphaxiv.org/abs/2604.12012








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai












