


 Maison
Google et NVIDIA mettent DiffusionGemma en open source, multipliant par quatre la vitesse d'inférence sur une seule carte
Le 10 juin 2026, Google a lancé DiffusionGemma, un modèle linguistique expérimental open source qui rompt avec le paradigme autorégressif traditionnel consistant à générer du texte mot par mot. Il est le premier à utiliser des mécanismes de diffusion issus de l'IA appliquée à l'image dans la génération de texte, en partant d'un bruit aléatoire et en affinant le résultat de manière itérative pour produire 256 blocs de tokens en parallèle à chaque étape.
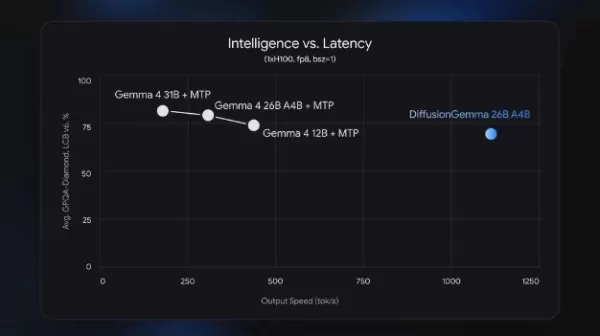
En termes de performances matérielles, les optimisations approfondies de NVIDIA permettent au modèle de fonctionner près de quatre fois plus vite que des modèles traditionnels comparables en mode mono-GPU et mono-utilisateur. Sur un GPU H100, il atteint des vitesses de sortie allant jusqu’à 1 000 tokens par seconde pour une seule requête, et même sur des GPU grand public haut de gamme comme le RTX 5090, il peut dépasser les 700 tokens par seconde.
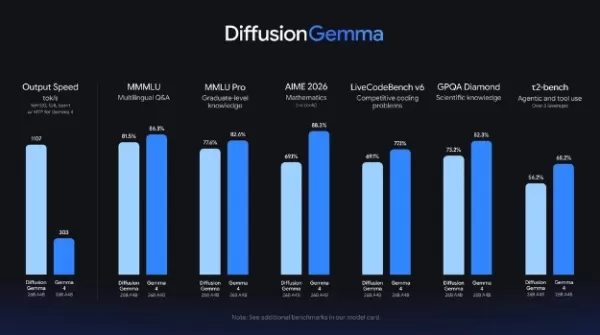
DiffusionGemma compte 26 milliards de paramètres et utilise une architecture de type « mixture-of-experts » (MoE), n’activant que 3,8 milliards de paramètres par étape. Bien que la qualité et la précision de sa génération de texte soient légèrement inférieures à celles des modèles traditionnels de la série Gemma4 sur les benchmarks standard, sa « prise en compte complète des blocs » unique en son genre surmonte la limitation des modèles autorégressifs, qui ne fonctionnent que de manière rétroactive. Comme tous les tokens peuvent se référencer mutuellement pendant la génération, il excelle dans les tâches impliquant des données non linéaires et structurées, telles que la complétion de texte, le remplissage de code, la résolution de Sudoku et le traitement de séquences d’acides aminés.
Les poids du modèle sont désormais disponibles en open source sur Hugging Face sous licence Apache 2.0 et fonctionnent de manière transparente avec les frameworks d’inférence courants tels que vLLM et MLX. Cette exploration élimine non seulement les contraintes de bande passante mémoire pesant sur la puissance de calcul des GPU, mais ouvre également une nouvelle voie technique pour les futures applications d’IA dans le domaine de la logique complexe et de la génération de texte non linéaire.
Article connexe
 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss
Recommandations de sujets spéciaux liés
Éducation et apprentissage
 Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

 commentaires (0)
Le 10 juin 2026, Google a lancé DiffusionGemma, un modèle linguistique expérimental open source qui rompt avec le paradigme autorégressif traditionnel consistant à générer du texte mot par mot. Il est le premier à utiliser des mécanismes de diffusion issus de l'IA appliquée à l'image dans la génération de texte, en partant d'un bruit aléatoire et en affinant le résultat de manière itérative pour produire 256 blocs de tokens en parallèle à chaque étape.
En termes de performances matérielles, les optimisations approfondies de NVIDIA permettent au modèle de fonctionner près de quatre fois plus vite que des modèles traditionnels comparables en mode mono-GPU et mono-utilisateur. Sur un GPU H100, il atteint des vitesses de sortie allant jusqu’à 1 000 tokens par seconde pour une seule requête, et même sur des GPU grand public haut de gamme comme le RTX 5090, il peut dépasser les 700 tokens par seconde.
DiffusionGemma compte 26 milliards de paramètres et utilise une architecture de type « mixture-of-experts » (MoE), n’activant que 3,8 milliards de paramètres par étape. Bien que la qualité et la précision de sa génération de texte soient légèrement inférieures à celles des modèles traditionnels de la série Gemma4 sur les benchmarks standard, sa « prise en compte complète des blocs » unique en son genre surmonte la limitation des modèles autorégressifs, qui ne fonctionnent que de manière rétroactive. Comme tous les tokens peuvent se référencer mutuellement pendant la génération, il excelle dans les tâches impliquant des données non linéaires et structurées, telles que la complétion de texte, le remplissage de code, la résolution de Sudoku et le traitement de séquences d’acides aminés.
Les poids du modèle sont désormais disponibles en open source sur Hugging Face sous licence Apache 2.0 et fonctionnent de manière transparente avec les frameworks d’inférence courants tels que vLLM et MLX. Cette exploration élimine non seulement les contraintes de bande passante mémoire pesant sur la puissance de calcul des GPU, mais ouvre également une nouvelle voie technique pour les futures applications d’IA dans le domaine de la logique complexe et de la génération de texte non linéaire.








 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
 MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
 La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai












