


 Hogar
Google y NVIDIA publican el código fuente de DiffusionGemma, lo que multiplica por cuatro la velocidad de inferencia con una sola tarjeta
El 10 de junio de 2026, Google lanzó DiffusionGemma, un modelo de lenguaje experimental de código abierto que rompe con el paradigma autorregresivo tradicional de generar texto palabra a palabra. Es pionero en el uso de mecanismos de difusión procedentes de la IA aplicada a las imágenes en la generación de texto, partiendo de ruido aleatorio y refinándolo de forma iterativa para generar bloques de 256 tokens en paralelo en cada paso.
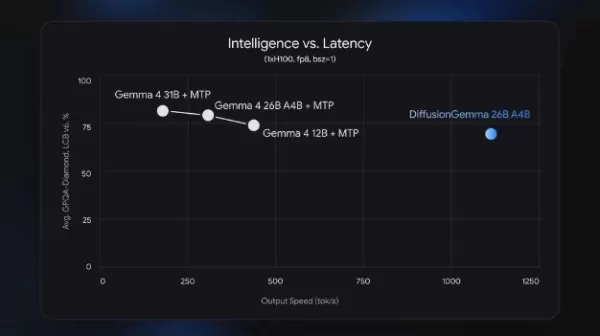
En cuanto al rendimiento del hardware, las profundas optimizaciones de NVIDIA permiten que el modelo funcione casi cuatro veces más rápido que los modelos tradicionales comparables en modo de un solo usuario con una sola GPU. En una GPU H100, alcanza velocidades de salida de hasta 1.000 tokens por segundo para una sola solicitud, e incluso en GPU de consumo de gama alta como la RTX 5090 puede superar los 700 tokens por segundo.
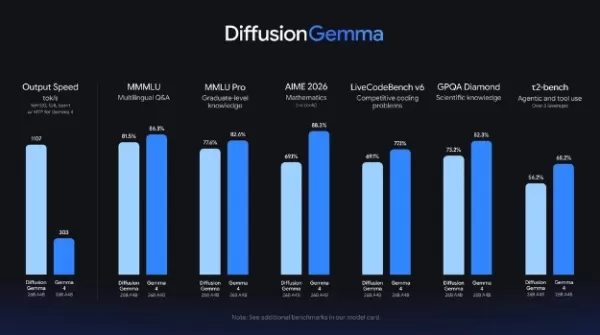
DiffusionGemma cuenta con 26 000 millones de parámetros y utiliza una arquitectura de «mezcla de expertos» (MoE), activando solo 3 800 millones de parámetros por paso. Aunque la calidad y precisión de su generación de texto quedan ligeramente por detrás de los modelos tradicionales de la serie Gemma4 en las pruebas de rendimiento estándar, su exclusiva «conciencia de bloque completo» supera la limitación de los modelos autorregresivos, que solo funcionan hacia atrás. Dado que todos los tokens pueden hacer referencia entre sí durante la generación, destaca en tareas que implican datos no lineales y estructurados, como la finalización de textos, el rellenado de código, la resolución de sudokus y el procesamiento de secuencias de aminoácidos.
Los pesos del modelo son ahora de código abierto en Hugging Face bajo la licencia Apache 2.0 y funcionan a la perfección con marcos de inferencia habituales como vLLM y MLX. Esta investigación no solo elimina las restricciones de ancho de banda de memoria en la potencia de cálculo de la GPU, sino que también abre una nueva vía técnica para futuras aplicaciones de IA en lógica compleja y generación de texto no lineal.
Artículo relacionado
 MiniMax presenta el Programa de Equipo 10x para incentivar a expertos globales en IA
MiniMax (Xiyu Technology), el Laboratorio de Inteligencia Artificial General, ha lanzado oficialmente "10x Team", una iniciativa global de colaboración de talento. Este programa tiene como objetivo reclutar a los mejores expertos de diversas industri
Corea del Sur inicia la construcción del Centro Nacional de Cómputo de IA, invirtiendo 2,5 billones de wones con un objetivo para 2028
El medio surcoreano EtNews informa que la ceremonia de colocación de la primera piedra del Centro de Cómputo de IA de Corea (KOACC) se llevó a cabo el 3 de agosto en el parque de centros de datos Solar City, en Sunan, Jeollanam-do. Con una inversión
Seis gigantes tecnológicos respaldan a la Linux Foundation con 12,5 millones de dólares para abordar el ruido de las vulnerabilidades de la inteligencia artificial
Para hacer frente a la avalancha de informes de seguridad de baja calidad generados por herramientas de automatización de IA, seis grandes empresas tecnológicas—Anthropic, Amazon (AWS), GitHub, Google, Microsoft y OpenAI—han contribuido conjuntamente
Recomendaciones de temas especiales relacionados
composicion musical
 Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
 9 herramientas
 xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai
Educación y aprendizaje
Plataformas de construcción de cuestionarios con IA para profesores, tutores y programas de aprendizaje basados en cohortes
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai
código
Herramientas de revisión de pull requests basadas en IA para equipos de GitHub que se ocupan de refactorizaciones, errores y fallos de seguridad
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai

 comentario (0)
0/500
El 10 de junio de 2026, Google lanzó DiffusionGemma, un modelo de lenguaje experimental de código abierto que rompe con el paradigma autorregresivo tradicional de generar texto palabra a palabra. Es pionero en el uso de mecanismos de difusión procedentes de la IA aplicada a las imágenes en la generación de texto, partiendo de ruido aleatorio y refinándolo de forma iterativa para generar bloques de 256 tokens en paralelo en cada paso.
En cuanto al rendimiento del hardware, las profundas optimizaciones de NVIDIA permiten que el modelo funcione casi cuatro veces más rápido que los modelos tradicionales comparables en modo de un solo usuario con una sola GPU. En una GPU H100, alcanza velocidades de salida de hasta 1.000 tokens por segundo para una sola solicitud, e incluso en GPU de consumo de gama alta como la RTX 5090 puede superar los 700 tokens por segundo.
DiffusionGemma cuenta con 26 000 millones de parámetros y utiliza una arquitectura de «mezcla de expertos» (MoE), activando solo 3 800 millones de parámetros por paso. Aunque la calidad y precisión de su generación de texto quedan ligeramente por detrás de los modelos tradicionales de la serie Gemma4 en las pruebas de rendimiento estándar, su exclusiva «conciencia de bloque completo» supera la limitación de los modelos autorregresivos, que solo funcionan hacia atrás. Dado que todos los tokens pueden hacer referencia entre sí durante la generación, destaca en tareas que implican datos no lineales y estructurados, como la finalización de textos, el rellenado de código, la resolución de sudokus y el procesamiento de secuencias de aminoácidos.
Los pesos del modelo son ahora de código abierto en Hugging Face bajo la licencia Apache 2.0 y funcionan a la perfección con marcos de inferencia habituales como vLLM y MLX. Esta investigación no solo elimina las restricciones de ancho de banda de memoria en la potencia de cálculo de la GPU, sino que también abre una nueva vía técnica para futuras aplicaciones de IA en lógica compleja y generación de texto no lineal.








 MiniMax presenta el Programa de Equipo 10x para incentivar a expertos globales en IA
MiniMax (Xiyu Technology), el Laboratorio de Inteligencia Artificial General, ha lanzado oficialmente "10x Team", una iniciativa global de colaboración de talento. Este programa tiene como objetivo reclutar a los mejores expertos de diversas industri
 Corea del Sur inicia la construcción del Centro Nacional de Cómputo de IA, invirtiendo 2,5 billones de wones con un objetivo para 2028
El medio surcoreano EtNews informa que la ceremonia de colocación de la primera piedra del Centro de Cómputo de IA de Corea (KOACC) se llevó a cabo el 3 de agosto en el parque de centros de datos Solar City, en Sunan, Jeollanam-do. Con una inversión
 Seis gigantes tecnológicos respaldan a la Linux Foundation con 12,5 millones de dólares para abordar el ruido de las vulnerabilidades de la inteligencia artificial
Para hacer frente a la avalancha de informes de seguridad de baja calidad generados por herramientas de automatización de IA, seis grandes empresas tecnológicas—Anthropic, Amazon (AWS), GitHub, Google, Microsoft y OpenAI—han contribuido conjuntamente

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai












