


 Heim
Google und NVIDIA veröffentlichen „DiffusionGemma“ als Open-Source-Projekt und beschleunigen die Inferenz auf einer einzelnen Grafikkarte um das Vierfache
Am 10. Juni 2026 stellte Google „DiffusionGemma“ vor, ein experimentelles Open-Source-Sprachmodell, das mit dem traditionellen autoregressiven Paradigma bricht, bei dem Text Wort für Wort generiert wird. Es leistet Pionierarbeit bei der Nutzung von Diffusionsmechanismen aus der Bild-KI zur Textgenerierung, wobei es von zufälligem Rauschen ausgeht und iterativ verfeinert wird, um pro Schritt 256 Token-Blöcke parallel auszugeben.
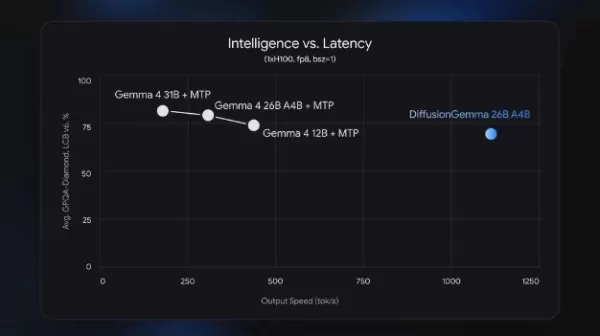
Was die Hardware-Leistung angeht, ermöglichen die tiefgreifenden Optimierungen von NVIDIA, dass das Modell im Single-GPU-Einzelbenutzermodus fast viermal schneller läuft als vergleichbare traditionelle Modelle. Auf einer H100-GPU erreicht es Ausgabegeschwindigkeiten von bis zu 1.000 Token pro Sekunde für eine einzelne Anfrage, und selbst auf High-End-GPUs für Endverbraucher wie der RTX 5090 kann es 700 Token pro Sekunde überschreiten.
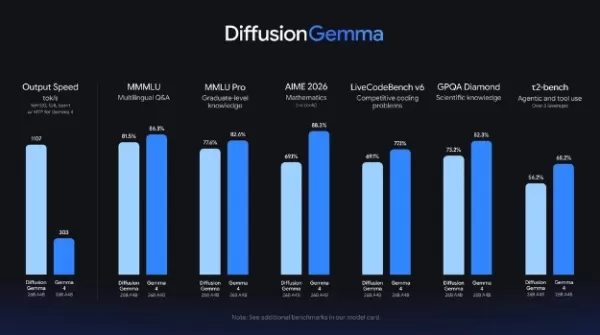
DiffusionGemma verfügt über 26 Milliarden Parameter und nutzt eine „Mixture-of-Experts“-Architektur (MoE), bei der pro Schritt nur 3,8 Milliarden Parameter aktiviert werden. Zwar bleiben die Qualität und Genauigkeit der Textgenerierung bei Standard-Benchmarks leicht hinter den traditionellen Modellen der Gemma-4-Serie zurück, doch überwindet ihr einzigartiges „Full-Block-Awareness“ die Beschränkung autoregressiver Modelle auf rückwärtsgerichtete Verarbeitung. Da sich alle Token während der Generierung gegenseitig referenzieren können, zeichnet es sich bei Aufgaben mit nichtlinearen und strukturierten Daten aus, wie beispielsweise Textvervollständigung, Code-Auffüllung, Sudoku-Lösung und Verarbeitung von Aminosäuresequenzen.
Die Modellgewichte sind nun auf Hugging Face unter der Apache-2.0-Lizenz als Open Source verfügbar und lassen sich nahtlos mit gängigen Inferenz-Frameworks wie vLLM und MLX nutzen. Diese Entwicklung beseitigt nicht nur Speicherbandbreitenbeschränkungen bei der GPU-Rechenleistung, sondern eröffnet auch einen neuen technischen Weg für zukünftige KI-Anwendungen im Bereich komplexer Logik und nichtlinearer Textgenerierung.
Verwandter Artikel
 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
Am 10. Juni 2026 stellte Google „DiffusionGemma“ vor, ein experimentelles Open-Source-Sprachmodell, das mit dem traditionellen autoregressiven Paradigma bricht, bei dem Text Wort für Wort generiert wird. Es leistet Pionierarbeit bei der Nutzung von Diffusionsmechanismen aus der Bild-KI zur Textgenerierung, wobei es von zufälligem Rauschen ausgeht und iterativ verfeinert wird, um pro Schritt 256 Token-Blöcke parallel auszugeben.
Was die Hardware-Leistung angeht, ermöglichen die tiefgreifenden Optimierungen von NVIDIA, dass das Modell im Single-GPU-Einzelbenutzermodus fast viermal schneller läuft als vergleichbare traditionelle Modelle. Auf einer H100-GPU erreicht es Ausgabegeschwindigkeiten von bis zu 1.000 Token pro Sekunde für eine einzelne Anfrage, und selbst auf High-End-GPUs für Endverbraucher wie der RTX 5090 kann es 700 Token pro Sekunde überschreiten.
DiffusionGemma verfügt über 26 Milliarden Parameter und nutzt eine „Mixture-of-Experts“-Architektur (MoE), bei der pro Schritt nur 3,8 Milliarden Parameter aktiviert werden. Zwar bleiben die Qualität und Genauigkeit der Textgenerierung bei Standard-Benchmarks leicht hinter den traditionellen Modellen der Gemma-4-Serie zurück, doch überwindet ihr einzigartiges „Full-Block-Awareness“ die Beschränkung autoregressiver Modelle auf rückwärtsgerichtete Verarbeitung. Da sich alle Token während der Generierung gegenseitig referenzieren können, zeichnet es sich bei Aufgaben mit nichtlinearen und strukturierten Daten aus, wie beispielsweise Textvervollständigung, Code-Auffüllung, Sudoku-Lösung und Verarbeitung von Aminosäuresequenzen.
Die Modellgewichte sind nun auf Hugging Face unter der Apache-2.0-Lizenz als Open Source verfügbar und lassen sich nahtlos mit gängigen Inferenz-Frameworks wie vLLM und MLX nutzen. Diese Entwicklung beseitigt nicht nur Speicherbandbreitenbeschränkungen bei der GPU-Rechenleistung, sondern eröffnet auch einen neuen technischen Weg für zukünftige KI-Anwendungen im Bereich komplexer Logik und nichtlinearer Textgenerierung.








 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
 Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
 Sechs Tech-Giganten unterstützen die Linux Foundation mit 12,5 Millionen US-Dollar, um das Rauschen bei KI-Schwachstellen zu bekämpfen
Um der Flut von Sicherheitsberichten niedriger Qualität, die durch KI-Automatisierungstools erzeugt werden, zu begegnen, haben sechs große Technologieunternehmen – Anthropic, Amazon (AWS), GitHub, Google, Microsoft und OpenAI – gemeinsam 12,5 Million

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












