


 首页
萨蒂亚·纳德拉向使用人工智能的企业发出严厉警告
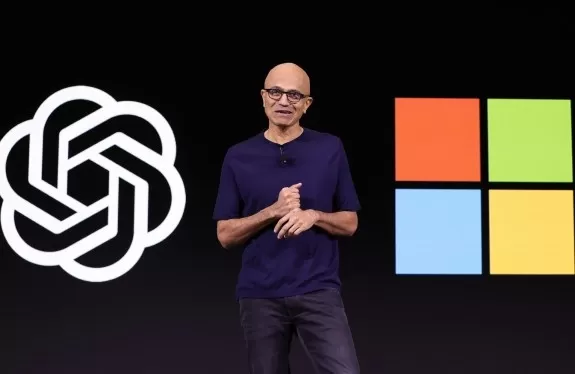
在围绕人工智能潜在弊端的诸多争论中,有一点让硅谷的人工智能爱好者们尤为担忧:那些出售专有模型的主要人工智能实验室,其运作方式可能如同“特洛伊木马”。
人们担心的是,随着初创企业和大型企业采用OpenAI和Anthropic等实验室的人工智能模型,这些实验室将获得越来越多访问企业最敏感商业数据的权限。 模型开发商随后可能会利用这些信息谋取私利,甚至可能转变为自身客户的竞争对手。从风险投资家杰森·卡拉卡尼斯(Jason Calacanis)到Palantir首席执行官亚历克斯·卡普(Alex Karp),各界人士都对这一风险发出了警告。
如今,微软首席执行官萨蒂亚·纳德拉(Satya Nadella)在周一发布的一篇令人意外的博客文章中也加入了这一讨论。纳德拉警告称,AI用户——他称之为“买家”——实际上是在“双重付费”。他们明知要为AI令牌的使用付费,但在这一过程中,却也在不知不觉中交出了宝贵的数据。
“你实际上为智能付出了双重代价:一次是用金钱,另一次则是用更宝贵的东西——为了让这种智能发挥作用而必须披露的专有知识。你越希望模型表现得更好,就必须向它输入更多的知识!”他在文中写道。
他认为,最危险的是,企业实际上是在向模型传授自身业务的细微差别。
“模型从‘废气’中学习——即人们编写的提示词、代理使用的工具,尤其是当模型出错时人们所做的更正。每一次更正都被提炼成机构专有知识,”他写道。
这是“竞争对手永远无法买到的知识”,然而企业却在将其拱手相让。
纳德拉认为,如果允许人工智能公司自由抓取互联网数据来训练其模型,那么企业作为回报,研究——或者说“提炼”——这些模型也是公平的。 所谓“蒸馏”,是指利用模型自身的输出结果来理解其工作原理,并基于这些洞察训练出一个新的、通常成本更低的模型。今年2月,Anthropic公司指控中国开源模型向Claude发送了数百万条提示词以改进其自身模型,并敦促美国政府收紧出口管制。
纳德拉的观点是,模型开发者不能两头得利。他们一边自由地利用全球数据进行训练,一边却限制他人对他们的模型做同样的事情,这是虚伪的。
“虽然模型提供商拥有在公开数据上训练模型的合理使用权这一伟大创新是必要的,但我认为,现状却反过来对模型蒸馏施加限制性条款,这颇具讽刺意味,”这位微软首席执行官写道。
纳德拉特别关注的是,模型制造商“保留从客户使用和交互数据中学习的权利”。
纳德拉提出的解决方案,正是大型云服务提供商首席执行官会提出的建议。他希望企业能够“保留”对其数据的所有权,包括提示词、反馈等。 因此,他敦促企业在其云端构建自己的“专有学习环境”——毕竟这些数据很可能本就存储在云端,而巧合的是,这可能意味着微软的云平台Azure。 他还建议企业部署他所谓的“编排层”——本质上是一种在不同供应商的AI模型之间轻松切换的方式,而非被锁定在单一供应商的模型上。能够实现这一功能的AI“网关”等工具正变得越来越流行。
尽管纳德拉从未将“开源”一词作为保留所有权的方法,但这显然是其言外之意。然而,还有另一层隐含含义。
许多大型企业除了使用云服务外,仍运营着自己的数据中心,它们已经开始转向在自有场所(行业术语称为“本地部署”)安装开源模型。 Solo.io的创始人兼首席执行官伊迪特·莱文(Idit Levine)表示,她正在自己的客户中观察到这种转变。该公司开发网络和安全软件,旨在帮助企业管理AI系统。 “在尝试过专有模型构建工具后,他们开始询问:‘我能否将开源模型部署在本地运行?它能实现大型供应商功能近90%,成本却低得多。’”她向TechCrunch透露,“他们明白这一点,而且能够掌控它。”
去年,Solo.io的技术被选为Linux基金会Agentgateway项目的核心技术。她的公司客户包括T-Mobile、ADP和SAP等企业。她观察到越来越多的企业开始部署本地化的开源模型,并认为这将是企业AI应用领域的下一波浪潮。
持这种观点的不仅她一人。Vercel——这家以构建和托管网站平台而闻名、近期新增了AI模型切换工具的公司——以及OpenRouter(一家帮助开发者将请求路由到不同AI模型的公司)——都观察到流向开源模型的流量激增。 事实上,上个月通过Vercel网关路由的全部流量中,开源模型占比达29%。
鉴于微软(该公司曾投资 OpenAI 和 Anthropic)的首席执行官如今公开呼吁企业谨慎使用专有模型,我们预计这一趋势将持续增长。“在利用智能的同时,你也在创造智能。而你所创造的,理应归你所有,”纳德拉写道。
相关文章
 美国因知识产权问题对中国人工智能公司实施制裁
周二,美国财政部长斯科特·贝森特宣布,美国政府将审查来自中国的大语言模型,以排查潜在的知识产权盗窃行为,并警告称,若确认存在此类违规行为,将对中国的AI企业实施制裁。“我们听到了很多关于开源模型兴起并对美国的大语言模型构成威胁的讨论,”贝森特周二在福克斯商业频道表示。“本届政府支持开源模型,但我们不支持知识产权盗窃。如果我们发现,尤其是海外模型正在窃取我们优秀企业的成果,我们有权因这种盗窃行为对其进行制裁。”贝森特的言论最初由彭博社报道。此番表态之际,中国模型——最近的是月之暗面(Moon
微软淘汰失败的 AI 工具并整合 Copilot 应用
两年前,微软将人工智能定义为一种“代际性”的技术变革,并表示其旨在引领这一趋势。如今,该公司正在整合其以 Copilot 为品牌的消费者和企业应用,同时停止运行不佳的几项人工智能功能。正如 GeekWire 首次报道并在微软的支持文档中详细说明的那样,这家科技巨头将把其面向消费者的 Copilot 应用的功能与专注于企业的 Microsoft 365 Copilot 应用的功能合并。此举承认个人和企业人工智能使用往往存在重叠,且微软之前的策略过于复杂,导致 Copilot 无法成为 Chat
据称微软培训销售人员以压低竞争对手 OpenAI 和 Anthropic 的价格
微软据报正在加强其销售团队,以加大对人工智能领域主要竞争对手的竞争力度。据彭博社报道,高管们于周二举行了一次内部战略会议,指示销售团队突出微软的人工智能产品相较于 OpenAI、Google 和 Anthropic 产品的优势。此次会议聚焦于 27 财年的规划,强调在推销微软专有模型时,应着重阐述其相较于竞争对手解决方案在效率和成本方面的优势。“其他公司都在销售零部件——而我们销售的是完整的端到端系统。这就是我们在 27 财年需要向外界传达的故事,”据报道,执行副总裁 Jay Parikh
相关专题推荐
数据分析
 适用于 SaaS 和电商团队的 KPI 监控最佳 AI 异常检测工具
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
 10 个工具
 xix.ai
写作
最适合撰写长篇SEO文章的AI大纲生成器
2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai
教育与学习
用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

 评论 (0)
0/500
在围绕人工智能潜在弊端的诸多争论中,有一点让硅谷的人工智能爱好者们尤为担忧:那些出售专有模型的主要人工智能实验室,其运作方式可能如同“特洛伊木马”。
人们担心的是,随着初创企业和大型企业采用OpenAI和Anthropic等实验室的人工智能模型,这些实验室将获得越来越多访问企业最敏感商业数据的权限。 模型开发商随后可能会利用这些信息谋取私利,甚至可能转变为自身客户的竞争对手。从风险投资家杰森·卡拉卡尼斯(Jason Calacanis)到Palantir首席执行官亚历克斯·卡普(Alex Karp),各界人士都对这一风险发出了警告。
如今,微软首席执行官萨蒂亚·纳德拉(Satya Nadella)在周一发布的一篇令人意外的博客文章中也加入了这一讨论。纳德拉警告称,AI用户——他称之为“买家”——实际上是在“双重付费”。他们明知要为AI令牌的使用付费,但在这一过程中,却也在不知不觉中交出了宝贵的数据。
“你实际上为智能付出了双重代价:一次是用金钱,另一次则是用更宝贵的东西——为了让这种智能发挥作用而必须披露的专有知识。你越希望模型表现得更好,就必须向它输入更多的知识!”他在文中写道。
他认为,最危险的是,企业实际上是在向模型传授自身业务的细微差别。
“模型从‘废气’中学习——即人们编写的提示词、代理使用的工具,尤其是当模型出错时人们所做的更正。每一次更正都被提炼成机构专有知识,”他写道。
这是“竞争对手永远无法买到的知识”,然而企业却在将其拱手相让。
纳德拉认为,如果允许人工智能公司自由抓取互联网数据来训练其模型,那么企业作为回报,研究——或者说“提炼”——这些模型也是公平的。 所谓“蒸馏”,是指利用模型自身的输出结果来理解其工作原理,并基于这些洞察训练出一个新的、通常成本更低的模型。今年2月,Anthropic公司指控中国开源模型向Claude发送了数百万条提示词以改进其自身模型,并敦促美国政府收紧出口管制。
纳德拉的观点是,模型开发者不能两头得利。他们一边自由地利用全球数据进行训练,一边却限制他人对他们的模型做同样的事情,这是虚伪的。
“虽然模型提供商拥有在公开数据上训练模型的合理使用权这一伟大创新是必要的,但我认为,现状却反过来对模型蒸馏施加限制性条款,这颇具讽刺意味,”这位微软首席执行官写道。
纳德拉特别关注的是,模型制造商“保留从客户使用和交互数据中学习的权利”。
纳德拉提出的解决方案,正是大型云服务提供商首席执行官会提出的建议。他希望企业能够“保留”对其数据的所有权,包括提示词、反馈等。 因此,他敦促企业在其云端构建自己的“专有学习环境”——毕竟这些数据很可能本就存储在云端,而巧合的是,这可能意味着微软的云平台Azure。 他还建议企业部署他所谓的“编排层”——本质上是一种在不同供应商的AI模型之间轻松切换的方式,而非被锁定在单一供应商的模型上。能够实现这一功能的AI“网关”等工具正变得越来越流行。
尽管纳德拉从未将“开源”一词作为保留所有权的方法,但这显然是其言外之意。然而,还有另一层隐含含义。
许多大型企业除了使用云服务外,仍运营着自己的数据中心,它们已经开始转向在自有场所(行业术语称为“本地部署”)安装开源模型。 Solo.io的创始人兼首席执行官伊迪特·莱文(Idit Levine)表示,她正在自己的客户中观察到这种转变。该公司开发网络和安全软件,旨在帮助企业管理AI系统。 “在尝试过专有模型构建工具后,他们开始询问:‘我能否将开源模型部署在本地运行?它能实现大型供应商功能近90%,成本却低得多。’”她向TechCrunch透露,“他们明白这一点,而且能够掌控它。”
去年,Solo.io的技术被选为Linux基金会Agentgateway项目的核心技术。她的公司客户包括T-Mobile、ADP和SAP等企业。她观察到越来越多的企业开始部署本地化的开源模型,并认为这将是企业AI应用领域的下一波浪潮。
持这种观点的不仅她一人。Vercel——这家以构建和托管网站平台而闻名、近期新增了AI模型切换工具的公司——以及OpenRouter(一家帮助开发者将请求路由到不同AI模型的公司)——都观察到流向开源模型的流量激增。 事实上,上个月通过Vercel网关路由的全部流量中,开源模型占比达29%。
鉴于微软(该公司曾投资 OpenAI 和 Anthropic)的首席执行官如今公开呼吁企业谨慎使用专有模型,我们预计这一趋势将持续增长。“在利用智能的同时,你也在创造智能。而你所创造的,理应归你所有,”纳德拉写道。








 美国因知识产权问题对中国人工智能公司实施制裁
周二,美国财政部长斯科特·贝森特宣布,美国政府将审查来自中国的大语言模型,以排查潜在的知识产权盗窃行为,并警告称,若确认存在此类违规行为,将对中国的AI企业实施制裁。“我们听到了很多关于开源模型兴起并对美国的大语言模型构成威胁的讨论,”贝森特周二在福克斯商业频道表示。“本届政府支持开源模型,但我们不支持知识产权盗窃。如果我们发现,尤其是海外模型正在窃取我们优秀企业的成果,我们有权因这种盗窃行为对其进行制裁。”贝森特的言论最初由彭博社报道。此番表态之际,中国模型——最近的是月之暗面(Moon
 微软淘汰失败的 AI 工具并整合 Copilot 应用
两年前,微软将人工智能定义为一种“代际性”的技术变革,并表示其旨在引领这一趋势。如今,该公司正在整合其以 Copilot 为品牌的消费者和企业应用,同时停止运行不佳的几项人工智能功能。正如 GeekWire 首次报道并在微软的支持文档中详细说明的那样,这家科技巨头将把其面向消费者的 Copilot 应用的功能与专注于企业的 Microsoft 365 Copilot 应用的功能合并。此举承认个人和企业人工智能使用往往存在重叠,且微软之前的策略过于复杂,导致 Copilot 无法成为 Chat
 据称微软培训销售人员以压低竞争对手 OpenAI 和 Anthropic 的价格
微软据报正在加强其销售团队,以加大对人工智能领域主要竞争对手的竞争力度。据彭博社报道,高管们于周二举行了一次内部战略会议,指示销售团队突出微软的人工智能产品相较于 OpenAI、Google 和 Anthropic 产品的优势。此次会议聚焦于 27 财年的规划,强调在推销微软专有模型时,应着重阐述其相较于竞争对手解决方案在效率和成本方面的优势。“其他公司都在销售零部件——而我们销售的是完整的端到端系统。这就是我们在 27 财年需要向外界传达的故事,”据报道,执行副总裁 Jay Parikh
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai












