


 Дом
Сатья Наделла выступил с резким предупреждением в адрес компаний, использующих ИИ
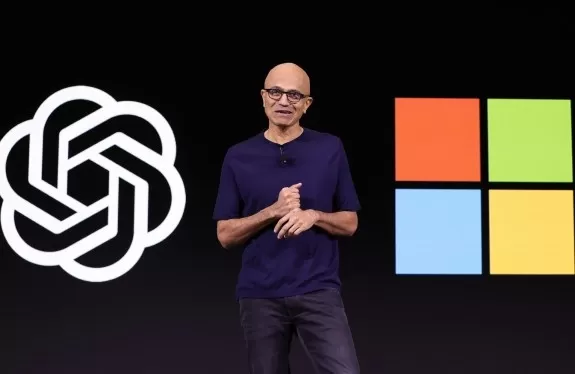
Среди многочисленных дискуссий, посвященных потенциальным недостаткам ИИ, одна проблема вызывает особую тревогу у энтузиастов ИИ из Кремниевой долины: опасение, что крупные лаборатории по разработке ИИ, продающие проприетарные модели, могут действовать как «троянские кони».
Существует опасение, что по мере того, как стартапы и крупные компании внедряют модели ИИ от таких лабораторий, как OpenAI и Anthropic, эти лаборатории получают все более широкий доступ к наиболее конфиденциальным бизнес-данным компаний. Затем разработчики моделей могут использовать эти знания в своих интересах, потенциально превратившись в конкурентов своих собственных клиентов. Предупреждения об этом риске звучат от самых разных людей — от венчурного инвестора Джейсона Калаканиса до генерального директора Palantir Алекса Карпа.
Теперь, в неожиданном посте в блоге, опубликованном в понедельник, к ним присоединился генеральный директор Microsoft Сатья Наделла. Наделла предупреждает, что пользователи ИИ — которых он называет «покупателями» — платят дважды. Они сознательно платят за использование токенов ИИ, но при этом неосознанно передают ценные данные.
«По сути, вы платите за интеллект дважды: один раз деньгами, а второй — чем-то еще более ценным: собственными знаниями, которые вы вынуждены раскрывать, чтобы этот интеллект стал полезным. Чем лучше вы хотите, чтобы модель работала, тем больше таких знаний вам приходится ей предоставлять!» — пишет он.
Самое опасное, по его мнению, заключается в том, что предприятия, по сути, обучают модели нюансам своего собственного бизнеса.
«Модели учатся на „выходных данных“ — подсказках, которые пишут люди, инструментах, которыми пользуются сотрудники, и особенно на исправлениях, которые люди вносят, когда модель ошибается. Каждое исправление становится частью корпоративного ноу-хау», — пишет он.
Это «тот вид знаний, который конкурент никогда не сможет купить», и тем не менее предприятия отдают его просто так.
Наделла утверждает, что если компаниям, занимающимся ИИ, разрешено свободно собирать данные из Интернета для обучения своих моделей, то вполне справедливо, чтобы предприятия в свою очередь могли изучать — или «дистиллировать» — эти модели. Под «дистилляцией» подразумевается использование собственных результатов модели для понимания принципа её работы и обучения новой, зачастую более дешёвой модели на основе полученных знаний. В феврале компания Anthropic обвинила китайские модели с открытым исходным кодом в отправке миллионов запросов в Claude с целью улучшения своих собственных моделей, призвав правительство США ужесточить экспортный контроль.
Наделла считает, что разработчики моделей не могут иметь всё и сразу. С их стороны лицемерно свободно обучать модели на данных со всего мира, одновременно ограничивая других в том, чтобы те делали то же самое с их моделями.
«Хотя великие инновации, возникающие благодаря тому, что поставщики моделей обладают правами добросовестного использования для обучения моделей на публичных данных, необходимы, я считаю ироничным, что в нынешней ситуации они затем разворачиваются и навязывают ограничительные условия на дистилляцию», — пишет генеральный директор Microsoft.
Наделла особенно обеспокоен тем, что разработчики моделей «оставляют за собой право извлекать знания из данных об использовании и взаимодействии клиентов».
Решение, предложенное Наделлой, вполне соответствует тому, что мог бы предложить генеральный директор крупного поставщика облачных услуг. Он хочет, чтобы компании «сохраняли право собственности» на свои данные, включая запросы, отзывы и прочее. Поэтому он призывает их создавать собственные «проприетарные среды обучения» в облаке — где их данные, скорее всего, и так уже хранятся, и, что удобно, это может означать облако Microsoft — Azure. Он также рекомендует компаниям внедрять то, что он называет «уровнями оркестрации» — по сути, способ легко переключаться между моделями ИИ от разных поставщиков, а не быть привязанными к одной. Такие инструменты, как «шлюзы» ИИ, которые позволяют делать именно это, становятся все более популярными.
Хотя Наделла никогда не употребляет слово «открытый исходный код» в качестве метода сохранения прав собственности, это является очевидным подтекстом. Однако есть и другой подтекст.
Крупные компании, многие из которых по-прежнему эксплуатируют собственные центры обработки данных в дополнение к использованию облачных сервисов, уже переходят на модели с открытым исходным кодом, устанавливаемые на своих площадях («on-prem» на отраслевом жаргоне). Идит Левин, основательница и генеральный директор Solo.io — компании, разрабатывающей сетевое и защитное программное обеспечение, помогающее предприятиям управлять системами искусственного интеллекта, — говорит, что наблюдает именно такой сдвиг у своих клиентов. Поэкспериментировав с провайдерами проприетарных моделей, они начинают спрашивать: «Могу ли я взять модель с открытым исходным кодом и запустить её локально? Она будет выполнять почти 90 % того, что делает крупный провайдер. И это будет стоить гораздо дешевле», — рассказывает она TechCrunch. «Они это понимают и могут контролировать процесс».
В прошлом году технология Solo.io была выбрана в качестве основы для проекта Agentgateway, реализуемого Linux Foundation. Среди клиентов её компании — такие предприятия, как T-Mobile, ADP и SAP. Она наблюдает, как компании всё чаще внедряют локальные модели с открытым исходным кодом, и считает это следующей большой волной в использовании ИИ на предприятиях.
Она не одинока в этом мнении. Vercel — наиболее известная как платформа для создания и хостинга веб-сайтов, которая недавно добавила инструменты для переключения моделей ИИ — и OpenRouter, компания, помогающая разработчикам маршрутизировать запросы между различными моделями ИИ, — обе отмечают резкий рост трафика к моделям с открытым исходным кодом. Фактически, в прошлом месяце на долю открытых моделей пришлось 29 % всего трафика, проходящего через шлюз Vercel.
Учитывая, что генеральный директор Microsoft — компании, инвестировавшей как в OpenAI, так и в Anthropic, — теперь открыто призывает предприятия проявлять осторожность при использовании проприетарных моделей, мы ожидаем, что эта тенденция будет только усиливаться. «Используя интеллект, вы создаете интеллект. И то, что вы создаете, должно принадлежать вам», — пишет Наделла.
Связанная статья
 США вводят санкции против китайских ИИ-компаний из-за проблем с интеллектуальной собственностью
Во вторник министр финансов США Скотт Бессент объявил, что правительство Соединенных Штатов будет тщательно проверять открытые модели из Китая на предмет потенциального кражи интеллектуальной собственности, предупредив о санкциях против китайских ИИ-
Microsoft выводит из эксплуатации неудачные инструменты на базе искусственного интеллекта и объединяет приложения Copilot
Два года назад Microsoft охарактеризовала искусственный интеллект как «технологический сдвиг поколения», которым компания намерена руководить. Сегодня корпорация консолидирует свои потребительские и бизнес-приложения под брендом Copilot, одновременно
По сообщениям, Microsoft обучает своих сотрудников по продажам занижать цены по сравнению с конкурентами OpenAI и Anthropic
По сообщениям, Microsoft готовит свои отделы продаж для усиления конкуренции с ключевыми соперниками в сфере искусственного интеллекта.Согласно отчету Bloomberg, во вторник руководители провели внутреннее стратегическое совещание, на котором поручил
Рекомендации по связанным специальным темам
Анализ данных
 Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
 10 инструментов
 xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

 Комментарии (0)
Среди многочисленных дискуссий, посвященных потенциальным недостаткам ИИ, одна проблема вызывает особую тревогу у энтузиастов ИИ из Кремниевой долины: опасение, что крупные лаборатории по разработке ИИ, продающие проприетарные модели, могут действовать как «троянские кони».
Существует опасение, что по мере того, как стартапы и крупные компании внедряют модели ИИ от таких лабораторий, как OpenAI и Anthropic, эти лаборатории получают все более широкий доступ к наиболее конфиденциальным бизнес-данным компаний. Затем разработчики моделей могут использовать эти знания в своих интересах, потенциально превратившись в конкурентов своих собственных клиентов. Предупреждения об этом риске звучат от самых разных людей — от венчурного инвестора Джейсона Калаканиса до генерального директора Palantir Алекса Карпа.
Теперь, в неожиданном посте в блоге, опубликованном в понедельник, к ним присоединился генеральный директор Microsoft Сатья Наделла. Наделла предупреждает, что пользователи ИИ — которых он называет «покупателями» — платят дважды. Они сознательно платят за использование токенов ИИ, но при этом неосознанно передают ценные данные.
«По сути, вы платите за интеллект дважды: один раз деньгами, а второй — чем-то еще более ценным: собственными знаниями, которые вы вынуждены раскрывать, чтобы этот интеллект стал полезным. Чем лучше вы хотите, чтобы модель работала, тем больше таких знаний вам приходится ей предоставлять!» — пишет он.
Самое опасное, по его мнению, заключается в том, что предприятия, по сути, обучают модели нюансам своего собственного бизнеса.
«Модели учатся на „выходных данных“ — подсказках, которые пишут люди, инструментах, которыми пользуются сотрудники, и особенно на исправлениях, которые люди вносят, когда модель ошибается. Каждое исправление становится частью корпоративного ноу-хау», — пишет он.
Это «тот вид знаний, который конкурент никогда не сможет купить», и тем не менее предприятия отдают его просто так.
Наделла утверждает, что если компаниям, занимающимся ИИ, разрешено свободно собирать данные из Интернета для обучения своих моделей, то вполне справедливо, чтобы предприятия в свою очередь могли изучать — или «дистиллировать» — эти модели. Под «дистилляцией» подразумевается использование собственных результатов модели для понимания принципа её работы и обучения новой, зачастую более дешёвой модели на основе полученных знаний. В феврале компания Anthropic обвинила китайские модели с открытым исходным кодом в отправке миллионов запросов в Claude с целью улучшения своих собственных моделей, призвав правительство США ужесточить экспортный контроль.
Наделла считает, что разработчики моделей не могут иметь всё и сразу. С их стороны лицемерно свободно обучать модели на данных со всего мира, одновременно ограничивая других в том, чтобы те делали то же самое с их моделями.
«Хотя великие инновации, возникающие благодаря тому, что поставщики моделей обладают правами добросовестного использования для обучения моделей на публичных данных, необходимы, я считаю ироничным, что в нынешней ситуации они затем разворачиваются и навязывают ограничительные условия на дистилляцию», — пишет генеральный директор Microsoft.
Наделла особенно обеспокоен тем, что разработчики моделей «оставляют за собой право извлекать знания из данных об использовании и взаимодействии клиентов».
Решение, предложенное Наделлой, вполне соответствует тому, что мог бы предложить генеральный директор крупного поставщика облачных услуг. Он хочет, чтобы компании «сохраняли право собственности» на свои данные, включая запросы, отзывы и прочее. Поэтому он призывает их создавать собственные «проприетарные среды обучения» в облаке — где их данные, скорее всего, и так уже хранятся, и, что удобно, это может означать облако Microsoft — Azure. Он также рекомендует компаниям внедрять то, что он называет «уровнями оркестрации» — по сути, способ легко переключаться между моделями ИИ от разных поставщиков, а не быть привязанными к одной. Такие инструменты, как «шлюзы» ИИ, которые позволяют делать именно это, становятся все более популярными.
Хотя Наделла никогда не употребляет слово «открытый исходный код» в качестве метода сохранения прав собственности, это является очевидным подтекстом. Однако есть и другой подтекст.
Крупные компании, многие из которых по-прежнему эксплуатируют собственные центры обработки данных в дополнение к использованию облачных сервисов, уже переходят на модели с открытым исходным кодом, устанавливаемые на своих площадях («on-prem» на отраслевом жаргоне). Идит Левин, основательница и генеральный директор Solo.io — компании, разрабатывающей сетевое и защитное программное обеспечение, помогающее предприятиям управлять системами искусственного интеллекта, — говорит, что наблюдает именно такой сдвиг у своих клиентов. Поэкспериментировав с провайдерами проприетарных моделей, они начинают спрашивать: «Могу ли я взять модель с открытым исходным кодом и запустить её локально? Она будет выполнять почти 90 % того, что делает крупный провайдер. И это будет стоить гораздо дешевле», — рассказывает она TechCrunch. «Они это понимают и могут контролировать процесс».
В прошлом году технология Solo.io была выбрана в качестве основы для проекта Agentgateway, реализуемого Linux Foundation. Среди клиентов её компании — такие предприятия, как T-Mobile, ADP и SAP. Она наблюдает, как компании всё чаще внедряют локальные модели с открытым исходным кодом, и считает это следующей большой волной в использовании ИИ на предприятиях.
Она не одинока в этом мнении. Vercel — наиболее известная как платформа для создания и хостинга веб-сайтов, которая недавно добавила инструменты для переключения моделей ИИ — и OpenRouter, компания, помогающая разработчикам маршрутизировать запросы между различными моделями ИИ, — обе отмечают резкий рост трафика к моделям с открытым исходным кодом. Фактически, в прошлом месяце на долю открытых моделей пришлось 29 % всего трафика, проходящего через шлюз Vercel.
Учитывая, что генеральный директор Microsoft — компании, инвестировавшей как в OpenAI, так и в Anthropic, — теперь открыто призывает предприятия проявлять осторожность при использовании проприетарных моделей, мы ожидаем, что эта тенденция будет только усиливаться. «Используя интеллект, вы создаете интеллект. И то, что вы создаете, должно принадлежать вам», — пишет Наделла.








 США вводят санкции против китайских ИИ-компаний из-за проблем с интеллектуальной собственностью
Во вторник министр финансов США Скотт Бессент объявил, что правительство Соединенных Штатов будет тщательно проверять открытые модели из Китая на предмет потенциального кражи интеллектуальной собственности, предупредив о санкциях против китайских ИИ-
 Microsoft выводит из эксплуатации неудачные инструменты на базе искусственного интеллекта и объединяет приложения Copilot
Два года назад Microsoft охарактеризовала искусственный интеллект как «технологический сдвиг поколения», которым компания намерена руководить. Сегодня корпорация консолидирует свои потребительские и бизнес-приложения под брендом Copilot, одновременно
 По сообщениям, Microsoft обучает своих сотрудников по продажам занижать цены по сравнению с конкурентами OpenAI и Anthropic
По сообщениям, Microsoft готовит свои отделы продаж для усиления конкуренции с ключевыми соперниками в сфере искусственного интеллекта.Согласно отчету Bloomberg, во вторник руководители провели внутреннее стратегическое совещание, на котором поручил

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai












