


 Heim
Satya Nadella richtet eine eindringliche Warnung an Unternehmen, die KI einsetzen
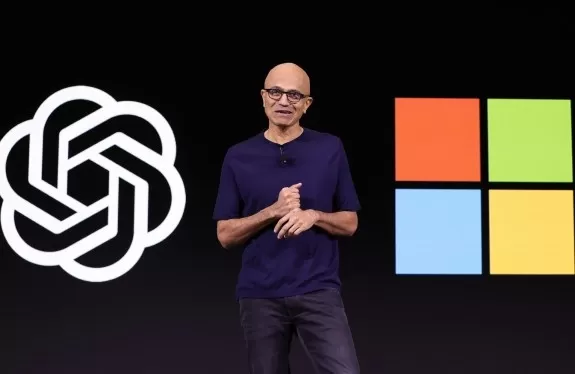
Unter den zahlreichen Debatten über die möglichen Nachteile der KI gibt es eine Sorge, die KI-Begeisterte im Silicon Valley besonders beunruhigt: dass große KI-Forschungslabore, die proprietäre Modelle verkaufen, möglicherweise wie Trojanische Pferde agieren.
Die Befürchtung ist, dass diese Labore, wenn Start-ups und Unternehmen KI-Modelle von Anbietern wie OpenAI und Anthropic einsetzen, zunehmend Zugang zu den sensibelsten Geschäftsdaten der Unternehmen erhalten. Die Modellentwickler könnten dieses Wissen dann zu ihrem eigenen Vorteil nutzen und sich so potenziell zu Konkurrenten ihrer eigenen Kunden entwickeln. Warnungen vor diesem Risiko kommen von verschiedenen Seiten, vom Risikokapitalgeber Jason Calacanis bis hin zum Palantir-CEO Alex Karp.
Nun hat sich in einem überraschenden Blogbeitrag am Montag auch Microsoft-CEO Satya Nadella zu Wort gemeldet. Nadella warnt, dass KI-Nutzer – die er als „Käufer“ bezeichnet – doppelt bezahlen. Sie zahlen bewusst für die Nutzung von KI-Token, geben dabei aber unwissentlich auch wertvolle Daten preis.
„Im Grunde bezahlt man zweimal für Intelligenz: einmal mit Geld und ein weiteres Mal mit etwas noch Wertvollerem – dem firmeneigenen Wissen, das man preisgeben muss, damit diese Intelligenz nutzbar wird. Je besser die Leistung des Modells sein soll, desto mehr von diesem Wissen muss man ihm zuführen!“, schreibt er.
Am gefährlichsten sei, so argumentiert er, dass Unternehmen den Modellen im Grunde die Feinheiten ihres eigenen Geschäfts beibringen.
„Modelle lernen aus ‚Exhaust‘, den Eingabeaufforderungen, die Menschen schreiben, den Tools, die Mitarbeiter nutzen, und vor allem aus den Korrekturen, die Menschen vornehmen, wenn das Modell falsch liegt. Jede Korrektur wird zu institutionellem Know-how verdichtet“, schreibt er.
Dies ist „die Art von Wissen, die ein Wettbewerber niemals kaufen könnte“, doch Unternehmen geben es einfach so preis.
Nadella argumentiert, dass es nur fair sei, wenn Unternehmen im Gegenzug diese Modelle untersuchen – oder „destillieren“ – dürften, wenn KI-Unternehmen das Internet frei nach Daten durchsuchen dürfen, um ihre Modelle zu trainieren. „Destillation“ bezieht sich darauf, die eigenen Ausgaben eines Modells zu nutzen, um zu verstehen, wie es funktioniert, und auf der Grundlage dieser Erkenntnisse ein neues, oft kostengünstigeres Modell zu trainieren. Im Februar warf Anthropic chinesischen Open-Source-Modellen vor, Millionen von Eingabeaufforderungen an Claude gesendet zu haben, um ihre eigenen Modelle zu verbessern, und forderte die US-Regierung auf, die Exportkontrollen zu verschärfen.
Nadellas Argument lautet, dass Modellhersteller nicht beides haben können. Es sei heuchlerisch von ihnen, ihre Modelle frei mit Daten aus aller Welt zu trainieren, während sie anderen verbieten, dasselbe mit ihren Modellen zu tun.
„Zwar ist die großartige Innovation, die dadurch entsteht, dass Modellanbieter faire Nutzungsrechte haben, um Modelle anhand öffentlicher Daten zu trainieren, notwendig, doch finde ich es ironisch, dass der Status quo darin besteht, sich dann umzudrehen und restriktive Bedingungen für die Destillation aufzuerlegen“, schreibt der Microsoft-CEO.
Nadella ist besonders besorgt, wenn Modellentwickler „sich das Recht vorbehalten, aus Nutzungs- und Interaktionsdaten ihrer Kunden zu lernen“.
Nadellas Lösung ist genau das, was man von einem CEO eines großen Cloud-Anbieters erwarten würde. Er möchte, dass Unternehmen das „Eigentumsrecht“ an ihren Daten behalten, einschließlich Eingabeaufforderungen, Feedback und mehr. Daher drängt er sie dazu, ihre eigenen „proprietären Lernumgebungen“ in der Cloud aufzubauen – wo sich ihre Daten wahrscheinlich ohnehin bereits befinden, und praktischerweise könnte das die Microsoft-Cloud Azure bedeuten. Er empfiehlt Unternehmen zudem, sogenannte „Orchestrierungsschichten“ zu implementieren – im Wesentlichen eine Möglichkeit, problemlos zwischen KI-Modellen verschiedener Anbieter zu wechseln, anstatt an einen einzigen gebunden zu sein. Tools wie KI-„Gateways“, die genau dies ermöglichen, erfreuen sich zunehmender Beliebtheit.
Zwar verwendet Nadella das Wort „Open Source“ nie als Methode zur Wahrung der Eigentumsrechte, doch ist dies ein offensichtlicher Subtext. Es gibt jedoch noch einen weiteren Subtext.
Große Unternehmen, von denen viele neben der Nutzung der Cloud nach wie vor eigene Rechenzentren betreiben, bewegen sich bereits in Richtung Open-Source-Modelle, die vor Ort installiert werden („on-prem“ im Fachjargon). Idit Levine, Gründerin und CEO von Solo.io – einem Unternehmen, das Netzwerk- und Sicherheitssoftware herstellt, um Unternehmen bei der Verwaltung von KI-Systemen zu unterstützen – sagt, dass sie genau diesen Wandel bei ihren eigenen Kunden beobachtet. Nachdem sie mit proprietären Modellentwicklern experimentiert haben, fragen sie: „Kann ich ein Open-Source-Modell nehmen und es on-prem ausführen? Es wird fast 90 % dessen leisten, was die großen Anbieter leisten. Und es wird deutlich weniger kosten“, erklärt sie gegenüber TechCrunch. „Das verstehen sie, und sie haben die Kontrolle darüber.“
Die Technologie von Solo.io wurde im vergangenen Jahr als Basis für das Agentgateway-Projekt der Linux Foundation ausgewählt. Zu den Kunden ihres Unternehmens zählen Firmen wie T-Mobile, ADP und SAP. Sie beobachtet, dass Unternehmen zunehmend Open-Source-Modelle vor Ort installieren, und sieht darin die nächste große Welle bei der Nutzung von KI in Unternehmen.
Damit steht sie nicht allein da. Vercel – vor allem bekannt als Plattform zum Erstellen und Hosten von Websites, die kürzlich Tools zum Wechseln zwischen KI-Modellen hinzugefügt hat – und OpenRouter, ein Unternehmen, das Entwicklern hilft, Anfragen über verschiedene KI-Modelle zu leiten, verzeichnen beide einen Anstieg des Datenverkehrs zu Open-Source-Modellen. Tatsächlich entfielen im vergangenen Monat 29 % des gesamten über das Gateway von Vercel geleiteten Datenverkehrs auf offene Modelle.
Da der CEO von Microsoft – einem Unternehmen, das sowohl in OpenAI als auch in Anthropic investiert hat – Unternehmen nun offen dazu auffordert, bei der Nutzung proprietärer Modelle Vorsicht walten zu lassen, gehen wir davon aus, dass sich dieser Trend weiter verstärken wird. „Indem man Intelligenz nutzt, schafft man Intelligenz. Und was man schafft, sollte einem selbst gehören“, schreibt Nadella.
Verwandter Artikel
 US-Signale für Sanktionen gegen chinesische KI-Unternehmen aufgrund von Bedenken bezüglich des geistigen Eigentums
Am Dienstag kündigte der US-Finanzminister Scott Bessent an, dass die US-Regierung quelloffene Modelle aus China auf potenziellen Diebstahl geistigen Eigentums überprüfen werde, und warnte vor Sanktionen gegen chinesische KI-Unternehmen, falls solche
Microsoft führt die gescheiterten KI-Tools aus und bündelt die Copilot-Apps
Vor zwei Jahren charakterisierte Microsoft die künstliche Intelligenz als einen „generationenübergreifenden Wandel“ in der Technologie, den sie anführen wollte. Heute konsolidiert das Unternehmen seine Copilot-Consumer- und Geschäftsanwendungen und s
Berichten zufolge schult Microsoft Vertriebsmitarbeiter, um Konkurrenten wie OpenAI und Anthropic unterbieten zu können
Berichten zufolge bereitet Microsoft seinen Vertrieb vor, um den Wettbewerb gegen wichtige Konkurrenten im Bereich der künstlichen Intelligenz zu verschärfen.Laut einem Bloomberg-Bericht haben Führungskräfte am Dienstag eine interne Strategiesitzung
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Unter den zahlreichen Debatten über die möglichen Nachteile der KI gibt es eine Sorge, die KI-Begeisterte im Silicon Valley besonders beunruhigt: dass große KI-Forschungslabore, die proprietäre Modelle verkaufen, möglicherweise wie Trojanische Pferde agieren.
Die Befürchtung ist, dass diese Labore, wenn Start-ups und Unternehmen KI-Modelle von Anbietern wie OpenAI und Anthropic einsetzen, zunehmend Zugang zu den sensibelsten Geschäftsdaten der Unternehmen erhalten. Die Modellentwickler könnten dieses Wissen dann zu ihrem eigenen Vorteil nutzen und sich so potenziell zu Konkurrenten ihrer eigenen Kunden entwickeln. Warnungen vor diesem Risiko kommen von verschiedenen Seiten, vom Risikokapitalgeber Jason Calacanis bis hin zum Palantir-CEO Alex Karp.
Nun hat sich in einem überraschenden Blogbeitrag am Montag auch Microsoft-CEO Satya Nadella zu Wort gemeldet. Nadella warnt, dass KI-Nutzer – die er als „Käufer“ bezeichnet – doppelt bezahlen. Sie zahlen bewusst für die Nutzung von KI-Token, geben dabei aber unwissentlich auch wertvolle Daten preis.
„Im Grunde bezahlt man zweimal für Intelligenz: einmal mit Geld und ein weiteres Mal mit etwas noch Wertvollerem – dem firmeneigenen Wissen, das man preisgeben muss, damit diese Intelligenz nutzbar wird. Je besser die Leistung des Modells sein soll, desto mehr von diesem Wissen muss man ihm zuführen!“, schreibt er.
Am gefährlichsten sei, so argumentiert er, dass Unternehmen den Modellen im Grunde die Feinheiten ihres eigenen Geschäfts beibringen.
„Modelle lernen aus ‚Exhaust‘, den Eingabeaufforderungen, die Menschen schreiben, den Tools, die Mitarbeiter nutzen, und vor allem aus den Korrekturen, die Menschen vornehmen, wenn das Modell falsch liegt. Jede Korrektur wird zu institutionellem Know-how verdichtet“, schreibt er.
Dies ist „die Art von Wissen, die ein Wettbewerber niemals kaufen könnte“, doch Unternehmen geben es einfach so preis.
Nadella argumentiert, dass es nur fair sei, wenn Unternehmen im Gegenzug diese Modelle untersuchen – oder „destillieren“ – dürften, wenn KI-Unternehmen das Internet frei nach Daten durchsuchen dürfen, um ihre Modelle zu trainieren. „Destillation“ bezieht sich darauf, die eigenen Ausgaben eines Modells zu nutzen, um zu verstehen, wie es funktioniert, und auf der Grundlage dieser Erkenntnisse ein neues, oft kostengünstigeres Modell zu trainieren. Im Februar warf Anthropic chinesischen Open-Source-Modellen vor, Millionen von Eingabeaufforderungen an Claude gesendet zu haben, um ihre eigenen Modelle zu verbessern, und forderte die US-Regierung auf, die Exportkontrollen zu verschärfen.
Nadellas Argument lautet, dass Modellhersteller nicht beides haben können. Es sei heuchlerisch von ihnen, ihre Modelle frei mit Daten aus aller Welt zu trainieren, während sie anderen verbieten, dasselbe mit ihren Modellen zu tun.
„Zwar ist die großartige Innovation, die dadurch entsteht, dass Modellanbieter faire Nutzungsrechte haben, um Modelle anhand öffentlicher Daten zu trainieren, notwendig, doch finde ich es ironisch, dass der Status quo darin besteht, sich dann umzudrehen und restriktive Bedingungen für die Destillation aufzuerlegen“, schreibt der Microsoft-CEO.
Nadella ist besonders besorgt, wenn Modellentwickler „sich das Recht vorbehalten, aus Nutzungs- und Interaktionsdaten ihrer Kunden zu lernen“.
Nadellas Lösung ist genau das, was man von einem CEO eines großen Cloud-Anbieters erwarten würde. Er möchte, dass Unternehmen das „Eigentumsrecht“ an ihren Daten behalten, einschließlich Eingabeaufforderungen, Feedback und mehr. Daher drängt er sie dazu, ihre eigenen „proprietären Lernumgebungen“ in der Cloud aufzubauen – wo sich ihre Daten wahrscheinlich ohnehin bereits befinden, und praktischerweise könnte das die Microsoft-Cloud Azure bedeuten. Er empfiehlt Unternehmen zudem, sogenannte „Orchestrierungsschichten“ zu implementieren – im Wesentlichen eine Möglichkeit, problemlos zwischen KI-Modellen verschiedener Anbieter zu wechseln, anstatt an einen einzigen gebunden zu sein. Tools wie KI-„Gateways“, die genau dies ermöglichen, erfreuen sich zunehmender Beliebtheit.
Zwar verwendet Nadella das Wort „Open Source“ nie als Methode zur Wahrung der Eigentumsrechte, doch ist dies ein offensichtlicher Subtext. Es gibt jedoch noch einen weiteren Subtext.
Große Unternehmen, von denen viele neben der Nutzung der Cloud nach wie vor eigene Rechenzentren betreiben, bewegen sich bereits in Richtung Open-Source-Modelle, die vor Ort installiert werden („on-prem“ im Fachjargon). Idit Levine, Gründerin und CEO von Solo.io – einem Unternehmen, das Netzwerk- und Sicherheitssoftware herstellt, um Unternehmen bei der Verwaltung von KI-Systemen zu unterstützen – sagt, dass sie genau diesen Wandel bei ihren eigenen Kunden beobachtet. Nachdem sie mit proprietären Modellentwicklern experimentiert haben, fragen sie: „Kann ich ein Open-Source-Modell nehmen und es on-prem ausführen? Es wird fast 90 % dessen leisten, was die großen Anbieter leisten. Und es wird deutlich weniger kosten“, erklärt sie gegenüber TechCrunch. „Das verstehen sie, und sie haben die Kontrolle darüber.“
Die Technologie von Solo.io wurde im vergangenen Jahr als Basis für das Agentgateway-Projekt der Linux Foundation ausgewählt. Zu den Kunden ihres Unternehmens zählen Firmen wie T-Mobile, ADP und SAP. Sie beobachtet, dass Unternehmen zunehmend Open-Source-Modelle vor Ort installieren, und sieht darin die nächste große Welle bei der Nutzung von KI in Unternehmen.
Damit steht sie nicht allein da. Vercel – vor allem bekannt als Plattform zum Erstellen und Hosten von Websites, die kürzlich Tools zum Wechseln zwischen KI-Modellen hinzugefügt hat – und OpenRouter, ein Unternehmen, das Entwicklern hilft, Anfragen über verschiedene KI-Modelle zu leiten, verzeichnen beide einen Anstieg des Datenverkehrs zu Open-Source-Modellen. Tatsächlich entfielen im vergangenen Monat 29 % des gesamten über das Gateway von Vercel geleiteten Datenverkehrs auf offene Modelle.
Da der CEO von Microsoft – einem Unternehmen, das sowohl in OpenAI als auch in Anthropic investiert hat – Unternehmen nun offen dazu auffordert, bei der Nutzung proprietärer Modelle Vorsicht walten zu lassen, gehen wir davon aus, dass sich dieser Trend weiter verstärken wird. „Indem man Intelligenz nutzt, schafft man Intelligenz. Und was man schafft, sollte einem selbst gehören“, schreibt Nadella.








 US-Signale für Sanktionen gegen chinesische KI-Unternehmen aufgrund von Bedenken bezüglich des geistigen Eigentums
Am Dienstag kündigte der US-Finanzminister Scott Bessent an, dass die US-Regierung quelloffene Modelle aus China auf potenziellen Diebstahl geistigen Eigentums überprüfen werde, und warnte vor Sanktionen gegen chinesische KI-Unternehmen, falls solche
 Microsoft führt die gescheiterten KI-Tools aus und bündelt die Copilot-Apps
Vor zwei Jahren charakterisierte Microsoft die künstliche Intelligenz als einen „generationenübergreifenden Wandel“ in der Technologie, den sie anführen wollte. Heute konsolidiert das Unternehmen seine Copilot-Consumer- und Geschäftsanwendungen und s
 Berichten zufolge schult Microsoft Vertriebsmitarbeiter, um Konkurrenten wie OpenAI und Anthropic unterbieten zu können
Berichten zufolge bereitet Microsoft seinen Vertrieb vor, um den Wettbewerb gegen wichtige Konkurrenten im Bereich der künstlichen Intelligenz zu verschärfen.Laut einem Bloomberg-Bericht haben Führungskräfte am Dienstag eine interne Strategiesitzung

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












