


 首页
微软研究揭示AI模型在软件调试中的局限性
来自OpenAI、Anthropic和其他领先AI实验室的AI模型越来越多地用于编码任务。谷歌首席执行官桑达尔·皮查伊在十月指出,AI在公司中生成25%的新代码,而Meta首席执行官马克·扎克伯格计划在社交媒体巨头内部广泛实施AI编码工具。
然而,即使是表现最好的模型也难以修复经验丰富的开发者轻松处理的软件错误。
微软研发部门近期开展的一项微软研究显示,像Anthropic的Claude 3.7 Sonnet和OpenAI的o3-mini这样的模型在SWE-bench Lite软件开发基准测试中难以解决许多问题。研究结果表明,尽管OpenAI等公司提出了雄心勃勃的主张,AI在编码等领域仍不及人类专长。
研究人员测试了九种模型作为“单一提示代理”的基础,配备了包括Python调试器在内的调试工具。该代理被分配处理SWE-bench Lite中300个精选的软件调试挑战。
结果显示,即便是使用先进模型,代理也很少能成功解决超过一半的任务。Claude 3.7 Sonnet以48.4%的成功率领先,其次是OpenAI的o1为30.2%,o3-mini为22.1%。
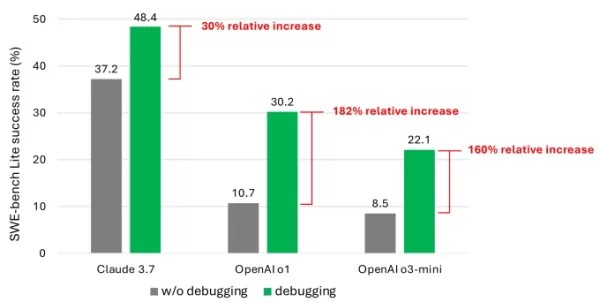
研究中的一张图表,显示调试工具为模型带来的性能提升。图片来源:微软 是什么导致了这些平庸的结果?一些模型难以有效使用可用的调试工具或识别适合特定问题的工具。研究人员认为,主要问题是缺乏足够的训练数据,特别是捕捉“顺序决策过程”的数据,如人类调试轨迹。
“我们相信,通过训练或微调这些模型可以提高它们的调试能力,”研究人员写道。“然而,这需要专门的数据,例如捕捉代理与调试器交互以收集信息并提出修复建议的轨迹数据。”
参加TechCrunch Sessions:AI
预订我们在首屈一指的AI行业活动中的席位,活动将邀请来自OpenAI、Anthropic和Cohere的演讲者。目前票价仅为292美元,可享受全天专家演讲、研讨会和网络交流机会,机会有限。
在TechCrunch Sessions:AI上展示
预订TC Sessions:AI的席位,向超过1200名决策者展示你的工作。展览机会开放至5月9日或展位售罄为止。
这些发现并不令人意外。众多研究表明,AI生成的代码常常因理解编程逻辑的弱点而引入安全漏洞和错误。最近对知名AI编码工具Devin的测试显示,它只能完成20个编程任务中的三个。
微软的研究提供了对AI模型这一持续挑战的最深入检查之一。虽然这不太可能抑制投资者对AI驱动编码工具的兴趣,但可能会促使开发者和他们的领导者重新考虑在编码任务中过度依赖AI。
值得注意的是,几位科技领袖反驳了AI将消灭编码工作的观点。微软联合创始人比尔·盖茨、Replit首席执行官阿姆贾德·马萨德、Okta首席执行官托德·麦金农和IBM首席执行官阿文德·克里希纳均表示对编程作为职业的持久性充满信心。
相关文章
 奥利押注隐私保护,力争在AI助手竞争中胜出
要真正发挥帮助作用,人工智能助手必须深刻理解其用户。Ollie 是一款专为日常生活设计的个人助理,其运作理念是:实现这一点无需用户交出数据,也不会损害用户的隐私。虽然某些企业级人工智能工具提供了数据隐私保护措施,但Ollie作为首批通过SOC 2认证的主流、面向家庭的人工智能服务之一,尤为突出。该认证框架允许企业通过独立审计证明,其已建立正式的控制措施来保护客户数据,并确保系统安全运行。达成这一里
AI LIVE:伦敦将如何探讨人工智能与工业自动化
本次峰会将汇聚来自全球的高管,共同探讨全球各行业面临的紧迫挑战,涵盖从人工智能驱动的颠覆性变革到经济波动等各个方面。AI LIVE:伦敦峰会将以“技术与人类使命”为主题,汇聚2,000余位国际领袖,共同探讨人工智能的新时代。BizClik旗下品牌《AI Magazine》已公布其在“AI LIVE:伦敦峰会”上举办的关于人工智能与工业自动化的联合炉边谈话环节阵容。该专题讨论会定于10月20日在伦敦
Anthropic 进入 AI 法律科技市场,竞争日益激烈
Anthropic 于周二发布了一系列新的聊天机器人功能,旨在为法律实务提供自动化支持。这些增强功能在年初推出的特定律所平台 Claude for Legal 基础上进行了扩展,增加了针对不同法律领域的专用法律插件和 MCP 连接器。随着法律人工智能领域竞争的加剧,这些工具应运而生。今年三月,利用代理式人工智能简化法律工作流的 AI 法律初创公司 Harvey 以 110 亿美元的估值获得了 2 亿美元融资。上个月,竞争对手 Legora 完成了 6 亿美元的 D 轮融资,并启动了一场由裘德·
相关专题推荐
教育与学习
 面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
 13 个工具
 xix.ai
代码
适用于处理重构、漏洞和安全漏洞的 GitHub 团队的 AI 代码提交审查工具
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai
文字转语音
最佳AI文本转语音工具,打造自然流畅的旁白
2026年最新、最受欢迎、评分最高的AI文本转语音工具,助您打造自然流畅的配音,尽在XIX.AI!这份精心挑选的清单汇集了功能强大、颠覆行业的工具,可为各种使用场景提供水晶般清晰的语音,且均经过实际测试验证,并每周更新排名。 获取免费版与付费版的对比分析,找到能立即提升您工作效率的必试解决方案。立即探索,释放您的AI优势!
11 个工具
xix.ai
漫画创作
适用于连载章节、封面和宣传图的漫画AI背景生成器
2026年最新最佳漫画AI背景生成器排行榜——高评分精选!这份精心策划的合集展示了功能强大、颠覆传统的工具,非常适合制作高质量的章节背景、书籍封面和宣传插画。每款工具都经过了严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比分析及详细解读。立即探索,发现最适合您的工具,在漫画创作中释放AI带来的竞争优势。
6 个工具
xix.ai
图像编辑
AI 对象去除编辑器:清理人像、旅行和产品照片
2026年最新最佳、评分最高的AI对象移除编辑器,适用于人像、旅行及产品摄影!XIX.AI精心精选了一系列功能强大、颠覆性的工具,并通过每周排名持续更新。这些工具经过实际测试,可帮助您快速移除不需要的元素、提升内容质量,并在不影响效果的前提下节省大量时间。 对于任何希望释放AI创作潜能的人来说,这都是必试之选。立即探索!
10 个工具
xix.ai
文字转语音
最适合在线课程的AI文本转语音工具
2026年最新、最佳、评价最高的在线课程AI文本转语音工具由XIX.AI根据严格的实际测试和每周更新的排名精心挑选。这些强大的工具可帮助内容创作者轻松生成清晰流畅的音频内容,从而提高写作效率并简化课程制作流程。查看免费版与付费版的对比,找到最适合您的选择。 立即探索,在在线教育领域释放您的AI优势。
10 个工具
xix.ai

 评论 (6)
0/500
![ThomasScott]()
微软这个研究结果太真实了😂 前几天用Copilot改bug,它居然把正确代码改得更错了…看来AI写代码还是得人工把关,至少现阶段别太依赖它们debug。
![HenryWalker]()
It's wild that AI is pumping out 25% of Google's code, but this Microsoft study shows it's not perfect at debugging. Kinda makes you wonder if we're trusting these models a bit too much too soon. 😅 Anyone else worried about buggy AI code sneaking into big projects?
![BrianRoberts]()
It's wild that AI is cranking out 25% of Google's code, but the debugging struggles are real. Makes me wonder if we're leaning too hard on AI without fixing its blind spots first. 🧑💻
![KevinDavis]()
It's wild that AI is pumping out 25% of Google's code, but the debugging limitations in this study make me wonder if we're leaning too hard on these models without enough human oversight. 🤔
![PeterThomas]()
Interesting read! AI generating 25% of Google's code is wild, but I'm not surprised it struggles with debugging. Machines can churn out code fast, but catching tricky bugs? That’s still a human’s game. 🧑💻
![JuanWhite]()
AI coding sounds cool, but if it can't debug properly, what's the point? 🤔 Feels like we're hyping up half-baked tools while devs still clean up the mess.
来自OpenAI、Anthropic和其他领先AI实验室的AI模型越来越多地用于编码任务。谷歌首席执行官桑达尔·皮查伊在十月指出,AI在公司中生成25%的新代码,而Meta首席执行官马克·扎克伯格计划在社交媒体巨头内部广泛实施AI编码工具。
然而,即使是表现最好的模型也难以修复经验丰富的开发者轻松处理的软件错误。
微软研发部门近期开展的一项微软研究显示,像Anthropic的Claude 3.7 Sonnet和OpenAI的o3-mini这样的模型在SWE-bench Lite软件开发基准测试中难以解决许多问题。研究结果表明,尽管OpenAI等公司提出了雄心勃勃的主张,AI在编码等领域仍不及人类专长。
研究人员测试了九种模型作为“单一提示代理”的基础,配备了包括Python调试器在内的调试工具。该代理被分配处理SWE-bench Lite中300个精选的软件调试挑战。
结果显示,即便是使用先进模型,代理也很少能成功解决超过一半的任务。Claude 3.7 Sonnet以48.4%的成功率领先,其次是OpenAI的o1为30.2%,o3-mini为22.1%。
是什么导致了这些平庸的结果?一些模型难以有效使用可用的调试工具或识别适合特定问题的工具。研究人员认为,主要问题是缺乏足够的训练数据,特别是捕捉“顺序决策过程”的数据,如人类调试轨迹。
“我们相信,通过训练或微调这些模型可以提高它们的调试能力,”研究人员写道。“然而,这需要专门的数据,例如捕捉代理与调试器交互以收集信息并提出修复建议的轨迹数据。”
参加TechCrunch Sessions:AI
预订我们在首屈一指的AI行业活动中的席位,活动将邀请来自OpenAI、Anthropic和Cohere的演讲者。目前票价仅为292美元,可享受全天专家演讲、研讨会和网络交流机会,机会有限。
在TechCrunch Sessions:AI上展示
预订TC Sessions:AI的席位,向超过1200名决策者展示你的工作。展览机会开放至5月9日或展位售罄为止。
这些发现并不令人意外。众多研究表明,AI生成的代码常常因理解编程逻辑的弱点而引入安全漏洞和错误。最近对知名AI编码工具Devin的测试显示,它只能完成20个编程任务中的三个。
微软的研究提供了对AI模型这一持续挑战的最深入检查之一。虽然这不太可能抑制投资者对AI驱动编码工具的兴趣,但可能会促使开发者和他们的领导者重新考虑在编码任务中过度依赖AI。
值得注意的是,几位科技领袖反驳了AI将消灭编码工作的观点。微软联合创始人比尔·盖茨、Replit首席执行官阿姆贾德·马萨德、Okta首席执行官托德·麦金农和IBM首席执行官阿文德·克里希纳均表示对编程作为职业的持久性充满信心。








 奥利押注隐私保护,力争在AI助手竞争中胜出
要真正发挥帮助作用,人工智能助手必须深刻理解其用户。Ollie 是一款专为日常生活设计的个人助理,其运作理念是:实现这一点无需用户交出数据,也不会损害用户的隐私。虽然某些企业级人工智能工具提供了数据隐私保护措施,但Ollie作为首批通过SOC 2认证的主流、面向家庭的人工智能服务之一,尤为突出。该认证框架允许企业通过独立审计证明,其已建立正式的控制措施来保护客户数据,并确保系统安全运行。达成这一里
 AI LIVE:伦敦将如何探讨人工智能与工业自动化
本次峰会将汇聚来自全球的高管,共同探讨全球各行业面临的紧迫挑战,涵盖从人工智能驱动的颠覆性变革到经济波动等各个方面。AI LIVE:伦敦峰会将以“技术与人类使命”为主题,汇聚2,000余位国际领袖,共同探讨人工智能的新时代。BizClik旗下品牌《AI Magazine》已公布其在“AI LIVE:伦敦峰会”上举办的关于人工智能与工业自动化的联合炉边谈话环节阵容。该专题讨论会定于10月20日在伦敦
 Anthropic 进入 AI 法律科技市场,竞争日益激烈
Anthropic 于周二发布了一系列新的聊天机器人功能,旨在为法律实务提供自动化支持。这些增强功能在年初推出的特定律所平台 Claude for Legal 基础上进行了扩展,增加了针对不同法律领域的专用法律插件和 MCP 连接器。随着法律人工智能领域竞争的加剧,这些工具应运而生。今年三月,利用代理式人工智能简化法律工作流的 AI 法律初创公司 Harvey 以 110 亿美元的估值获得了 2 亿美元融资。上个月,竞争对手 Legora 完成了 6 亿美元的 D 轮融资,并启动了一场由裘德·
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI文本转语音工具,助您打造自然流畅的配音,尽在XIX.AI!这份精心挑选的清单汇集了功能强大、颠覆行业的工具,可为各种使用场景提供水晶般清晰的语音,且均经过实际测试验证,并每周更新排名。 获取免费版与付费版的对比分析,找到能立即提升您工作效率的必试解决方案。立即探索,释放您的AI优势!
11 个工具
xix.ai
2026年最新最佳漫画AI背景生成器排行榜——高评分精选!这份精心策划的合集展示了功能强大、颠覆传统的工具,非常适合制作高质量的章节背景、书籍封面和宣传插画。每款工具都经过了严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比分析及详细解读。立即探索,发现最适合您的工具,在漫画创作中释放AI带来的竞争优势。
6 个工具
xix.ai
2026年最新最佳、评分最高的AI对象移除编辑器,适用于人像、旅行及产品摄影!XIX.AI精心精选了一系列功能强大、颠覆性的工具,并通过每周排名持续更新。这些工具经过实际测试,可帮助您快速移除不需要的元素、提升内容质量,并在不影响效果的前提下节省大量时间。 对于任何希望释放AI创作潜能的人来说,这都是必试之选。立即探索!
10 个工具
xix.ai
2026年最新、最佳、评价最高的在线课程AI文本转语音工具由XIX.AI根据严格的实际测试和每周更新的排名精心挑选。这些强大的工具可帮助内容创作者轻松生成清晰流畅的音频内容,从而提高写作效率并简化课程制作流程。查看免费版与付费版的对比,找到最适合您的选择。 立即探索,在在线教育领域释放您的AI优势。
10 个工具
xix.ai

微软这个研究结果太真实了😂 前几天用Copilot改bug,它居然把正确代码改得更错了…看来AI写代码还是得人工把关,至少现阶段别太依赖它们debug。
It's wild that AI is pumping out 25% of Google's code, but this Microsoft study shows it's not perfect at debugging. Kinda makes you wonder if we're trusting these models a bit too much too soon. 😅 Anyone else worried about buggy AI code sneaking into big projects?
It's wild that AI is cranking out 25% of Google's code, but the debugging struggles are real. Makes me wonder if we're leaning too hard on AI without fixing its blind spots first. 🧑💻
It's wild that AI is pumping out 25% of Google's code, but the debugging limitations in this study make me wonder if we're leaning too hard on these models without enough human oversight. 🤔
Interesting read! AI generating 25% of Google's code is wild, but I'm not surprised it struggles with debugging. Machines can churn out code fast, but catching tricky bugs? That’s still a human’s game. 🧑💻
AI coding sounds cool, but if it can't debug properly, what's the point? 🤔 Feels like we're hyping up half-baked tools while devs still clean up the mess.












