


 首頁
微軟研究揭示AI模型在軟體除錯中的局限性
來自OpenAI、Anthropic及其他領先AI實驗室的AI模型越來越常用於編碼任務。Google執行長Sundar Pichai於10月表示,AI在公司內生成25%的新程式碼,而Meta執行長Mark Zuckerberg則計劃在這家社群媒體巨頭中廣泛應用AI編碼工具。
然而,即使是表現最佳的模型,在修復軟體錯誤時仍難以達到經驗豐富的開發者輕鬆處理的水平。
微軟研發部門近期進行的微軟研究顯示,像Anthropic的Claude 3.7 Sonnet和OpenAI的o3-mini等模型,在SWE-bench Lite軟體開發基準測試中難以解決許多問題。研究結果顯示,儘管OpenAI等公司提出雄心勃勃的聲明,AI在編碼等領域仍無法與人類專業知識媲美。
研究人員測試了九種模型,作為配備除錯工具(包括Python除錯器)的“單一提示基礎代理”的基礎。該代理被要求處理來自SWE-bench Lite的300個精選軟體除錯挑戰。
結果顯示,即使使用先進模型,代理也很少能成功解決超過一半的任務。Claude 3.7 Sonnet以48.4%的成功率領先,其次是OpenAI的o1為30.2%,以及o3-mini為22.1%。
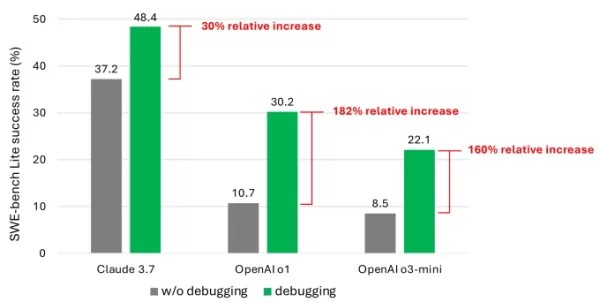
研究中的一張圖表,顯示模型從除錯工具中獲得的性能提升。圖片來源:微軟 為何成果不盡理想?一些模型難以有效使用可用的除錯工具,或無法辨識哪些工具適用於特定問題。研究人員指出,主要問題在於缺乏足夠的訓練數據,特別是捕捉“序列決策過程”的數據,如人類除錯軌跡。
“我們相信,訓練或微調這些模型可以提升其除錯能力,”研究人員寫道。“然而,這需要專門的數據,例如捕捉代理與除錯器互動以收集資訊後提出修復方案的軌跡數據。”
參加TechCrunch Sessions:AI
預訂您在我們頂尖AI行業活動的席位,講者來自OpenAI、Anthropic和Cohere。限時優惠,門票僅需292美元,即可享受全天專家講座、工作坊和 networking 機會。
在TechCrunch Sessions:AI展示
預訂您在TC Sessions:AI的席位,向超過1,200名決策者展示您的作品。展覽機會開放至5月9日或展位全數售罄為止。
這些發現並不令人意外。眾多研究顯示,AI生成的程式碼常因對程式設計邏輯理解的弱點而引入安全漏洞和錯誤。最近對知名AI編碼工具Devin的測試顯示,它僅能完成20個程式設計任務中的3個。
微軟的研究提供了對AI模型這一持續挑戰的最深入檢視之一。雖然這不太可能抑制投資者對AI編碼工具的興趣,但可能促使開發者及其領導者重新考慮過度依賴AI進行編碼任務。
值得注意的是,幾位科技領袖已反對AI將消除編碼工作的觀點。微軟共同創辦人Bill Gates、Replit執行長Amjad Masad、Okta執行長Todd McKinnon和IBM執行長Arvind Krishna均表示對程式設計作為一門職業的持久性充滿信心。
相關文章
 奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10
Anthropic 進入 AI 法律科技市場,競爭日益激烈
Anthropic 於週二釋出了一系列新的聊天機器人功能,旨在為法律實務提供自動化支援。這些增強功能在年初推出的特定律所平臺 Claude for Legal 基礎上進行了擴充套件,增加了針對不同法律領域的專用法律外掛和 MCP 聯結器。隨著法律人工智慧領域競爭的加劇,這些工具應運而生。今年三月,利用代理式人工智慧簡化法律工作流的 AI 法律初創公司 Harvey 以 110 億美元的估值獲得了 2 億美元融資。上個月,競爭對手 Legora 完成了 6 億美元的 D 輪融資,並啟動了一場由裘德·
相關專題推薦
教育與學習
 適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
 10 個工具
 xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai
教育與學習
面向教師、輔導老師和基於群體的學習專案的 AI 測驗構建平臺
2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai

 評論 (6)
0/500
![ThomasScott]()
微软这个研究结果太真实了😂 前几天用Copilot改bug,它居然把正确代码改得更错了…看来AI写代码还是得人工把关,至少现阶段别太依赖它们debug。
![HenryWalker]()
It's wild that AI is pumping out 25% of Google's code, but this Microsoft study shows it's not perfect at debugging. Kinda makes you wonder if we're trusting these models a bit too much too soon. 😅 Anyone else worried about buggy AI code sneaking into big projects?
![BrianRoberts]()
It's wild that AI is cranking out 25% of Google's code, but the debugging struggles are real. Makes me wonder if we're leaning too hard on AI without fixing its blind spots first. 🧑💻
![KevinDavis]()
It's wild that AI is pumping out 25% of Google's code, but the debugging limitations in this study make me wonder if we're leaning too hard on these models without enough human oversight. 🤔
![PeterThomas]()
Interesting read! AI generating 25% of Google's code is wild, but I'm not surprised it struggles with debugging. Machines can churn out code fast, but catching tricky bugs? That’s still a human’s game. 🧑💻
![JuanWhite]()
AI coding sounds cool, but if it can't debug properly, what's the point? 🤔 Feels like we're hyping up half-baked tools while devs still clean up the mess.
來自OpenAI、Anthropic及其他領先AI實驗室的AI模型越來越常用於編碼任務。Google執行長Sundar Pichai於10月表示,AI在公司內生成25%的新程式碼,而Meta執行長Mark Zuckerberg則計劃在這家社群媒體巨頭中廣泛應用AI編碼工具。
然而,即使是表現最佳的模型,在修復軟體錯誤時仍難以達到經驗豐富的開發者輕鬆處理的水平。
微軟研發部門近期進行的微軟研究顯示,像Anthropic的Claude 3.7 Sonnet和OpenAI的o3-mini等模型,在SWE-bench Lite軟體開發基準測試中難以解決許多問題。研究結果顯示,儘管OpenAI等公司提出雄心勃勃的聲明,AI在編碼等領域仍無法與人類專業知識媲美。
研究人員測試了九種模型,作為配備除錯工具(包括Python除錯器)的“單一提示基礎代理”的基礎。該代理被要求處理來自SWE-bench Lite的300個精選軟體除錯挑戰。
結果顯示,即使使用先進模型,代理也很少能成功解決超過一半的任務。Claude 3.7 Sonnet以48.4%的成功率領先,其次是OpenAI的o1為30.2%,以及o3-mini為22.1%。
為何成果不盡理想?一些模型難以有效使用可用的除錯工具,或無法辨識哪些工具適用於特定問題。研究人員指出,主要問題在於缺乏足夠的訓練數據,特別是捕捉“序列決策過程”的數據,如人類除錯軌跡。
“我們相信,訓練或微調這些模型可以提升其除錯能力,”研究人員寫道。“然而,這需要專門的數據,例如捕捉代理與除錯器互動以收集資訊後提出修復方案的軌跡數據。”
參加TechCrunch Sessions:AI
預訂您在我們頂尖AI行業活動的席位,講者來自OpenAI、Anthropic和Cohere。限時優惠,門票僅需292美元,即可享受全天專家講座、工作坊和 networking 機會。
在TechCrunch Sessions:AI展示
預訂您在TC Sessions:AI的席位,向超過1,200名決策者展示您的作品。展覽機會開放至5月9日或展位全數售罄為止。
這些發現並不令人意外。眾多研究顯示,AI生成的程式碼常因對程式設計邏輯理解的弱點而引入安全漏洞和錯誤。最近對知名AI編碼工具Devin的測試顯示,它僅能完成20個程式設計任務中的3個。
微軟的研究提供了對AI模型這一持續挑戰的最深入檢視之一。雖然這不太可能抑制投資者對AI編碼工具的興趣,但可能促使開發者及其領導者重新考慮過度依賴AI進行編碼任務。
值得注意的是,幾位科技領袖已反對AI將消除編碼工作的觀點。微軟共同創辦人Bill Gates、Replit執行長Amjad Masad、Okta執行長Todd McKinnon和IBM執行長Arvind Krishna均表示對程式設計作為一門職業的持久性充滿信心。








 奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
 「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10
 Anthropic 進入 AI 法律科技市場,競爭日益激烈
Anthropic 於週二釋出了一系列新的聊天機器人功能,旨在為法律實務提供自動化支援。這些增強功能在年初推出的特定律所平臺 Claude for Legal 基礎上進行了擴充套件,增加了針對不同法律領域的專用法律外掛和 MCP 聯結器。隨著法律人工智慧領域競爭的加劇,這些工具應運而生。今年三月,利用代理式人工智慧簡化法律工作流的 AI 法律初創公司 Harvey 以 110 億美元的估值獲得了 2 億美元融資。上個月,競爭對手 Legora 完成了 6 億美元的 D 輪融資,並啟動了一場由裘德·

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai

微软这个研究结果太真实了😂 前几天用Copilot改bug,它居然把正确代码改得更错了…看来AI写代码还是得人工把关,至少现阶段别太依赖它们debug。
It's wild that AI is pumping out 25% of Google's code, but this Microsoft study shows it's not perfect at debugging. Kinda makes you wonder if we're trusting these models a bit too much too soon. 😅 Anyone else worried about buggy AI code sneaking into big projects?
It's wild that AI is cranking out 25% of Google's code, but the debugging struggles are real. Makes me wonder if we're leaning too hard on AI without fixing its blind spots first. 🧑💻
It's wild that AI is pumping out 25% of Google's code, but the debugging limitations in this study make me wonder if we're leaning too hard on these models without enough human oversight. 🤔
Interesting read! AI generating 25% of Google's code is wild, but I'm not surprised it struggles with debugging. Machines can churn out code fast, but catching tricky bugs? That’s still a human’s game. 🧑💻
AI coding sounds cool, but if it can't debug properly, what's the point? 🤔 Feels like we're hyping up half-baked tools while devs still clean up the mess.












