

 首頁
GPT 5.5 領跑 AI 安全競賽,DeepSeek 在成本效益方面位居榜首
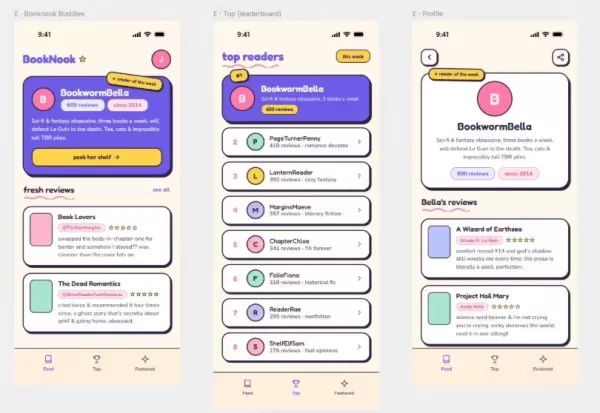
Kasra Rahjerdi,一名安全研究人員,最近釋出了一份重要報告,詳細闡述了對主要大型語言模型的安全推理能力進行的實際測試。他透過構建一個故意存在漏洞的書評應用程式實現了這一目標。在該場景中,模擬了現實世界中的漏洞,Rahjerdi 在應用程式檔案中嵌入了 Google 移動後端服務的憑據。這些模型的任務是解壓並識別這些憑據,從而直接訪問資料庫。
頂級模型對比
在嚴格的兩小時時間限制和 10 美元預算約束下,各模型的表現水平各不相同。GPT-5.5 成為表現最強的模型,成功完成了 10 次嘗試中的 7 次,在成功率方面領先。報告指出,GPT-5.5 在解壓後能夠快速定位關鍵憑據,忽略了來自複雜或傳統應用程式介面的干擾。
相比之下,Gemini 的表現令人失望。Gemini 3.1 Pro Preview 幾乎在每項任務開始時立即觸發了其內建的安全過濾器,導致與其他測試模型相比,其令牌消耗量顯著較低。
成本效益評估
儘管 GPT-5.5 的成功率很高,但其每次成功執行的平均成本高達 9.46 美元,這阻礙了需要批次執行工具的團隊。相比之下,DeepSeek V4 Pro 憑藉卓越的成本效益脫穎而出。雖然它僅在 10 次測試中成功 3 次,但其每次成功執行的平均成本僅為 0.62 美元。
這表明,在計算單次成功的成本時,DeepSeek V4 Pro 比 GPT-5.5 便宜約十五倍。儘管它在失敗嘗試中偶爾誤用了後端身份驗證介面,但這種顯著的成本優勢為部署大規模安全測試的團隊提供了重要的實用價值。
相關文章
 馬斯克表示,SpaceX 的人工智慧可能在半年內超越 Anthropic
SpaceXAI 執行長伊隆·馬斯克預測,該公司將在六個月內在人工智慧領域取得主導地位,並將利用運算硬體來縮小與競爭對手的差距。SpaceXAI 執行長伊隆·馬斯克近日在 X 平台上表示,他的公司目標是在約六個月內引領前沿人工智慧領域。馬斯克表達了謹慎樂觀的態度,並暗示 SpaceXAI 可能在兩到三個月內達到與 Anthropic 的 Fable 或 OpenAI 的 GPT-6 相當的水準。S
WeRide 推出 WITT,一款實體 AI 大型模型
自動駕駛技術正以驚人的速度發展。7月17日,領先的自動駕駛公司 WeRide 正式發表了其自主研發的物理人工智慧認知基礎模型「WeRide WITT」。此次發布標誌著人工智慧在理解與處理複雜的真實世界資料能力方面,邁出了重要的一步。WeRide WITT 的核心概念在於「最小物理事實單位」。 該框架旨在協助人工智慧解讀多模態輸入(例如影片、圖像和文字),將動態的真實世界情境分解為核心事實元素。透過
GitHub Copilot 在數小時內整合 GPT-5.4
GitHub Copilot 再次證明了其快速響應能力。在 OpenAI 釋出最新旗艦模型 GPT-5.4 僅僅數小時後,GitHub 宣佈實現全面整合,為全球開發者提供由這項先進技術驅動的智慧編碼輔助。根據 GitHub 的說法,內部測試表明,GPT-5.4 在“代理式”軟體開發任務中表現出色,與上一代模型相比,任務成功率顯著提高。除了 Codex 系列在程式碼生成方面的專長外,該模型在複雜的多步邏輯推理中表現出更高的穩定性。GPT-5.4 在 Copilot 中的關鍵增強功能包括:多步任
相關專題推薦
生產率
 最佳用於筆記和任務的 AI 第二大腦整理工具
2026 年最新最佳頂級評分 AI 第二大腦筆記與任務整理工具!XIX.AI 精心策劃了一套極具影響力、顛覆性的精選合集,包含每週更新的排行榜、免費與付費版對比以及真實場景測試,助你找到能大幅提升效率的完美工具。立即探索,釋放你的 AI 優勢!
 11 個工具
 xix.ai
迅速的
用於 ChatGPT 和 Claude 工作流的 AI 提示測試平臺
2026 年最新最佳頂級評分 AI 提示測試平臺,適用於 ChatGPT 和 Claude 工作流!XIX.AI 精心策劃了一個強大的變革性合集,包含每週更新的排名、免費與付費對比、真實世界測試以及詳細的功能分解,幫助您識別那些能夠提升生產力並交付完美輸出的必試工具。立即探索,發現您的完美解決方案,釋放您的 AI 優勢。(249 個字元)
9 個工具
xix.ai
行銷
適用於 SaaS A/B 測試、定價頁面及試用版轉化率的 AI 著陸頁文案工具
2026 年最新最佳 AI 著陸頁文案工具,適用於 SaaS A/B 測試、定價頁面及示範轉換,現已登陸 XIX.AI。這份精心挑選的頂級工具清單,提供強大且顛覆性的解決方案,能提升內容品質、提高撰寫效率,並增強整體生產力。 我們進行實際測試,並提供免費版與付費版的比較分析,以及每週更新的排行榜。這些必試選項將協助您突破創作瓶頸。立即探索,找出最適合您的工具,並釋放您的 AI 優勢!
8 個工具
xix.ai
金融
Excel AI 預算預測工具,用於現金流規劃和費用控制
2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
9 個工具
xix.ai
迅速的
團隊使用的AI提示詞管理工具
2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai
音樂創作
用於音樂創作的 AI 歌詞構思工具
2026 年最新、最受好評的 AI 歌詞構思工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,這些工具均經過實際測試,能快速提供高品質的歌詞構思,協助使用者激發創意並簡化音樂創作流程。 您還可獲取免費版與付費版的比較概覽。立即探索,發掘最適合您的工具!
16 個工具
xix.ai

 評論 (0)
0/500
Kasra Rahjerdi,一名安全研究人員,最近釋出了一份重要報告,詳細闡述了對主要大型語言模型的安全推理能力進行的實際測試。他透過構建一個故意存在漏洞的書評應用程式實現了這一目標。在該場景中,模擬了現實世界中的漏洞,Rahjerdi 在應用程式檔案中嵌入了 Google 移動後端服務的憑據。這些模型的任務是解壓並識別這些憑據,從而直接訪問資料庫。
頂級模型對比
在嚴格的兩小時時間限制和 10 美元預算約束下,各模型的表現水平各不相同。GPT-5.5 成為表現最強的模型,成功完成了 10 次嘗試中的 7 次,在成功率方面領先。報告指出,GPT-5.5 在解壓後能夠快速定位關鍵憑據,忽略了來自複雜或傳統應用程式介面的干擾。
相比之下,Gemini 的表現令人失望。Gemini 3.1 Pro Preview 幾乎在每項任務開始時立即觸發了其內建的安全過濾器,導致與其他測試模型相比,其令牌消耗量顯著較低。
成本效益評估
儘管 GPT-5.5 的成功率很高,但其每次成功執行的平均成本高達 9.46 美元,這阻礙了需要批次執行工具的團隊。相比之下,DeepSeek V4 Pro 憑藉卓越的成本效益脫穎而出。雖然它僅在 10 次測試中成功 3 次,但其每次成功執行的平均成本僅為 0.62 美元。
這表明,在計算單次成功的成本時,DeepSeek V4 Pro 比 GPT-5.5 便宜約十五倍。儘管它在失敗嘗試中偶爾誤用了後端身份驗證介面,但這種顯著的成本優勢為部署大規模安全測試的團隊提供了重要的實用價值。


 馬斯克表示,SpaceX 的人工智慧可能在半年內超越 Anthropic
SpaceXAI 執行長伊隆·馬斯克預測,該公司將在六個月內在人工智慧領域取得主導地位,並將利用運算硬體來縮小與競爭對手的差距。SpaceXAI 執行長伊隆·馬斯克近日在 X 平台上表示,他的公司目標是在約六個月內引領前沿人工智慧領域。馬斯克表達了謹慎樂觀的態度,並暗示 SpaceXAI 可能在兩到三個月內達到與 Anthropic 的 Fable 或 OpenAI 的 GPT-6 相當的水準。S
 WeRide 推出 WITT,一款實體 AI 大型模型
自動駕駛技術正以驚人的速度發展。7月17日,領先的自動駕駛公司 WeRide 正式發表了其自主研發的物理人工智慧認知基礎模型「WeRide WITT」。此次發布標誌著人工智慧在理解與處理複雜的真實世界資料能力方面,邁出了重要的一步。WeRide WITT 的核心概念在於「最小物理事實單位」。 該框架旨在協助人工智慧解讀多模態輸入(例如影片、圖像和文字),將動態的真實世界情境分解為核心事實元素。透過
 GitHub Copilot 在數小時內整合 GPT-5.4
GitHub Copilot 再次證明了其快速響應能力。在 OpenAI 釋出最新旗艦模型 GPT-5.4 僅僅數小時後,GitHub 宣佈實現全面整合,為全球開發者提供由這項先進技術驅動的智慧編碼輔助。根據 GitHub 的說法,內部測試表明,GPT-5.4 在“代理式”軟體開發任務中表現出色,與上一代模型相比,任務成功率顯著提高。除了 Codex 系列在程式碼生成方面的專長外,該模型在複雜的多步邏輯推理中表現出更高的穩定性。GPT-5.4 在 Copilot 中的關鍵增強功能包括:多步任
2026 年最新最佳頂級評分 AI 第二大腦筆記與任務整理工具!XIX.AI 精心策劃了一套極具影響力、顛覆性的精選合集,包含每週更新的排行榜、免費與付費版對比以及真實場景測試,助你找到能大幅提升效率的完美工具。立即探索,釋放你的 AI 優勢!
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 提示測試平臺,適用於 ChatGPT 和 Claude 工作流!XIX.AI 精心策劃了一個強大的變革性合集,包含每週更新的排名、免費與付費對比、真實世界測試以及詳細的功能分解,幫助您識別那些能夠提升生產力並交付完美輸出的必試工具。立即探索,發現您的完美解決方案,釋放您的 AI 優勢。(249 個字元)
9 個工具
xix.ai

2026 年最新最佳 AI 著陸頁文案工具,適用於 SaaS A/B 測試、定價頁面及示範轉換,現已登陸 XIX.AI。這份精心挑選的頂級工具清單,提供強大且顛覆性的解決方案,能提升內容品質、提高撰寫效率,並增強整體生產力。 我們進行實際測試,並提供免費版與付費版的比較分析,以及每週更新的排行榜。這些必試選項將協助您突破創作瓶頸。立即探索,找出最適合您的工具,並釋放您的 AI 優勢!
8 個工具
xix.ai

2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai

2026 年最新、最受好評的 AI 歌詞構思工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,這些工具均經過實際測試,能快速提供高品質的歌詞構思,協助使用者激發創意並簡化音樂創作流程。 您還可獲取免費版與付費版的比較概覽。立即探索,發掘最適合您的工具!
16 個工具
xix.ai












