


 首頁
DeepCoder通過14B開放模型實現高編碼效率
介紹 DeepCoder-14B:開源編碼模型的新前沿
Together AI 和 Agentica 的團隊推出了 DeepCoder-14B,這是一款突破性的編碼模型,與頂尖專有模型如 OpenAI 的 o3-mini 並駕齊驅。這項令人振奮的發展基於 DeepSeek-R1 的基礎,提供了更高的靈活性,用於將高效能的程式碼生成和推理整合到實際應用中。更令人讚賞的是,創作者採取了完全開源的做法,包括模型的訓練數據、程式碼、日誌和系統優化。這一舉措將催化研究並加速該領域的進展。
小巧包裝中的出色表現
DeepCoder-14B 在多個編碼基準測試中表現出色,例如 LiveCodeBench (LCB)、Codeforces 和 HumanEval+。研究團隊的實驗顯示,該模型的性能與領先模型如 o3-mini (低階) 和 o1 相當。研究人員在他們的部落格文章中自豪地表示:「我們的模型在所有編碼基準測試中展現出強大的性能……與 o3-mini (低階) 和 o1 的表現相當。」
特別引人注目的是,雖然 DeepCoder-14B 主要針對編碼任務進行訓練,但它在數學推理方面也顯示出顯著的進步,在 AIME 2024 基準測試中獲得了 73.8% 的分數。這比其基礎模型 DeepSeek-R1-Distill-Qwen-14B 提高了 4.1%,表明通過強化學習 (RL) 在程式碼上培養的推理技能可以有效地轉移到其他領域。
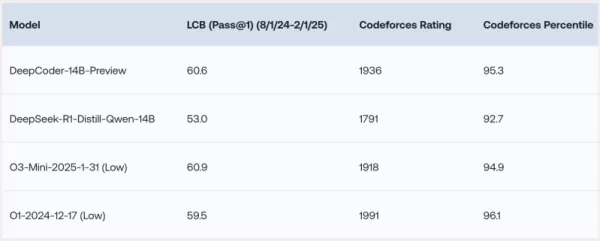
*來源:Together AI* DeepCoder-14B 最令人興奮的特點或許是其效率。僅有 140 億個參數,它在性能上表現出色,同時比許多其他領先模型更小巧、更節省資源。
DeepCoder 成功的背後創新
開發 DeepCoder-14B 涉及克服多項挑戰,特別是在使用強化學習訓練編碼模型時。一個主要障礙是訓練數據的整理。與數學任務不同,高質量、可驗證的數據在數學領域中較為豐富,而編碼數據可能較為稀缺。DeepCoder 團隊通過實施嚴格的數據收集和過濾管道,解決了這個問題,確保數據的有效性、複雜性和避免重複。這個過程產生了 24,000 個高質量問題,形成了強化學習訓練的堅實基礎。
團隊還設計了一個簡單的獎勵函數,只有當生成的程式碼在設定的時間限制內成功通過所有抽樣單元測試時才會獎勵模型。這種方法,結合高質量的訓練範例,確保模型專注於解決核心問題,而不是利用捷徑。
DeepCoder-14B 的訓練演算法基於群組相對策略優化 (GRPO),這在 DeepSeek-R1 中已獲得成功。然而,團隊進行了重大修改,以增強穩定性並實現更長的訓練時間。
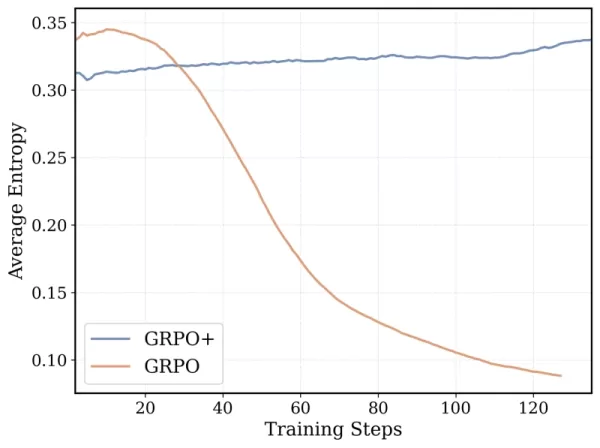
*GRPO+ 使 DeepCoder-14B 能持續更長時間而不崩潰 來源:Together AI* 此外,團隊逐步擴展了模型的上下文窗口,從較短的序列開始,逐步增加。他們還引入了一種過濾方法,以避免在解決複雜提示時因超出上下文限制而懲罰模型。
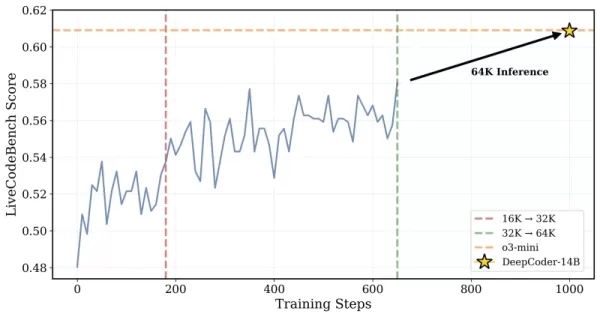
*DeepCoder 在 32K 上下文問題上進行訓練,但也能解決 64K 任務 來源:Together AI* 研究人員解釋了他們的方法:「為了在保持長上下文推理的同時實現高效訓練,我們引入了超長過濾技術……這項技術在訓練期間遮罩截斷序列,以避免模型因生成深思熟慮但超出當前上下文限制的冗長輸出而受到懲罰。」訓練從 16K 上下文窗口擴展到 32K,使模型能夠處理需要高達 64K 令牌的問題。
優化長上下文強化學習訓練
使用強化學習訓練大型模型,特別是在生成長序列的任務如編碼時,眾所周知是緩慢且資源密集的。抽樣步驟中,模型為每個範例生成數千個令牌,由於回應長度的變化,通常會導致顯著的延遲。
為了解決這個問題,團隊開發了 verl-pipeline,這是基於開源 verl 庫的優化擴展,用於從人類反饋進行強化學習 (RLHF)。他們的「一次性流水線」創新重新組織了抽樣和模型更新,以最小化瓶頸並減少加速器上的閒置時間。
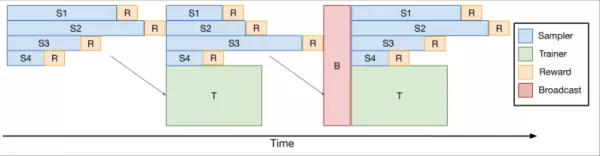
*一次性流水線* 他們的實驗顯示,一次性流水線能將編碼強化學習任務的速度提升高達 2 倍,與標準方法相比。這項優化對於在合理時間內(32 個 H100 上 2.5 週)訓練 DeepCoder-14B 至關重要,現在已作為 verl-pipeline 的一部分開源,供社群使用。
企業影響與開源協作
研究人員已在 GitHub 和 Hugging Face 上以寬鬆許可證公開了 DeepCoder-14B 的所有訓練和操作資源。他們表示:「通過完全分享我們的數據集、程式碼和訓練配方,我們賦予社群重現我們的工作並使強化學習訓練對所有人可及。」
DeepCoder-14B 體現了 AI 領域中高效、開放可用的模型日益增長的趨勢。對於企業來說,這意味著更多的選擇和對先進模型的更大可及性。高效能的程式碼生成和推理不再是大公司或願意支付高額 API 費用的組織獨享。各種規模的組織現在都可以利用這些能力,根據其特定需求定制解決方案,並在自己的環境中安全部署。
這種轉變將降低 AI 採用的門檻,促進一個由開源協作驅動的更具競爭力和創新性的生態系統。
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
相關專題推薦
商業
 最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
 9 個工具
 xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai
迅速的
適用於 ChatGPT 工作流程的最佳 AI 提示詞庫
2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai
教育與學習
面向教師、輔導老師和基於群體的學習專案的 AI 測驗構建平臺
2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai
代碼
適用於 GitHub 團隊處理重構、錯誤及安全漏洞的 AI 拉取請求審查工具
2026 年最新、最優秀的 GitHub 團隊 AI 拉取請求審查工具,就在 XIX.AI!這份精選且評價極高的清單,展示了多款強大且能徹底改變遊戲規則的解決方案,可優化所有團隊工作流程中的重構、錯誤修復及安全漏洞偵測。 透過免費與付費版本的比較、實際測試結果以及詳細排名,協助您找到能顯著提升生產力的完美工具。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai
文字轉語音
最適合製作自然語音旁白的頂尖 AI 文字轉語音工具
2026 年最新、最受好評的頂級 AI 文字轉語音工具,助您打造自然生動的配音,盡在 XIX.AI!這份精選清單收錄了強大且顛覆業界的選項,能為各種使用情境提供水晶般清晰的語音,並經由實際測試驗證,排行榜更每週更新。 立即獲取免費版與付費版的比較指南,找出能瞬間提升您工作效率的必試解決方案。現在就來探索,解鎖您的 AI 競爭優勢!
11 個工具
xix.ai

 評論 (14)
0/500
![RyanTaylor]()
Interesting! I've been following the open-source vs. proprietary model race. DeepCoder-14B matching o3-mini is a big deal for accessibility. Hope this pushes the big players to open up more, or at least lower their prices. The compute cost for training these 14B models must be insane though. 🤔
![FrankRodriguez]()
Wow, DeepCoder-14B sounds like a game-changer! I'm stoked to see open-source models catching up to the big players. Can't wait to try it out for my side projects—hope it’s as fast as they claim! 🚀
![GregoryBaker]()
DeepCoder-14B sounds like a game-changer! Can't wait to try it out and see how it stacks up against the big players. 🚀
![BillyLewis]()
Wow, DeepCoder-14B sounds like a game-changer for open-source coding! I'm curious how it stacks up against o3-mini in real-world projects. Anyone tried it yet? 🚀
![RaymondWalker]()
¡DeepCoder-14B es una locura! Un modelo de código abierto que compite con los grandes. ¿Será el fin de los modelos propietarios? 🤔
![RalphGarcia]()
DeepCoder-14B、めっちゃ面白そう!😊 オープンソースでここまでできるなんて、コーディングの未来が楽しみ!
介紹 DeepCoder-14B:開源編碼模型的新前沿
Together AI 和 Agentica 的團隊推出了 DeepCoder-14B,這是一款突破性的編碼模型,與頂尖專有模型如 OpenAI 的 o3-mini 並駕齊驅。這項令人振奮的發展基於 DeepSeek-R1 的基礎,提供了更高的靈活性,用於將高效能的程式碼生成和推理整合到實際應用中。更令人讚賞的是,創作者採取了完全開源的做法,包括模型的訓練數據、程式碼、日誌和系統優化。這一舉措將催化研究並加速該領域的進展。
小巧包裝中的出色表現
DeepCoder-14B 在多個編碼基準測試中表現出色,例如 LiveCodeBench (LCB)、Codeforces 和 HumanEval+。研究團隊的實驗顯示,該模型的性能與領先模型如 o3-mini (低階) 和 o1 相當。研究人員在他們的部落格文章中自豪地表示:「我們的模型在所有編碼基準測試中展現出強大的性能……與 o3-mini (低階) 和 o1 的表現相當。」
特別引人注目的是,雖然 DeepCoder-14B 主要針對編碼任務進行訓練,但它在數學推理方面也顯示出顯著的進步,在 AIME 2024 基準測試中獲得了 73.8% 的分數。這比其基礎模型 DeepSeek-R1-Distill-Qwen-14B 提高了 4.1%,表明通過強化學習 (RL) 在程式碼上培養的推理技能可以有效地轉移到其他領域。
DeepCoder-14B 最令人興奮的特點或許是其效率。僅有 140 億個參數,它在性能上表現出色,同時比許多其他領先模型更小巧、更節省資源。
DeepCoder 成功的背後創新
開發 DeepCoder-14B 涉及克服多項挑戰,特別是在使用強化學習訓練編碼模型時。一個主要障礙是訓練數據的整理。與數學任務不同,高質量、可驗證的數據在數學領域中較為豐富,而編碼數據可能較為稀缺。DeepCoder 團隊通過實施嚴格的數據收集和過濾管道,解決了這個問題,確保數據的有效性、複雜性和避免重複。這個過程產生了 24,000 個高質量問題,形成了強化學習訓練的堅實基礎。
團隊還設計了一個簡單的獎勵函數,只有當生成的程式碼在設定的時間限制內成功通過所有抽樣單元測試時才會獎勵模型。這種方法,結合高質量的訓練範例,確保模型專注於解決核心問題,而不是利用捷徑。
DeepCoder-14B 的訓練演算法基於群組相對策略優化 (GRPO),這在 DeepSeek-R1 中已獲得成功。然而,團隊進行了重大修改,以增強穩定性並實現更長的訓練時間。
此外,團隊逐步擴展了模型的上下文窗口,從較短的序列開始,逐步增加。他們還引入了一種過濾方法,以避免在解決複雜提示時因超出上下文限制而懲罰模型。
研究人員解釋了他們的方法:「為了在保持長上下文推理的同時實現高效訓練,我們引入了超長過濾技術……這項技術在訓練期間遮罩截斷序列,以避免模型因生成深思熟慮但超出當前上下文限制的冗長輸出而受到懲罰。」訓練從 16K 上下文窗口擴展到 32K,使模型能夠處理需要高達 64K 令牌的問題。
優化長上下文強化學習訓練
使用強化學習訓練大型模型,特別是在生成長序列的任務如編碼時,眾所周知是緩慢且資源密集的。抽樣步驟中,模型為每個範例生成數千個令牌,由於回應長度的變化,通常會導致顯著的延遲。
為了解決這個問題,團隊開發了 verl-pipeline,這是基於開源 verl 庫的優化擴展,用於從人類反饋進行強化學習 (RLHF)。他們的「一次性流水線」創新重新組織了抽樣和模型更新,以最小化瓶頸並減少加速器上的閒置時間。
他們的實驗顯示,一次性流水線能將編碼強化學習任務的速度提升高達 2 倍,與標準方法相比。這項優化對於在合理時間內(32 個 H100 上 2.5 週)訓練 DeepCoder-14B 至關重要,現在已作為 verl-pipeline 的一部分開源,供社群使用。
企業影響與開源協作
研究人員已在 GitHub 和 Hugging Face 上以寬鬆許可證公開了 DeepCoder-14B 的所有訓練和操作資源。他們表示:「通過完全分享我們的數據集、程式碼和訓練配方,我們賦予社群重現我們的工作並使強化學習訓練對所有人可及。」
DeepCoder-14B 體現了 AI 領域中高效、開放可用的模型日益增長的趨勢。對於企業來說,這意味著更多的選擇和對先進模型的更大可及性。高效能的程式碼生成和推理不再是大公司或願意支付高額 API 費用的組織獨享。各種規模的組織現在都可以利用這些能力,根據其特定需求定制解決方案,並在自己的環境中安全部署。
這種轉變將降低 AI 採用的門檻,促進一個由開源協作驅動的更具競爭力和創新性的生態系統。








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
 Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai

2026 年最新、最優秀的 GitHub 團隊 AI 拉取請求審查工具,就在 XIX.AI!這份精選且評價極高的清單,展示了多款強大且能徹底改變遊戲規則的解決方案,可優化所有團隊工作流程中的重構、錯誤修復及安全漏洞偵測。 透過免費與付費版本的比較、實際測試結果以及詳細排名,協助您找到能顯著提升生產力的完美工具。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai

2026 年最新、最受好評的頂級 AI 文字轉語音工具,助您打造自然生動的配音,盡在 XIX.AI!這份精選清單收錄了強大且顛覆業界的選項,能為各種使用情境提供水晶般清晰的語音,並經由實際測試驗證,排行榜更每週更新。 立即獲取免費版與付費版的比較指南,找出能瞬間提升您工作效率的必試解決方案。現在就來探索,解鎖您的 AI 競爭優勢!
11 個工具
xix.ai

Interesting! I've been following the open-source vs. proprietary model race. DeepCoder-14B matching o3-mini is a big deal for accessibility. Hope this pushes the big players to open up more, or at least lower their prices. The compute cost for training these 14B models must be insane though. 🤔
Wow, DeepCoder-14B sounds like a game-changer! I'm stoked to see open-source models catching up to the big players. Can't wait to try it out for my side projects—hope it’s as fast as they claim! 🚀
DeepCoder-14B sounds like a game-changer! Can't wait to try it out and see how it stacks up against the big players. 🚀
Wow, DeepCoder-14B sounds like a game-changer for open-source coding! I'm curious how it stacks up against o3-mini in real-world projects. Anyone tried it yet? 🚀
¡DeepCoder-14B es una locura! Un modelo de código abierto que compite con los grandes. ¿Será el fin de los modelos propietarios? 🤔
DeepCoder-14B、めっちゃ面白そう!😊 オープンソースでここまでできるなんて、コーディングの未来が楽しみ!












