


 집
DeepCoder는 14B 오픈 모델로 높은 코딩 효율을 달성합니다
DeepCoder-14B 소개: 오픈 소스 코딩 모델의 새로운 지평
Together AI와 Agentica의 팀은 DeepCoder-14B를 공개했습니다. 이는 OpenAI의 o3-mini와 같은 최고 수준의 독점 모델과 어깨를 나란히 하는 획기적인 코딩 모델입니다. 이 흥미로운 개발은 DeepSeek-R1을 기반으로 하며, 고성능 코드 생성 및 추론을 실제 응용 프로그램에 통합할 수 있는 향상된 유연성을 제공합니다. 더욱이, 제작자들은 모델을 완전히 오픈 소스로 공개하며 훈련 데이터, 코드, 로그, 시스템 최적화를 포함하는 훌륭한 조치를 취했습니다. 이 결정은 연구를 촉진하고 해당 분야의 발전을 가속화할 것입니다.
컴팩트한 패키지에서의 인상적인 성능
DeepCoder-14B는 LiveCodeBench(LCB), Codeforces, HumanEval+와 같은 다양한 코딩 벤치마크에서 놀라운 결과를 보여주었습니다. 연구팀의 실험은 이 모델의 성능이 o3-mini(낮음) 및 o1과 같은 선도 모델들과 동등하다는 것을 강조했습니다. 연구진은 블로그 포스트에서 “우리 모델은 모든 코딩 벤치마크에서 강력한 성능을 보여주며… o3-mini(낮음) 및 o1의 성능과 비슷하다”고 자랑스럽게 밝혔습니다.
특히 흥미로운 점은 주로 코딩 작업에 훈련되었음에도 불구하고, DeepCoder-14B는 수학적 추론에서도 주목할 만한 향상을 보여 AIME 2024 벤치마크에서 73.8%의 점수를 달성했습니다. 이는 기본 모델인 DeepSeek-R1-Distill-Qwen-14B보다 4.1% 향상된 결과로, 코드에 대한 강화 학습(RL)을 통해 연마된 추론 기술이 다른 도메인으로 효과적으로 전이될 수 있음을 시사합니다.
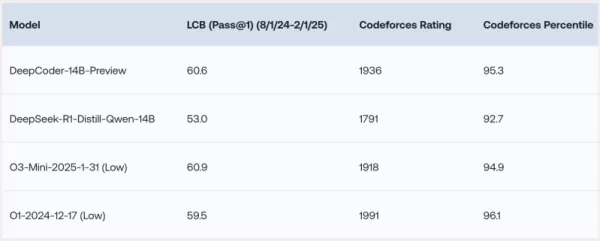
*출처: Together AI* DeepCoder-14B의 가장 흥미로운 특징은 그 효율성입니다. 140억 개의 파라미터만으로도 높은 성능을 달성하며, 다른 많은 선도 모델들보다 훨씬 작고 자원 효율적입니다.
DeepCoder 성공의 이면에 있는 혁신
DeepCoder-14B 개발에는 강화 학습을 사용한 코딩 모델 훈련에서 여러 가지 도전 과제를 극복하는 과정이 포함되었습니다. 주요 장애물 중 하나는 훈련 데이터의 선별이었습니다. 고품질의 검증 가능한 데이터가 풍부한 수학적 작업과 달리, 코딩 데이터는 부족할 수 있습니다. DeepCoder 팀은 다양한 데이터셋에서 예제를 수집하고 필터링하는 엄격한 파이프라인을 구현하여 유효성, 복잡성, 중복 방지를 보장함으로써 이를 해결했습니다. 이 과정은 RL 훈련을 위한 견고한 기반이 되는 24,000개의 고품질 문제를 만들어냈습니다.
팀은 또한 생성된 코드가 설정된 시간 제한 내에서 모든 샘플링된 단위 테스트를 성공적으로 통과할 경우에만 모델에 보상을 주는 간단한 보상 함수를 고안했습니다. 이러한 접근 방식은 고품질 훈련 예제와 결합하여 모델이 단축키를 활용하기보다는 핵심 문제를 해결하는 데 집중하도록 했습니다.
DeepCoder-14B의 훈련 알고리즘은 DeepSeek-R1에서 성공적이었던 Group Relative Policy Optimization(GRPO)을 기반으로 하지만, 팀은 안정성을 높이고 더 긴 훈련 기간을 가능하게 하기 위해 상당한 수정 작업을 수행했습니다.
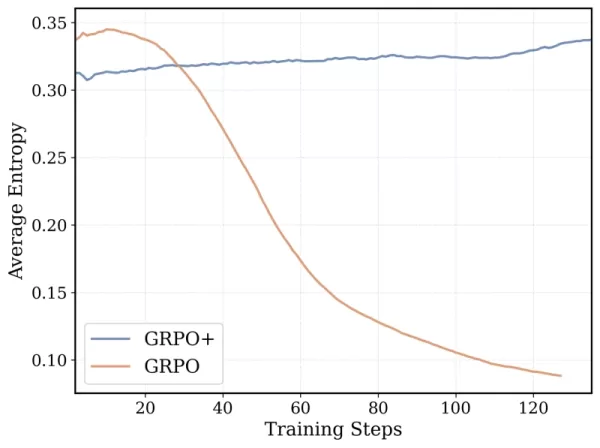
*GRPO+는 DeepCoder-14가 붕괴 없이 더 긴 기간 동안 지속할 수 있도록 합니다 출처: Together AI* 또한, 팀은 모델의 컨텍스트 창을 반복적으로 확장하여 짧은 시퀀스에서 시작해 점진적으로 늘려갔습니다. 또한 복잡한 프롬프트를 해결할 때 컨텍스트 제한을 초과하는 것에 대해 모델이 불이익을 받지 않도록 필터링 방법을 도입했습니다.
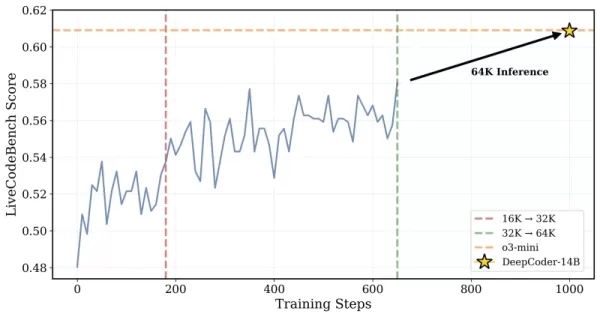
*DeepCoder는 32K 컨텍스트 문제로 훈련되었지만 64K 작업도 해결할 수 있었습니다 출처: Together AI* 연구진은 그들의 접근 방식을 이렇게 설명했습니다: “효율적인 훈련을 가능하게 하면서 장문 컨텍스트 추론을 보존하기 위해, 우리는 과도한 필터링을 포함했습니다… 이 기술은 훈련 중 잘린 시퀀스를 마스킹하여 모델이 현재 컨텍스트 제한을 초과하는 신중하지만 긴 출력을 생성하는 데 불이익을 받지 않도록 합니다.” 훈련은 16K에서 32K 컨텍스트 창으로 확장되어 최대 64K 토큰이 필요한 문제를 해결할 수 있게 했습니다.
장문 컨텍스트 RL 훈련 최적화
코딩과 같이 긴 시퀀스를 생성하는 작업에 RL로 대규모 모델을 훈련시키는 것은 매우 느리고 자원 집약적입니다. 모델이 예제당 수천 개의 토큰을 생성하는 샘플링 단계는 응답 길이의 다양성으로 인해 상당한 지연을 초래합니다.
이를 해결하기 위해 팀은 인간 피드백으로부터의 강화 학습(RLHF)을 위한 오픈 소스 verl 라이브러리의 최적화된 확장인 verl-pipeline을 개발했습니다. 그들의 “One-Off Pipelining” 혁신은 샘플링과 모델 업데이트를 재구성하여 병목 현상을 최소화하고 가속기의 유휴 시간을 줄였습니다.
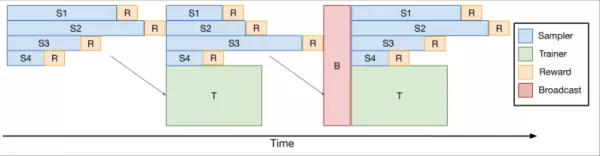
*One-Off Pipelining* 그들의 실험은 one-off pipelining이 표준 방법에 비해 코딩 RL 작업을 최대 2배까지 가속화할 수 있음을 보여주었습니다. 이 최적화는 DeepCoder-14B를 합리적인 시간 내(32개의 H100에서 2.5주)에 훈련시키는 데 결정적이었으며, 이제 커뮤니티가 활용할 수 있도록 verl-pipeline의 일부로 오픈 소스화되었습니다.
기업 영향과 오픈 소스 협업
연구진은 DeepCoder-14B의 모든 훈련 및 운영 아티팩트를 GitHub와 Hugging Face에 허용 라이선스로 공개했습니다. “우리의 데이터셋, 코드, 훈련 레시피를 완전히 공유함으로써, 우리는 커뮤니티가 우리의 작업을 재현하고 RL 훈련을 모두에게 접근 가능하게 할 수 있도록 힘을 실어줍니다”라고 그들은 밝혔습니다.
DeepCoder-14B는 AI 환경에서 효율적이고 공개적으로 접근 가능한 모델의 증가 추세를 잘 보여줍니다. 기업에게 이는 고급 모델에 대한 더 많은 선택지와 더 큰 접근성을 의미합니다. 고성능 코드 생성과 추론은 더 이상 대기업이나 높은 API 비용을 지불하려는 이들에게만 독점적이지 않습니다. 이제 모든 규모의 조직이 이러한 기능을 활용하여 특정 요구에 맞는 솔루션을 맞춤화하고 안전하게 환경 내에서 배포할 수 있습니다.
이러한 변화는 AI 채택의 장벽을 낮추고 오픈 소스 협업에 의해 구동되는 보다 경쟁적이고 혁신적인 생태계를 촉진할 준비가 되어 있습니다.
관련 기사
 Base44, 방어력을 강화하는 고유 AI 모델을 vibe 코딩 플랫폼에 공개
Base44은 1년 전, 팀이 8명으로 구성되고 설립된 지 불과 6개월 된 상태였을 때 Wix로부터 8,000만 달러에 인수된 vibe 코딩 플랫폼으로, 이제 자연어를 사용하여 애플리케이션을 구축할 수 있도록 자체 AI 모델을 배포하기 시작했습니다.이러한 developments는 최첨단 모델이 모든 사용 사례에 최적인지, 그리고 외부 모델에 의존하는 기업들이 장기적인 방어력을 유지할 수 있는지에 대해 AI 커뮤니티가 논쟁을 벌이는 시점에 이루
바이엘, Iambic AI를 활용해 신약 개발 속도 높여
유르겐 에크하르트(Juergen Eckhardt) 박사는 바이엘 제약(Bayer Pharmaceuticals)의 사업 개발 및 라이선싱 부문 책임자로 재직 중이다.바이엘은 스페인 공장에서 진행 중인 대규모 탈탄소화 프로젝트와 더불어, 신약 개발을 위한 최첨단 AI 모델을 도입하기 위해 아이암빅 테라퓨틱스(Iambic Therapeutics)와 협력하고 있습
멀티버스 컴퓨팅, 무료 압축 생성형 AI 모델 출시
대규모 언어 모델은 상당한 과제에 직면해 있습니다: 바로 그 방대한 규모입니다. 스페인 스타트업 멀티버스 컴퓨팅(Multiverse Computing)은 최첨단 AI의 성능과 기업이 실질적으로 도입할 수 있는 수준 사이의 격차를 해소하기 위해 설계된 압축 모델을 개발함으로써 이 문제를 해결하고 있습니다.핵심 혁신은 양자 컴퓨팅 원리에서 영감을 받은 압축 기
관련 특별 주제 추천
암호
 리팩토링, 버그, 보안 취약점을 처리하는 GitHub 팀을 위한 AI 풀 리퀘스트 검토 도구
GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
 12 도구
 xix.ai
텍스트 음성 변환
자연스러운 음성 해설을 위한 최고의 AI 텍스트 음성 변환 도구
2026년 최신 최고 평점을 받은 자연스러운 음성 나레이션을 위한 AI 텍스트 음성 변환 도구가 XIX.AI에 소개됩니다! 이 엄선된 목록에는 실제 테스트를 거쳐 검증되었으며 매주 업데이트되는 순위를 바탕으로, 모든 사용 사례에 선명한 음성을 제공하는 강력하고 획기적인 옵션들이 포함되어 있습니다. 무료 버전과 유료 버전을 비교해 보고, 생산성을 즉시 높여줄 꼭 시도해 봐야 할 솔루션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
11 도구
xix.ai
만화 창작
연재 만화 챕터, 표지 및 홍보용 일러스트를 위한 AI 배경 생성기
2026년 최신 최고의 만화 AI 배경 생성기, 최고 평점 순위 공개! 이 엄선된 컬렉션은 고품질의 챕터 배경, 책 표지, 홍보용 일러스트 제작에 안성맞춤인, 판도를 바꿀 만큼 강력한 도구들을 소개합니다. 모든 옵션은 신뢰성을 보장하기 위해 엄격한 실제 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보와 함께 상세한 분석도 확인해 보세요. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아, 만화 제작에서 AI의 장점을 최대한 활용해 보세요.
6 도구
xix.ai
이미지 편집
AI 물체 제거 편집기: 인물 사진, 여행 사진, 제품 사진을 깔끔하게 정리하세요
2026년 최신 최고 평점을 받은 AI 물체 제거 편집기: 인물 사진, 여행 사진, 제품 사진에 최적! XIX.AI는 매주 랭킹을 업데이트하며, 판도를 바꿀 만큼 강력한 도구들을 엄선해 제공합니다. 이 도구들은 실제 테스트를 통해 원치 않는 요소를 빠르게 제거하고, 콘텐츠 품질을 높이며, 결과물의 품질을 떨어뜨리지 않으면서도 시간을 대폭 절약할 수 있도록 도와줍니다. AI 창작의 경쟁력을 한 단계 높이고 싶은 분이라면 꼭 사용해 보세요. 지금 바로 확인해 보세요!
10 도구
xix.ai
텍스트 음성 변환
온라인 강좌를 위한 최고의 AI 텍스트 음성 변환 도구
2026년 온라인 강좌용 최신 최고 평점 AI 텍스트 음성 변환 도구는 XIX.AI가 엄격한 실전 테스트와 매주 업데이트되는 순위를 바탕으로 엄선한 것입니다. 이 강력한 도구들은 콘텐츠 제작자가 손쉽게 선명한 오디오 콘텐츠를 제공할 수 있도록 도와주어, 글쓰기 효율을 높이고 강좌 제작 과정을 간소화합니다. 무료 버전과 유료 버전의 비교 정보를 확인하여 본인에게 가장 적합한 도구를 찾아보세요. 지금 바로 살펴보고 온라인 교육 분야에서 AI를 활용한 경쟁력을 확보하세요.
10 도구
xix.ai
글쓰기
더 높은 클릭률(CTR)을 위한 AI 블로그 제목 도구
2026년 최신 최고의 상위 평가 AI 블로그 제목 도구로 클릭률 높이기! XIX.AI는 엄격한 실제 테스트를 거친 강력한 게임 체인저 모음의 상위 도구를 신중하게 선별했습니다. 무료 대 유료 비교, 매주 업데이트되는 순위, 블로그 트래픽을 효율적으로 증대하는 데 도움이 되는 상세한 통찰력을 찾을 수 있습니다. AI 경쟁력을 unlocking하는 데 도움이 되는 필수 옵션이 강조되어 있습니다. 지금 탐색하세요!
10 도구
xix.ai

 의견 (14)
0/500
![RyanTaylor]()
Interesting! I've been following the open-source vs. proprietary model race. DeepCoder-14B matching o3-mini is a big deal for accessibility. Hope this pushes the big players to open up more, or at least lower their prices. The compute cost for training these 14B models must be insane though. 🤔
![FrankRodriguez]()
Wow, DeepCoder-14B sounds like a game-changer! I'm stoked to see open-source models catching up to the big players. Can't wait to try it out for my side projects—hope it’s as fast as they claim! 🚀
![GregoryBaker]()
DeepCoder-14B sounds like a game-changer! Can't wait to try it out and see how it stacks up against the big players. 🚀
![BillyLewis]()
Wow, DeepCoder-14B sounds like a game-changer for open-source coding! I'm curious how it stacks up against o3-mini in real-world projects. Anyone tried it yet? 🚀
![RaymondWalker]()
¡DeepCoder-14B es una locura! Un modelo de código abierto que compite con los grandes. ¿Será el fin de los modelos propietarios? 🤔
![RalphGarcia]()
DeepCoder-14B、めっちゃ面白そう!😊 オープンソースでここまでできるなんて、コーディングの未来が楽しみ!
DeepCoder-14B 소개: 오픈 소스 코딩 모델의 새로운 지평
Together AI와 Agentica의 팀은 DeepCoder-14B를 공개했습니다. 이는 OpenAI의 o3-mini와 같은 최고 수준의 독점 모델과 어깨를 나란히 하는 획기적인 코딩 모델입니다. 이 흥미로운 개발은 DeepSeek-R1을 기반으로 하며, 고성능 코드 생성 및 추론을 실제 응용 프로그램에 통합할 수 있는 향상된 유연성을 제공합니다. 더욱이, 제작자들은 모델을 완전히 오픈 소스로 공개하며 훈련 데이터, 코드, 로그, 시스템 최적화를 포함하는 훌륭한 조치를 취했습니다. 이 결정은 연구를 촉진하고 해당 분야의 발전을 가속화할 것입니다.
컴팩트한 패키지에서의 인상적인 성능
DeepCoder-14B는 LiveCodeBench(LCB), Codeforces, HumanEval+와 같은 다양한 코딩 벤치마크에서 놀라운 결과를 보여주었습니다. 연구팀의 실험은 이 모델의 성능이 o3-mini(낮음) 및 o1과 같은 선도 모델들과 동등하다는 것을 강조했습니다. 연구진은 블로그 포스트에서 “우리 모델은 모든 코딩 벤치마크에서 강력한 성능을 보여주며… o3-mini(낮음) 및 o1의 성능과 비슷하다”고 자랑스럽게 밝혔습니다.
특히 흥미로운 점은 주로 코딩 작업에 훈련되었음에도 불구하고, DeepCoder-14B는 수학적 추론에서도 주목할 만한 향상을 보여 AIME 2024 벤치마크에서 73.8%의 점수를 달성했습니다. 이는 기본 모델인 DeepSeek-R1-Distill-Qwen-14B보다 4.1% 향상된 결과로, 코드에 대한 강화 학습(RL)을 통해 연마된 추론 기술이 다른 도메인으로 효과적으로 전이될 수 있음을 시사합니다.
DeepCoder-14B의 가장 흥미로운 특징은 그 효율성입니다. 140억 개의 파라미터만으로도 높은 성능을 달성하며, 다른 많은 선도 모델들보다 훨씬 작고 자원 효율적입니다.
DeepCoder 성공의 이면에 있는 혁신
DeepCoder-14B 개발에는 강화 학습을 사용한 코딩 모델 훈련에서 여러 가지 도전 과제를 극복하는 과정이 포함되었습니다. 주요 장애물 중 하나는 훈련 데이터의 선별이었습니다. 고품질의 검증 가능한 데이터가 풍부한 수학적 작업과 달리, 코딩 데이터는 부족할 수 있습니다. DeepCoder 팀은 다양한 데이터셋에서 예제를 수집하고 필터링하는 엄격한 파이프라인을 구현하여 유효성, 복잡성, 중복 방지를 보장함으로써 이를 해결했습니다. 이 과정은 RL 훈련을 위한 견고한 기반이 되는 24,000개의 고품질 문제를 만들어냈습니다.
팀은 또한 생성된 코드가 설정된 시간 제한 내에서 모든 샘플링된 단위 테스트를 성공적으로 통과할 경우에만 모델에 보상을 주는 간단한 보상 함수를 고안했습니다. 이러한 접근 방식은 고품질 훈련 예제와 결합하여 모델이 단축키를 활용하기보다는 핵심 문제를 해결하는 데 집중하도록 했습니다.
DeepCoder-14B의 훈련 알고리즘은 DeepSeek-R1에서 성공적이었던 Group Relative Policy Optimization(GRPO)을 기반으로 하지만, 팀은 안정성을 높이고 더 긴 훈련 기간을 가능하게 하기 위해 상당한 수정 작업을 수행했습니다.
또한, 팀은 모델의 컨텍스트 창을 반복적으로 확장하여 짧은 시퀀스에서 시작해 점진적으로 늘려갔습니다. 또한 복잡한 프롬프트를 해결할 때 컨텍스트 제한을 초과하는 것에 대해 모델이 불이익을 받지 않도록 필터링 방법을 도입했습니다.
연구진은 그들의 접근 방식을 이렇게 설명했습니다: “효율적인 훈련을 가능하게 하면서 장문 컨텍스트 추론을 보존하기 위해, 우리는 과도한 필터링을 포함했습니다… 이 기술은 훈련 중 잘린 시퀀스를 마스킹하여 모델이 현재 컨텍스트 제한을 초과하는 신중하지만 긴 출력을 생성하는 데 불이익을 받지 않도록 합니다.” 훈련은 16K에서 32K 컨텍스트 창으로 확장되어 최대 64K 토큰이 필요한 문제를 해결할 수 있게 했습니다.
장문 컨텍스트 RL 훈련 최적화
코딩과 같이 긴 시퀀스를 생성하는 작업에 RL로 대규모 모델을 훈련시키는 것은 매우 느리고 자원 집약적입니다. 모델이 예제당 수천 개의 토큰을 생성하는 샘플링 단계는 응답 길이의 다양성으로 인해 상당한 지연을 초래합니다.
이를 해결하기 위해 팀은 인간 피드백으로부터의 강화 학습(RLHF)을 위한 오픈 소스 verl 라이브러리의 최적화된 확장인 verl-pipeline을 개발했습니다. 그들의 “One-Off Pipelining” 혁신은 샘플링과 모델 업데이트를 재구성하여 병목 현상을 최소화하고 가속기의 유휴 시간을 줄였습니다.
그들의 실험은 one-off pipelining이 표준 방법에 비해 코딩 RL 작업을 최대 2배까지 가속화할 수 있음을 보여주었습니다. 이 최적화는 DeepCoder-14B를 합리적인 시간 내(32개의 H100에서 2.5주)에 훈련시키는 데 결정적이었으며, 이제 커뮤니티가 활용할 수 있도록 verl-pipeline의 일부로 오픈 소스화되었습니다.
기업 영향과 오픈 소스 협업
연구진은 DeepCoder-14B의 모든 훈련 및 운영 아티팩트를 GitHub와 Hugging Face에 허용 라이선스로 공개했습니다. “우리의 데이터셋, 코드, 훈련 레시피를 완전히 공유함으로써, 우리는 커뮤니티가 우리의 작업을 재현하고 RL 훈련을 모두에게 접근 가능하게 할 수 있도록 힘을 실어줍니다”라고 그들은 밝혔습니다.
DeepCoder-14B는 AI 환경에서 효율적이고 공개적으로 접근 가능한 모델의 증가 추세를 잘 보여줍니다. 기업에게 이는 고급 모델에 대한 더 많은 선택지와 더 큰 접근성을 의미합니다. 고성능 코드 생성과 추론은 더 이상 대기업이나 높은 API 비용을 지불하려는 이들에게만 독점적이지 않습니다. 이제 모든 규모의 조직이 이러한 기능을 활용하여 특정 요구에 맞는 솔루션을 맞춤화하고 안전하게 환경 내에서 배포할 수 있습니다.
이러한 변화는 AI 채택의 장벽을 낮추고 오픈 소스 협업에 의해 구동되는 보다 경쟁적이고 혁신적인 생태계를 촉진할 준비가 되어 있습니다.








 Base44, 방어력을 강화하는 고유 AI 모델을 vibe 코딩 플랫폼에 공개
Base44은 1년 전, 팀이 8명으로 구성되고 설립된 지 불과 6개월 된 상태였을 때 Wix로부터 8,000만 달러에 인수된 vibe 코딩 플랫폼으로, 이제 자연어를 사용하여 애플리케이션을 구축할 수 있도록 자체 AI 모델을 배포하기 시작했습니다.이러한 developments는 최첨단 모델이 모든 사용 사례에 최적인지, 그리고 외부 모델에 의존하는 기업들이 장기적인 방어력을 유지할 수 있는지에 대해 AI 커뮤니티가 논쟁을 벌이는 시점에 이루
 바이엘, Iambic AI를 활용해 신약 개발 속도 높여
유르겐 에크하르트(Juergen Eckhardt) 박사는 바이엘 제약(Bayer Pharmaceuticals)의 사업 개발 및 라이선싱 부문 책임자로 재직 중이다.바이엘은 스페인 공장에서 진행 중인 대규모 탈탄소화 프로젝트와 더불어, 신약 개발을 위한 최첨단 AI 모델을 도입하기 위해 아이암빅 테라퓨틱스(Iambic Therapeutics)와 협력하고 있습
 멀티버스 컴퓨팅, 무료 압축 생성형 AI 모델 출시
대규모 언어 모델은 상당한 과제에 직면해 있습니다: 바로 그 방대한 규모입니다. 스페인 스타트업 멀티버스 컴퓨팅(Multiverse Computing)은 최첨단 AI의 성능과 기업이 실질적으로 도입할 수 있는 수준 사이의 격차를 해소하기 위해 설계된 압축 모델을 개발함으로써 이 문제를 해결하고 있습니다.핵심 혁신은 양자 컴퓨팅 원리에서 영감을 받은 압축 기

GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
12 도구
xix.ai

2026년 최신 최고 평점을 받은 자연스러운 음성 나레이션을 위한 AI 텍스트 음성 변환 도구가 XIX.AI에 소개됩니다! 이 엄선된 목록에는 실제 테스트를 거쳐 검증되었으며 매주 업데이트되는 순위를 바탕으로, 모든 사용 사례에 선명한 음성을 제공하는 강력하고 획기적인 옵션들이 포함되어 있습니다. 무료 버전과 유료 버전을 비교해 보고, 생산성을 즉시 높여줄 꼭 시도해 봐야 할 솔루션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
11 도구
xix.ai

2026년 최신 최고의 만화 AI 배경 생성기, 최고 평점 순위 공개! 이 엄선된 컬렉션은 고품질의 챕터 배경, 책 표지, 홍보용 일러스트 제작에 안성맞춤인, 판도를 바꿀 만큼 강력한 도구들을 소개합니다. 모든 옵션은 신뢰성을 보장하기 위해 엄격한 실제 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보와 함께 상세한 분석도 확인해 보세요. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아, 만화 제작에서 AI의 장점을 최대한 활용해 보세요.
6 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 물체 제거 편집기: 인물 사진, 여행 사진, 제품 사진에 최적! XIX.AI는 매주 랭킹을 업데이트하며, 판도를 바꿀 만큼 강력한 도구들을 엄선해 제공합니다. 이 도구들은 실제 테스트를 통해 원치 않는 요소를 빠르게 제거하고, 콘텐츠 품질을 높이며, 결과물의 품질을 떨어뜨리지 않으면서도 시간을 대폭 절약할 수 있도록 도와줍니다. AI 창작의 경쟁력을 한 단계 높이고 싶은 분이라면 꼭 사용해 보세요. 지금 바로 확인해 보세요!
10 도구
xix.ai

2026년 온라인 강좌용 최신 최고 평점 AI 텍스트 음성 변환 도구는 XIX.AI가 엄격한 실전 테스트와 매주 업데이트되는 순위를 바탕으로 엄선한 것입니다. 이 강력한 도구들은 콘텐츠 제작자가 손쉽게 선명한 오디오 콘텐츠를 제공할 수 있도록 도와주어, 글쓰기 효율을 높이고 강좌 제작 과정을 간소화합니다. 무료 버전과 유료 버전의 비교 정보를 확인하여 본인에게 가장 적합한 도구를 찾아보세요. 지금 바로 살펴보고 온라인 교육 분야에서 AI를 활용한 경쟁력을 확보하세요.
10 도구
xix.ai

2026년 최신 최고의 상위 평가 AI 블로그 제목 도구로 클릭률 높이기! XIX.AI는 엄격한 실제 테스트를 거친 강력한 게임 체인저 모음의 상위 도구를 신중하게 선별했습니다. 무료 대 유료 비교, 매주 업데이트되는 순위, 블로그 트래픽을 효율적으로 증대하는 데 도움이 되는 상세한 통찰력을 찾을 수 있습니다. AI 경쟁력을 unlocking하는 데 도움이 되는 필수 옵션이 강조되어 있습니다. 지금 탐색하세요!
10 도구
xix.ai

Interesting! I've been following the open-source vs. proprietary model race. DeepCoder-14B matching o3-mini is a big deal for accessibility. Hope this pushes the big players to open up more, or at least lower their prices. The compute cost for training these 14B models must be insane though. 🤔
Wow, DeepCoder-14B sounds like a game-changer! I'm stoked to see open-source models catching up to the big players. Can't wait to try it out for my side projects—hope it’s as fast as they claim! 🚀
DeepCoder-14B sounds like a game-changer! Can't wait to try it out and see how it stacks up against the big players. 🚀
Wow, DeepCoder-14B sounds like a game-changer for open-source coding! I'm curious how it stacks up against o3-mini in real-world projects. Anyone tried it yet? 🚀
¡DeepCoder-14B es una locura! Un modelo de código abierto que compite con los grandes. ¿Será el fin de los modelos propietarios? 🤔
DeepCoder-14B、めっちゃ面白そう!😊 オープンソースでここまでできるなんて、コーディングの未来が楽しみ!












