


 首頁
Deep Cogito的LLMS使用IDA優於類似大小的模型
Deep Cogito,一家總部位於舊金山的企業,正在人工智慧社群中掀起波瀾,其最新發布的開放大型語言模型(LLMs)備受矚目。這些模型參數規模從30億到700億不等,不僅僅是另一組AI工具;它們是該公司所稱的「通用超級智能」的重要一步。Deep Cogito聲稱,其每個模型在大多數標準基準測試中均超越同等規模的領先開放模型,包括來自LLAMA、DeepSeek和Qwen的模型。這是一個相當大的主張,但更令人印象深刻的是,他們的700億參數模型據報在性能上超越了最近發布的Llama 4 109B混合專家(MoE)模型。
迭代蒸餾與放大(IDA)
Deep Cogito的突破核心在於一種他們稱為迭代蒸餾與放大(IDA)的新訓練方法。該方法被描述為「一種可擴展且高效的通用超級智能對齊策略,通過迭代自我改進實現」。它旨在突破傳統LLM訓練的限制,在傳統方法中,模型的智能通常受到較大的「監督者」模型或人類策展者的上限限制。
IDA過程圍繞兩個反覆進行的關鍵步驟:
- 放大:此步驟利用更多計算能力幫助模型提出更好的解決方案或能力,類似於高級推理技術。
- 蒸餾:在此,模型內化這些改進的能力,優化其參數。
Deep Cogito認為,這創造了一個「正向反饋循環」,使模型的智能能夠隨著計算資源和IDA過程本身的效率更直接地增長,而不受監督者智能的限制。
該公司指出像AlphaGo這樣的歷史成功案例,強調「高級推理和迭代自我改進」至關重要。他們聲稱,IDA將這些元素引入LLM訓練。他們還強調IDA的效率,指出他們的小型團隊僅用大約75天就開發出這些模型。與其他方法如基於人類反饋的強化學習(RLHF)或從較大模型的標準蒸餾相比,IDA據稱提供更好的可擴展性。
作為證明,Deep Cogito強調其700億參數模型在性能上超越了Llama 3.3 70B(從405B模型蒸餾)和Llama 4 Scout 109B(從2T參數模型蒸餾)。
Deep Cogito模型的能力與性能
新的Cogito模型以Llama和Qwen檢查點為基礎,專為編碼、函數調用和代理應用量身定制。一個突出特點是它們的雙重功能:「每個模型都可以直接回答(標準LLM),或在回答前進行自我反思(類似推理模型)」。這與Claude 3.5等模型的功能相似。然而,Deep Cogito提到他們尚未專注於非常長的推理鏈,優先考慮更快的回答和蒸餾較短鏈的效率。
該公司分享了廣泛的基準測試結果,將其Cogito模型與同等規模的最新開放模型在直接和推理模式下進行比較。在MMLU、MMLU-Pro、ARC、GSM8K和MATH等一系列基準測試中,以及不同模型規模(3B、8B、14B、32B、70B)中,Cogito模型通常顯示出顯著的性能提升。例如,Cogito 70B模型在標準模式下的MMLU得分為91.73%,比Llama 3.3 70B提高+6.40%,在思考模式下得分為91.00%,比Deepseek R1 Distill 70B提高+4.40%。Livebench得分也反映了這些進展。
以下是14B模型的基準測試,用於中等規模比較:
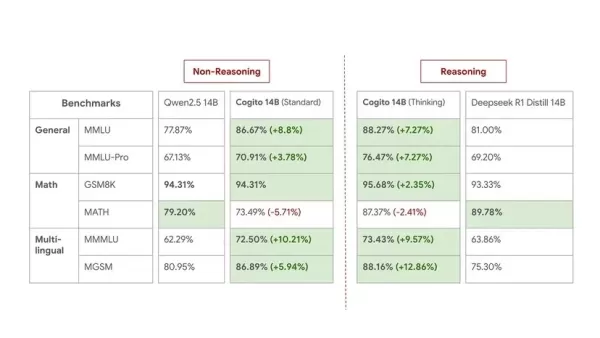
雖然Deep Cogito承認基準測試無法完全反映現實世界的實用性,但他們對模型的實際性能仍充滿信心。此次發布被視為預覽,公司表示他們「仍處於這一擴展曲線的早期階段」。他們計劃在未來幾週和幾個月內發布當前規模的改進檢查點,並引入更大的MoE模型(109B、400B、671B)。所有未來模型也將是開源的。
相關文章
 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10
相關專題推薦
數據分析
 適用於 SaaS 和電商團隊的 KPI 監控最佳 AI 異常檢測工具
2026 年最新最佳頂級評分 AI 異常檢測工具,助力 SaaS 和電商團隊的 KPI 監控!XIX.AI 基於嚴格的真實世界測試和每週更新的排名,精心策劃了一套強大且顛覆性的工具合集。您將找到詳細的免費與付費對比洞察,幫助您識別必須嘗試的解決方案,從而提升生產力並釋放您的 AI 優勢。立即探索!
 10 個工具
 xix.ai
寫作
最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

 評論 (29)
0/500
![FrankMoore]()
看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
![HenryJackson]()
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
![RoyWhite]()
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
![PaulThomas]()
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
![GregoryCarter]()
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
![EricRoberts]()
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡
Deep Cogito,一家總部位於舊金山的企業,正在人工智慧社群中掀起波瀾,其最新發布的開放大型語言模型(LLMs)備受矚目。這些模型參數規模從30億到700億不等,不僅僅是另一組AI工具;它們是該公司所稱的「通用超級智能」的重要一步。Deep Cogito聲稱,其每個模型在大多數標準基準測試中均超越同等規模的領先開放模型,包括來自LLAMA、DeepSeek和Qwen的模型。這是一個相當大的主張,但更令人印象深刻的是,他們的700億參數模型據報在性能上超越了最近發布的Llama 4 109B混合專家(MoE)模型。
迭代蒸餾與放大(IDA)
Deep Cogito的突破核心在於一種他們稱為迭代蒸餾與放大(IDA)的新訓練方法。該方法被描述為「一種可擴展且高效的通用超級智能對齊策略,通過迭代自我改進實現」。它旨在突破傳統LLM訓練的限制,在傳統方法中,模型的智能通常受到較大的「監督者」模型或人類策展者的上限限制。
IDA過程圍繞兩個反覆進行的關鍵步驟:
- 放大:此步驟利用更多計算能力幫助模型提出更好的解決方案或能力,類似於高級推理技術。
- 蒸餾:在此,模型內化這些改進的能力,優化其參數。
Deep Cogito認為,這創造了一個「正向反饋循環」,使模型的智能能夠隨著計算資源和IDA過程本身的效率更直接地增長,而不受監督者智能的限制。
該公司指出像AlphaGo這樣的歷史成功案例,強調「高級推理和迭代自我改進」至關重要。他們聲稱,IDA將這些元素引入LLM訓練。他們還強調IDA的效率,指出他們的小型團隊僅用大約75天就開發出這些模型。與其他方法如基於人類反饋的強化學習(RLHF)或從較大模型的標準蒸餾相比,IDA據稱提供更好的可擴展性。
作為證明,Deep Cogito強調其700億參數模型在性能上超越了Llama 3.3 70B(從405B模型蒸餾)和Llama 4 Scout 109B(從2T參數模型蒸餾)。
Deep Cogito模型的能力與性能
新的Cogito模型以Llama和Qwen檢查點為基礎,專為編碼、函數調用和代理應用量身定制。一個突出特點是它們的雙重功能:「每個模型都可以直接回答(標準LLM),或在回答前進行自我反思(類似推理模型)」。這與Claude 3.5等模型的功能相似。然而,Deep Cogito提到他們尚未專注於非常長的推理鏈,優先考慮更快的回答和蒸餾較短鏈的效率。
該公司分享了廣泛的基準測試結果,將其Cogito模型與同等規模的最新開放模型在直接和推理模式下進行比較。在MMLU、MMLU-Pro、ARC、GSM8K和MATH等一系列基準測試中,以及不同模型規模(3B、8B、14B、32B、70B)中,Cogito模型通常顯示出顯著的性能提升。例如,Cogito 70B模型在標準模式下的MMLU得分為91.73%,比Llama 3.3 70B提高+6.40%,在思考模式下得分為91.00%,比Deepseek R1 Distill 70B提高+4.40%。Livebench得分也反映了這些進展。
以下是14B模型的基準測試,用於中等規模比較:
雖然Deep Cogito承認基準測試無法完全反映現實世界的實用性,但他們對模型的實際性能仍充滿信心。此次發布被視為預覽,公司表示他們「仍處於這一擴展曲線的早期階段」。他們計劃在未來幾週和幾個月內發布當前規模的改進檢查點,並引入更大的MoE模型(109B、400B、671B)。所有未來模型也將是開源的。







 Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
 奧利押注隱私保護,力爭在 AI 助理競賽中勝出
要真正發揮實用價值,人工智慧助理必須深入了解其使用者。Ollie 是一款專為日常生活設計的個人助理,其運作前提是:這無需您交出個人資料,亦不會損害您的隱私。雖然某些企業級 AI 工具提供資料隱私保障,但 Ollie 作為首批獲得 SOC 2 合規認證的主流、以家庭為導向的 AI 服務之一,顯得格外突出。此框架允許企業透過獨立稽核證明,其已建立正式的管控措施來保護客戶資料,並確保系統運作的安全性。達
 「AI LIVE:倫敦」將如何探討人工智慧與工業自動化
本次峰會將匯聚來自全球的高階主管,共同探討全球產業面臨的迫切挑戰,涵蓋範圍從人工智慧驅動的顛覆性變革到經濟波動。AI LIVE:倫敦峰會將以「科技+人類使命」為主題,匯聚逾 2,000 位國際領袖,共同探討人工智慧新興時代的發展。隸屬於 BizClik 旗下的《AI Magazine》已公佈其於「AI LIVE:倫敦峰會」上舉辦的「人工智慧與工業自動化」聯合爐邊談話的與會陣容。該座談會定於 10

2026 年最新最佳頂級評分 AI 異常檢測工具,助力 SaaS 和電商團隊的 KPI 監控!XIX.AI 基於嚴格的真實世界測試和每週更新的排名,精心策劃了一套強大且顛覆性的工具合集。您將找到詳細的免費與付費對比洞察,幫助您識別必須嘗試的解決方案,從而提升生產力並釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡












