


 家
Deep CogitoのLLMSは、IDAを使用して同様のサイズのモデルよりも優れています
ディープ・コジトは、サンフランシスコに拠点を置く企業で、最新のオープン大規模言語モデル(LLMs)のリリースによりAIコミュニティで注目を集めています。これらのモデルは、30億から700億のパラメータに至るさまざまなサイズがあり、単なるAIツールのセットではありません。企業が「一般超知能」と呼ぶものに向けた大胆な一歩です。ディープ・コジトは、彼らの各モデルが、LLAMA、DeepSeek、Qwenなどの同規模の主要なオープンモデルを、ほとんどの標準ベンチマークで上回ると主張しています。これは大胆な主張ですが、さらに印象的なのは、彼らの700億パラメータモデルが、最近リリースされたLlama 4 109B Mixture-of-Experts(MoE)モデルを上回ったと報告されていることです。
反復蒸留と増幅(IDA)
ディープ・コジトの画期的な成果の中心には、彼らが反復蒸留と増幅(IDA)と呼ぶ新しいトレーニングアプローチがあります。この方法は、「反復的自己改善を用いた一般超知能のためのスケーラブルで効率的な整合戦略」と説明されています。従来のLLMトレーニングの限界を打破する設計で、モデルの知能がより大きな「監督者」モデルや人間のキュレーターによって定義された上限に達してしまう問題を克服します。
IDAプロセスは、繰り返し行われる2つの主要なステップを中心に展開します:
- 増幅:このステップでは、より多くの計算能力を使用して、モデルがより優れた解決策や能力を生み出すのを助け、高度な推論技術に似ています。
- 蒸留:ここでは、モデルがこれらの改善された能力を内面化し、パラメータを洗練させます。
ディープ・コジトは、これにより「正のフィードバックループ」が作成され、モデルの知能が監督者の知能に制限されることなく、計算リソースとIDAプロセスの効率によってより直接的に成長すると主張しています。
同社は、AlphaGoのような歴史的な成功例を挙げ、「高度な推論と反復的自己改善」が重要だったと強調しています。IDAは、これらの要素をLLMトレーニングにもたらすと彼らは主張します。また、IDAの効率性も強調し、小規模なチームでありながら、約75日でこれらのモデルを開発できたと述べています。人間のフィードバックからの強化学習(RLHF)や、より大きなモデルからの標準的な蒸留といった他の方法と比較して、IDAはより優れたスケーラビリティを提供するとされています。
証拠として、ディープ・コジトは、彼らの700億モデルが、Llama 3.3 70B(4050億モデルから蒸留)とLlama 4 Scout 109B(2兆パラメータモデルから蒸留)の両方を上回っていることを強調しています。
ディープ・コジトモデルの能力と性能
新しいコジトモデルは、LlamaとQwenのチェックポイントを基に構築されており、コーディング、関数呼び出し、エージェント型アプリケーション向けに調整されています。際立った特徴は、2つの機能性です:「各モデルは直接回答(標準LLM)でき、または回答前に自己反省(推論モデルのように)できます。」これは、Claude 3.5のようなモデルで見られる能力を反映しています。ただし、ディープ・コジトは、非常に長い推論チェーンには焦点を当てておらず、より速い回答と短いチェーンの蒸留の効率を優先していると述べています。
同社は、直接モードと推論モードの両方で、サイズ相当の最先端のオープンモデルに対するコジトモデルの広範なベンチマーク結果を共有しています。MMLU、MMLU-Pro、ARC、GSM8K、MATHなどのさまざまなベンチマークや、異なるモデルサイズ(3B、8B、14B、32B、70B)で、コジトモデルは一般的に大幅な性能向上を示しています。たとえば、コジト700億モデルは、標準モードでMMLUで91.73%を記録し、Llama 3.3 70Bに対して+6.40%の改善、思考モードでは91.00%で、Deepseek R1 Distill 70Bに対して+4.40%の向上を示しています。Livebenchのスコアもこれらの向上を反映しています。
14Bモデルのベンチマークを中規模比較として以下に示します:
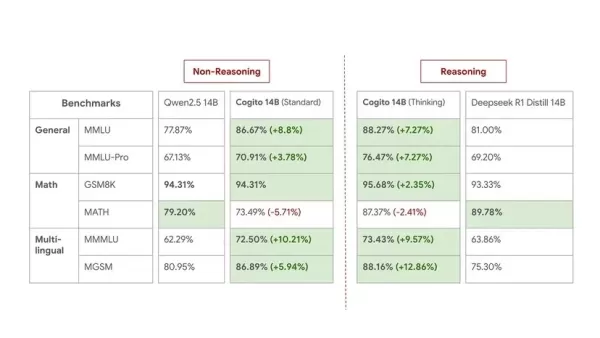
ディープ・コジトは、ベンチマークが実際の有用性を完全に捉えるものではないと認めつつも、モデルの実際の性能に自信を持っています。このリリースはプレビューとされており、同社は「このスケーリングカーブの初期段階にある」と述べています。彼らは現在のサイズの改善されたチェックポイントをリリースし、今後数週間から数か月でより大きなMoEモデル(109B、400B、671B)を導入する予定です。すべての将来のモデルもオープンソースになる予定です。
関連記事
 Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
オリー社、AIアシスタント競争で優位に立つためプライバシー重視を掲げる
真に役立つAIアシスタントであるためには、ユーザーを深く理解する必要があります。日常生活向けに設計されたパーソナルアシスタント「Ollie」は、そのためにデータを明け渡したり、プライバシーを犠牲にしたりする必要はないという前提で動作します。一部のエンタープライズ向けAIツールにはデータプライバシー保護措置が講じられていますが、OllieはSOC 2準拠を達成した、一般家庭向けのAIサービスとしては
「AI LIVE: London」がAIと産業オートメーションをどのように掘り下げるか
このサミットには、世界中から経営幹部が集まり、AIによる変革から経済の変動性に至るまで、世界の産業が直面する喫緊の課題について議論します。「AI LIVE: The London Summit」では、「テクノロジー+人間の目的」をテーマに、2,000名を超える国際的なリーダーが一堂に会し、人工知能の新たな時代について検討を行います。BizClik傘下の『AI Magazine』は、「AI LIVE
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (29)
0/500
![FrankMoore]()
看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
![HenryJackson]()
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
![RoyWhite]()
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
![PaulThomas]()
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
![GregoryCarter]()
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
![EricRoberts]()
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡
ディープ・コジトは、サンフランシスコに拠点を置く企業で、最新のオープン大規模言語モデル(LLMs)のリリースによりAIコミュニティで注目を集めています。これらのモデルは、30億から700億のパラメータに至るさまざまなサイズがあり、単なるAIツールのセットではありません。企業が「一般超知能」と呼ぶものに向けた大胆な一歩です。ディープ・コジトは、彼らの各モデルが、LLAMA、DeepSeek、Qwenなどの同規模の主要なオープンモデルを、ほとんどの標準ベンチマークで上回ると主張しています。これは大胆な主張ですが、さらに印象的なのは、彼らの700億パラメータモデルが、最近リリースされたLlama 4 109B Mixture-of-Experts(MoE)モデルを上回ったと報告されていることです。
反復蒸留と増幅(IDA)
ディープ・コジトの画期的な成果の中心には、彼らが反復蒸留と増幅(IDA)と呼ぶ新しいトレーニングアプローチがあります。この方法は、「反復的自己改善を用いた一般超知能のためのスケーラブルで効率的な整合戦略」と説明されています。従来のLLMトレーニングの限界を打破する設計で、モデルの知能がより大きな「監督者」モデルや人間のキュレーターによって定義された上限に達してしまう問題を克服します。
IDAプロセスは、繰り返し行われる2つの主要なステップを中心に展開します:
- 増幅:このステップでは、より多くの計算能力を使用して、モデルがより優れた解決策や能力を生み出すのを助け、高度な推論技術に似ています。
- 蒸留:ここでは、モデルがこれらの改善された能力を内面化し、パラメータを洗練させます。
ディープ・コジトは、これにより「正のフィードバックループ」が作成され、モデルの知能が監督者の知能に制限されることなく、計算リソースとIDAプロセスの効率によってより直接的に成長すると主張しています。
同社は、AlphaGoのような歴史的な成功例を挙げ、「高度な推論と反復的自己改善」が重要だったと強調しています。IDAは、これらの要素をLLMトレーニングにもたらすと彼らは主張します。また、IDAの効率性も強調し、小規模なチームでありながら、約75日でこれらのモデルを開発できたと述べています。人間のフィードバックからの強化学習(RLHF)や、より大きなモデルからの標準的な蒸留といった他の方法と比較して、IDAはより優れたスケーラビリティを提供するとされています。
証拠として、ディープ・コジトは、彼らの700億モデルが、Llama 3.3 70B(4050億モデルから蒸留)とLlama 4 Scout 109B(2兆パラメータモデルから蒸留)の両方を上回っていることを強調しています。
ディープ・コジトモデルの能力と性能
新しいコジトモデルは、LlamaとQwenのチェックポイントを基に構築されており、コーディング、関数呼び出し、エージェント型アプリケーション向けに調整されています。際立った特徴は、2つの機能性です:「各モデルは直接回答(標準LLM)でき、または回答前に自己反省(推論モデルのように)できます。」これは、Claude 3.5のようなモデルで見られる能力を反映しています。ただし、ディープ・コジトは、非常に長い推論チェーンには焦点を当てておらず、より速い回答と短いチェーンの蒸留の効率を優先していると述べています。
同社は、直接モードと推論モードの両方で、サイズ相当の最先端のオープンモデルに対するコジトモデルの広範なベンチマーク結果を共有しています。MMLU、MMLU-Pro、ARC、GSM8K、MATHなどのさまざまなベンチマークや、異なるモデルサイズ(3B、8B、14B、32B、70B)で、コジトモデルは一般的に大幅な性能向上を示しています。たとえば、コジト700億モデルは、標準モードでMMLUで91.73%を記録し、Llama 3.3 70Bに対して+6.40%の改善、思考モードでは91.00%で、Deepseek R1 Distill 70Bに対して+4.40%の向上を示しています。Livebenchのスコアもこれらの向上を反映しています。
14Bモデルのベンチマークを中規模比較として以下に示します:
ディープ・コジトは、ベンチマークが実際の有用性を完全に捉えるものではないと認めつつも、モデルの実際の性能に自信を持っています。このリリースはプレビューとされており、同社は「このスケーリングカーブの初期段階にある」と述べています。彼らは現在のサイズの改善されたチェックポイントをリリースし、今後数週間から数か月でより大きなMoEモデル(109B、400B、671B)を導入する予定です。すべての将来のモデルもオープンソースになる予定です。







 Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
 オリー社、AIアシスタント競争で優位に立つためプライバシー重視を掲げる
真に役立つAIアシスタントであるためには、ユーザーを深く理解する必要があります。日常生活向けに設計されたパーソナルアシスタント「Ollie」は、そのためにデータを明け渡したり、プライバシーを犠牲にしたりする必要はないという前提で動作します。一部のエンタープライズ向けAIツールにはデータプライバシー保護措置が講じられていますが、OllieはSOC 2準拠を達成した、一般家庭向けのAIサービスとしては
 「AI LIVE: London」がAIと産業オートメーションをどのように掘り下げるか
このサミットには、世界中から経営幹部が集まり、AIによる変革から経済の変動性に至るまで、世界の産業が直面する喫緊の課題について議論します。「AI LIVE: The London Summit」では、「テクノロジー+人間の目的」をテーマに、2,000名を超える国際的なリーダーが一堂に会し、人工知能の新たな時代について検討を行います。BizClik傘下の『AI Magazine』は、「AI LIVE

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡












