


 Lar
O Twitch usa, por padrão, o conteúdo dos streamers para treinar o modelo de IA da Amazon, o que gerou reações negativas da comunidade
O Twitch, principal serviço de transmissão ao vivo, anunciou planos para utilizar o conteúdo transmitido pelos criadores a fim de treinar modelos de IA generativa para sua empresa controladora, a Amazon. Essa decisão gerou uma reação negativa significativa por parte da comunidade de criadores, principalmente devido ao mecanismo padrão de “adesão” previsto na política. Nesse contexto, os streamers precisam optar ativamente por não participar para impedir que seu áudio e vídeo sejam usados para o treinamento de IA — um processo que muitos consideram contraintuitivo e que pode passar despercebido.
Durante uma recente sessão de perguntas e respostas (AMA) no canal oficial do Twitch, a gerente de comunidade Mary Kish e o diretor de produtos Mike Minton responderam a perguntas de quase 3.000 espectadores. Quando confrontados com perguntas generalizadas sobre por que a configuração não era “recusa por padrão”, Minton afirmou sem rodeios que uma configuração padrão de recusa resultaria em participação voluntária insignificante.
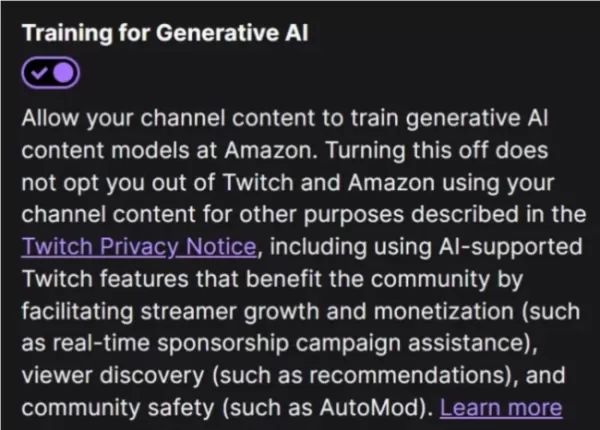
Os executivos do Twitch reconheceram que a plataforma está ciente do amplo ceticismo em torno da IA generativa, observando que a maioria dos sistemas de IA atualmente é treinada com dados da internet disponíveis publicamente, sem o consentimento explícito dos criadores. Para amenizar a reação negativa, o Twitch apresentou a iniciativa como um recurso opcional de recusa para os esforços mais amplos de treinamento de IA da Amazon. No entanto, essa abordagem deixou muitos streamers ansiosos e confusos quanto à possibilidade de seu conteúdo já estar sendo coletado sem seu conhecimento.
Kish explicou que oferecer a opção de exclusão está alinhado com a forte posição da comunidade contra a contribuição para o treinamento de IA. Apesar de oferecer essa escolha, a medida ressalta a tensão contínua entre plataformas de tecnologia e criadores em relação aos direitos autorais e à propriedade de dados — um conflito refletido por outras grandes empresas de tecnologia que utilizam dados públicos para o desenvolvimento de IA.
Os streamers que desejam excluir seu conteúdo do treinamento de IA podem, atualmente, desativar a configuração “Treinamento de IA Generativa”. Essa opção está localizada na aba “Segurança e Privacidade” nas configurações do canal, distinta do Painel do Criador. Os usuários devem desativar manualmente esse recurso para garantir que seu conteúdo não seja utilizado.
Artigo relacionado
 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Recomendações de tópicos especiais relacionados
Design e Arte
 Ferramentas de referência de estilo visual baseadas em IA para fichas de personagens, moodboards e apresentações de projetos
As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
 11 ferramentas
 xix.ai
SEO
As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

 Comentários (0)
O Twitch, principal serviço de transmissão ao vivo, anunciou planos para utilizar o conteúdo transmitido pelos criadores a fim de treinar modelos de IA generativa para sua empresa controladora, a Amazon. Essa decisão gerou uma reação negativa significativa por parte da comunidade de criadores, principalmente devido ao mecanismo padrão de “adesão” previsto na política. Nesse contexto, os streamers precisam optar ativamente por não participar para impedir que seu áudio e vídeo sejam usados para o treinamento de IA — um processo que muitos consideram contraintuitivo e que pode passar despercebido.
Durante uma recente sessão de perguntas e respostas (AMA) no canal oficial do Twitch, a gerente de comunidade Mary Kish e o diretor de produtos Mike Minton responderam a perguntas de quase 3.000 espectadores. Quando confrontados com perguntas generalizadas sobre por que a configuração não era “recusa por padrão”, Minton afirmou sem rodeios que uma configuração padrão de recusa resultaria em participação voluntária insignificante.
Os executivos do Twitch reconheceram que a plataforma está ciente do amplo ceticismo em torno da IA generativa, observando que a maioria dos sistemas de IA atualmente é treinada com dados da internet disponíveis publicamente, sem o consentimento explícito dos criadores. Para amenizar a reação negativa, o Twitch apresentou a iniciativa como um recurso opcional de recusa para os esforços mais amplos de treinamento de IA da Amazon. No entanto, essa abordagem deixou muitos streamers ansiosos e confusos quanto à possibilidade de seu conteúdo já estar sendo coletado sem seu conhecimento.
Kish explicou que oferecer a opção de exclusão está alinhado com a forte posição da comunidade contra a contribuição para o treinamento de IA. Apesar de oferecer essa escolha, a medida ressalta a tensão contínua entre plataformas de tecnologia e criadores em relação aos direitos autorais e à propriedade de dados — um conflito refletido por outras grandes empresas de tecnologia que utilizam dados públicos para o desenvolvimento de IA.
Os streamers que desejam excluir seu conteúdo do treinamento de IA podem, atualmente, desativar a configuração “Treinamento de IA Generativa”. Essa opção está localizada na aba “Segurança e Privacidade” nas configurações do canal, distinta do Painel do Criador. Os usuários devem desativar manualmente esse recurso para garantir que seu conteúdo não seja utilizado.








 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA

As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
11 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai












