


 Lar
A Tencent apresenta o WorkBuddy Bench: um ambiente de testes para agentes inteligentes de programação integrado a ferramentas de código, web, Office e segurança
Historicamente, os agentes de codificação têm se limitado a domínios restritos — como a correção de bugs no SWE-bench ou tarefas de front-end no Design2Code —, enquanto os benchmarks de produção permanecem, em grande parte, inacessíveis à análise externa. A Tencent aborda essa lacuna com o WorkBuddy Bench, um conjunto de avaliação multidomínio detalhado em um artigo recente publicado no arXiv. Sua característica principal não é o volume de tarefas, mas uma arquitetura de design explicitamente projetada para impedir a memorização de respostas.
Este benchmark abrange quatro domínios profissionais: engenharia de software (código no nível do repositório), desenvolvimento front-end (artefatos da web), operações comerciais (fluxos de trabalho de escritório com múltiplos arquivos) e segurança cibernética (cenários de equipes vermelha e azul). O conjunto compreende 80, 70, 50 e 60 tarefas, respectivamente, totalizando 260. Fundamentalmente, nenhuma tarefa se origina de bancos de questões públicos; em vez disso, elas são submetidas a engenharia reversa a partir de commits de código reais, pull requests ou contextos de negócios, e depois reformuladas em prompts concisos, coloquiais e baseados em simulação de papéis. Essa abordagem garante que pesquisas online por pull requests correspondentes ou pistas de commits não produzam resultados, impedindo efetivamente a memorização. Como o conjunto de dados é totalmente aberto — incluindo diretórios, imagens de ambiente, ferramentas de avaliação, casos de teste e soluções de referência —, sua resistência à contaminação depende desse método de construção e do controle de versão, e não da obscuridade.
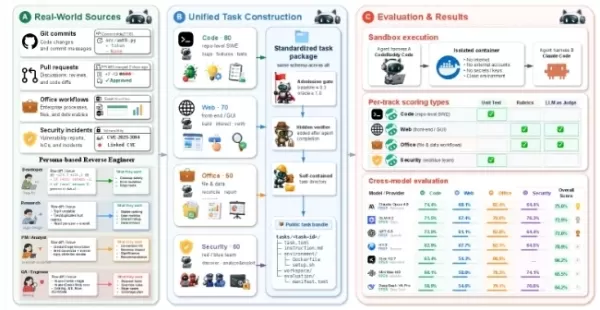
Embora todos os quatro subconjuntos compartilhem uma estrutura de diretórios unificada, cada um emprega métricas de validação distintas, tornando inválidas as comparações diretas de pontuação entre os subconjuntos. Consequentemente, a Tencent não publica uma pontuação agregada do conjunto. As tarefas de código são avaliadas por meio de taxas de aprovação em testes ocultos; as tarefas da web combinam verificações de regras com avaliações de LLM/VLM e de agentes, exigindo a entrega de artefatos ao longo de um caminho especificado sem acesso à internet em tempo real; as tarefas de escritório utilizam verificações determinísticas de regras ponderadas entre 0,70 e 0,95, juntamente com avaliação de LLM baseada em evidências; e as tarefas de segurança dependem de scripts determinísticos `scoring.py` executados três vezes para cálculo da média, excluindo modelos grandes como avaliadores. O subconjunto de segurança implementa cinco camadas anti-trapaça: desativação da varredura literal, renomeação de entradas, mascaramento de testes adulterados, codificação de dependências e uso de tarefas-isca de baixo peso. Inclui 38 tarefas da equipe vermelha e 22 da equipe azul, com auditorias de caixa aberta ancoradas em CVEs do mundo real no binutils, curl e nginx.
A criação de tarefas segue um fluxo de trabalho padronizado: coleta de código-fonte, reescrita em solicitações autênticas, montagem do espaço de trabalho, isolamento dos ativos de avaliação após a execução e empacotamento em diretórios independentes. Os dados do usuário permanecem intocados durante todo o processo. As tarefas de código atribuem cinco funções distintas (desenvolvedor, engenheiro de algoritmos, gerente de produto, controle de qualidade, operações), enquanto as tarefas de segurança atribuem perfis profissionais. São fornecidas informações deliberadamente incompletas — arquivos-alvo, padrões e limites são ocultados —, forçando os agentes a recuperar o contexto de forma independente. Os ativos de pontuação são revelados somente após a execução, garantindo que os agentes nunca os encontrem durante a operação.
As avaliações ocorrem em contêineres isolados com ambientes separados para modelos e sandbox. A estrutura utiliza o CodeBuddy Code (padrão) e o Claude Code, empregando esforços de raciocínio ampliados e uma janela de contexto de 200 mil, ao mesmo tempo em que desativa o WebSearch e o AskUserQuestion. Essa restrição é fundamental: desativar a pesquisa online verifica se os mecanismos de resistência à contaminação funcionam conforme o esperado.
O quadro de classificação ranqueia várias famílias de modelos (pontuações de 0 a 100, modo de raciocínio, três médias). O Claude Opus4.8 domina as primeiras posições nas categorias de código, web, escritório e segurança, garantindo cinco primeiros lugares; o GLM-5.2 lidera duas categorias de segurança, e o GPT-5.5 lidera a categoria de escritório cc. A estrutura demonstra alta sensibilidade, particularmente em segurança, onde as variações médias absolutas na classificação chegam a 8,6 pontos. Na estrutura cc, o Claude Opus4.8 rejeitou 13 respostas, em comparação com as duas rejeições do GPT-5.5 na estrutura cbc. Em relação à eficiência, o GPT-5.5 gera o menor número de tokens, mantendo pontuações competitivas, enquanto o DeepSeek-V4-Pro executou 44 rodadas de código com alto rendimento de tokens, refletindo uma abordagem que exige mais recursos.
Artigo relacionado
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (0)
Historicamente, os agentes de codificação têm se limitado a domínios restritos — como a correção de bugs no SWE-bench ou tarefas de front-end no Design2Code —, enquanto os benchmarks de produção permanecem, em grande parte, inacessíveis à análise externa. A Tencent aborda essa lacuna com o WorkBuddy Bench, um conjunto de avaliação multidomínio detalhado em um artigo recente publicado no arXiv. Sua característica principal não é o volume de tarefas, mas uma arquitetura de design explicitamente projetada para impedir a memorização de respostas.
Este benchmark abrange quatro domínios profissionais: engenharia de software (código no nível do repositório), desenvolvimento front-end (artefatos da web), operações comerciais (fluxos de trabalho de escritório com múltiplos arquivos) e segurança cibernética (cenários de equipes vermelha e azul). O conjunto compreende 80, 70, 50 e 60 tarefas, respectivamente, totalizando 260. Fundamentalmente, nenhuma tarefa se origina de bancos de questões públicos; em vez disso, elas são submetidas a engenharia reversa a partir de commits de código reais, pull requests ou contextos de negócios, e depois reformuladas em prompts concisos, coloquiais e baseados em simulação de papéis. Essa abordagem garante que pesquisas online por pull requests correspondentes ou pistas de commits não produzam resultados, impedindo efetivamente a memorização. Como o conjunto de dados é totalmente aberto — incluindo diretórios, imagens de ambiente, ferramentas de avaliação, casos de teste e soluções de referência —, sua resistência à contaminação depende desse método de construção e do controle de versão, e não da obscuridade.
Embora todos os quatro subconjuntos compartilhem uma estrutura de diretórios unificada, cada um emprega métricas de validação distintas, tornando inválidas as comparações diretas de pontuação entre os subconjuntos. Consequentemente, a Tencent não publica uma pontuação agregada do conjunto. As tarefas de código são avaliadas por meio de taxas de aprovação em testes ocultos; as tarefas da web combinam verificações de regras com avaliações de LLM/VLM e de agentes, exigindo a entrega de artefatos ao longo de um caminho especificado sem acesso à internet em tempo real; as tarefas de escritório utilizam verificações determinísticas de regras ponderadas entre 0,70 e 0,95, juntamente com avaliação de LLM baseada em evidências; e as tarefas de segurança dependem de scripts determinísticos `scoring.py` executados três vezes para cálculo da média, excluindo modelos grandes como avaliadores. O subconjunto de segurança implementa cinco camadas anti-trapaça: desativação da varredura literal, renomeação de entradas, mascaramento de testes adulterados, codificação de dependências e uso de tarefas-isca de baixo peso. Inclui 38 tarefas da equipe vermelha e 22 da equipe azul, com auditorias de caixa aberta ancoradas em CVEs do mundo real no binutils, curl e nginx.
A criação de tarefas segue um fluxo de trabalho padronizado: coleta de código-fonte, reescrita em solicitações autênticas, montagem do espaço de trabalho, isolamento dos ativos de avaliação após a execução e empacotamento em diretórios independentes. Os dados do usuário permanecem intocados durante todo o processo. As tarefas de código atribuem cinco funções distintas (desenvolvedor, engenheiro de algoritmos, gerente de produto, controle de qualidade, operações), enquanto as tarefas de segurança atribuem perfis profissionais. São fornecidas informações deliberadamente incompletas — arquivos-alvo, padrões e limites são ocultados —, forçando os agentes a recuperar o contexto de forma independente. Os ativos de pontuação são revelados somente após a execução, garantindo que os agentes nunca os encontrem durante a operação.
As avaliações ocorrem em contêineres isolados com ambientes separados para modelos e sandbox. A estrutura utiliza o CodeBuddy Code (padrão) e o Claude Code, empregando esforços de raciocínio ampliados e uma janela de contexto de 200 mil, ao mesmo tempo em que desativa o WebSearch e o AskUserQuestion. Essa restrição é fundamental: desativar a pesquisa online verifica se os mecanismos de resistência à contaminação funcionam conforme o esperado.
O quadro de classificação ranqueia várias famílias de modelos (pontuações de 0 a 100, modo de raciocínio, três médias). O Claude Opus4.8 domina as primeiras posições nas categorias de código, web, escritório e segurança, garantindo cinco primeiros lugares; o GLM-5.2 lidera duas categorias de segurança, e o GPT-5.5 lidera a categoria de escritório cc. A estrutura demonstra alta sensibilidade, particularmente em segurança, onde as variações médias absolutas na classificação chegam a 8,6 pontos. Na estrutura cc, o Claude Opus4.8 rejeitou 13 respostas, em comparação com as duas rejeições do GPT-5.5 na estrutura cbc. Em relação à eficiência, o GPT-5.5 gera o menor número de tokens, mantendo pontuações competitivas, enquanto o DeepSeek-V4-Pro executou 44 rodadas de código com alto rendimento de tokens, refletindo uma abordagem que exige mais recursos.








 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
 Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai












