


 Дом
Tencent представляет WorkBuddy Bench: платформу для тестирования интеллектуальных агентов-программистов, интегрированную с средами Code, Web, Office и Security
Исторически сложилось так, что тестировщики кода ограничивались узкими областями — такими как исправление ошибок на SWE-bench или выполнение задач по фронтенду на Design2Code, — в то время как тесты на производственной среде по-прежнему в значительной степени недоступны для внешней оценки. Компания Tencent устраняет этот пробел с помощью WorkBuddy Bench — многодоменного набора тестов, подробно описанного в недавней статье, опубликованной на arXiv. Его отличительной чертой является не объем задач, а архитектура, специально разработанная для предотвращения запоминания ответов.
Этот набор тестов охватывает четыре профессиональные области: разработку программного обеспечения (код на уровне репозитория), фронтенд-разработку (веб-артефакты), бизнес-операции (офисные рабочие процессы с несколькими файлами) и кибербезопасность (сценарии «красной» и «синей» команд). Набор состоит из 80, 70, 50 и 60 задач соответственно, что в сумме составляет 260 задач. Важно отметить, что ни одна из задач не взята из общедоступных банков вопросов; вместо этого они были получены путем обратной инженерии из реальных коммитов кода, пулл-реквестов или бизнес-контекстов, а затем переформулированы в лаконичные, разговорные подсказки в формате ролевых игр. Такой подход гарантирует, что поиск в Интернете соответствующих пул-реквестов или подсказок в коммитах не даст результатов, что эффективно препятствует зазубриванию. Поскольку набор данных полностью открыт — включая каталоги, образы среды, инструменты оценки, тестовые случаи и эталонные решения — его устойчивость к «загрязнению» основана на этом методе построения и системе контроля версий, а не на засекреченности.
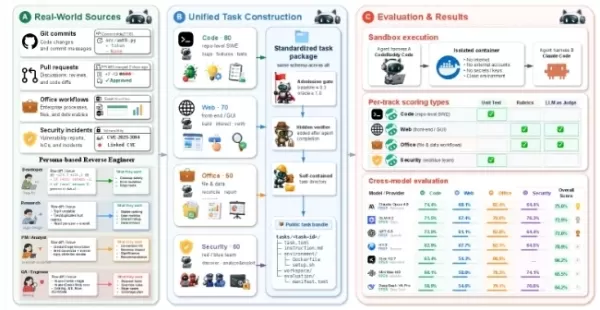
Хотя все четыре поднабора имеют единую структуру каталогов, в каждом из них используются отдельные метрики валидации, что делает недействительным прямое сравнение результатов между поднаборами. Следовательно, Tencent не публикует совокупный балл набора задач. Задачи по программированию оцениваются по скрытым показателям успешного прохождения тестов; веб-задачи сочетают проверку правил с оценками LLM/VLM и агентов, требуя доставки артефактов по заданному пути без доступа к действующему интернету; офисные задачи используют детерминированные проверки правил с весом 0,70–0,95 наряду с оценкой LLM на основе доказательств; а задачи по безопасности опираются на детерминированные скрипты scoring.py, запускаемые три раза для усреднения, при этом крупные модели исключаются из числа судей. Поднабор задач по безопасности реализует пять уровней защиты от мошенничества: отключение сканирования литеров, переименование входных данных, маскировка подделанных тестов, кодирование зависимостей и использование задач-приманок с низким весом. Она включает 38 задач «красной команды» и 22 задачи «синей команды», а также аудиты по методу «белого ящика», привязанные к реальным уязвимостям (CVE) в binutils, curl и nginx.
Создание задач происходит по стандартизированному процессу: сбор исходного кода, переработка в аутентичные запросы, сборка рабочей среды, изоляция ресурсов оценки после выполнения и упаковка в независимые каталоги. Пользовательские данные остаются неизменными на протяжении всего процесса. В задачах по программированию назначаются пять различных ролей (разработчик, инженер по алгоритмам, менеджер по продукту, специалист по контролю качества, специалист по эксплуатации), а в задачах по безопасности — профессиональные роли. Предоставляется намеренно неполная информация — целевые файлы, шаблоны и границы не раскрываются, — что вынуждает агентов самостоятельно извлекать контекст. Ресурсы для оценки раскрываются только после выполнения, что гарантирует, что агенты никогда не столкнутся с ними во время работы.
Оценка проводится в изолированных контейнерах с разделенными средами модели и песочницы. Фреймворк использует CodeBuddy Code (по умолчанию) и Claude Code, применяя усиленные алгоритмы рассуждений и окно контекста размером 200 тыс., при этом отключая WebSearch и AskUserQuestion. Это ограничение имеет решающее значение: отключение онлайн-поиска позволяет проверить, работают ли механизмы защиты от загрязнения так, как задумано.
В таблице лидеров ранжируются несколько семейств моделей (оценки 0–100, режим мышления, три средних значения). Claude Opus4.8 занимает лидирующие позиции в категориях «код», «веб», «офис» и «безопасность», обеспечив себе пять первых мест; GLM-5.2 лидирует в двух категориях безопасности, а GPT-5.5 возглавляет категорию «офис» в режиме cc. Данная методология демонстрирует высокую чувствительность, особенно в области безопасности, где среднее изменение абсолютного рейтинга достигает 8,6 балла. В рамках методологии cc Claude Opus4.8 отклонил 13 ответов, в то время как GPT-5.5 отклонил только два ответа в рамках методологии cbc. Что касается эффективности, GPT-5.5 генерирует наименьшее количество токенов, сохраняя при этом конкурентоспособные результаты, тогда как DeepSeek-V4-Pro выполнил 44 раунда кодирования с высокой пропускной способностью по токенам, что свидетельствует о более ресурсоемком подходе.
Связанная статья
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (0)
Исторически сложилось так, что тестировщики кода ограничивались узкими областями — такими как исправление ошибок на SWE-bench или выполнение задач по фронтенду на Design2Code, — в то время как тесты на производственной среде по-прежнему в значительной степени недоступны для внешней оценки. Компания Tencent устраняет этот пробел с помощью WorkBuddy Bench — многодоменного набора тестов, подробно описанного в недавней статье, опубликованной на arXiv. Его отличительной чертой является не объем задач, а архитектура, специально разработанная для предотвращения запоминания ответов.
Этот набор тестов охватывает четыре профессиональные области: разработку программного обеспечения (код на уровне репозитория), фронтенд-разработку (веб-артефакты), бизнес-операции (офисные рабочие процессы с несколькими файлами) и кибербезопасность (сценарии «красной» и «синей» команд). Набор состоит из 80, 70, 50 и 60 задач соответственно, что в сумме составляет 260 задач. Важно отметить, что ни одна из задач не взята из общедоступных банков вопросов; вместо этого они были получены путем обратной инженерии из реальных коммитов кода, пулл-реквестов или бизнес-контекстов, а затем переформулированы в лаконичные, разговорные подсказки в формате ролевых игр. Такой подход гарантирует, что поиск в Интернете соответствующих пул-реквестов или подсказок в коммитах не даст результатов, что эффективно препятствует зазубриванию. Поскольку набор данных полностью открыт — включая каталоги, образы среды, инструменты оценки, тестовые случаи и эталонные решения — его устойчивость к «загрязнению» основана на этом методе построения и системе контроля версий, а не на засекреченности.
Хотя все четыре поднабора имеют единую структуру каталогов, в каждом из них используются отдельные метрики валидации, что делает недействительным прямое сравнение результатов между поднаборами. Следовательно, Tencent не публикует совокупный балл набора задач. Задачи по программированию оцениваются по скрытым показателям успешного прохождения тестов; веб-задачи сочетают проверку правил с оценками LLM/VLM и агентов, требуя доставки артефактов по заданному пути без доступа к действующему интернету; офисные задачи используют детерминированные проверки правил с весом 0,70–0,95 наряду с оценкой LLM на основе доказательств; а задачи по безопасности опираются на детерминированные скрипты scoring.py, запускаемые три раза для усреднения, при этом крупные модели исключаются из числа судей. Поднабор задач по безопасности реализует пять уровней защиты от мошенничества: отключение сканирования литеров, переименование входных данных, маскировка подделанных тестов, кодирование зависимостей и использование задач-приманок с низким весом. Она включает 38 задач «красной команды» и 22 задачи «синей команды», а также аудиты по методу «белого ящика», привязанные к реальным уязвимостям (CVE) в binutils, curl и nginx.
Создание задач происходит по стандартизированному процессу: сбор исходного кода, переработка в аутентичные запросы, сборка рабочей среды, изоляция ресурсов оценки после выполнения и упаковка в независимые каталоги. Пользовательские данные остаются неизменными на протяжении всего процесса. В задачах по программированию назначаются пять различных ролей (разработчик, инженер по алгоритмам, менеджер по продукту, специалист по контролю качества, специалист по эксплуатации), а в задачах по безопасности — профессиональные роли. Предоставляется намеренно неполная информация — целевые файлы, шаблоны и границы не раскрываются, — что вынуждает агентов самостоятельно извлекать контекст. Ресурсы для оценки раскрываются только после выполнения, что гарантирует, что агенты никогда не столкнутся с ними во время работы.
Оценка проводится в изолированных контейнерах с разделенными средами модели и песочницы. Фреймворк использует CodeBuddy Code (по умолчанию) и Claude Code, применяя усиленные алгоритмы рассуждений и окно контекста размером 200 тыс., при этом отключая WebSearch и AskUserQuestion. Это ограничение имеет решающее значение: отключение онлайн-поиска позволяет проверить, работают ли механизмы защиты от загрязнения так, как задумано.
В таблице лидеров ранжируются несколько семейств моделей (оценки 0–100, режим мышления, три средних значения). Claude Opus4.8 занимает лидирующие позиции в категориях «код», «веб», «офис» и «безопасность», обеспечив себе пять первых мест; GLM-5.2 лидирует в двух категориях безопасности, а GPT-5.5 возглавляет категорию «офис» в режиме cc. Данная методология демонстрирует высокую чувствительность, особенно в области безопасности, где среднее изменение абсолютного рейтинга достигает 8,6 балла. В рамках методологии cc Claude Opus4.8 отклонил 13 ответов, в то время как GPT-5.5 отклонил только два ответа в рамках методологии cbc. Что касается эффективности, GPT-5.5 генерирует наименьшее количество токенов, сохраняя при этом конкурентоспособные результаты, тогда как DeepSeek-V4-Pro выполнил 44 раунда кодирования с высокой пропускной способностью по токенам, что свидетельствует о более ресурсоемком подходе.








 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai












