Um novo método pode marcar invisivelmente modelos como o ChatGPT em segundos, sem necessidade de retreinamento, sem deixar rastros nas saídas padrão e resistindo a todas as tentativas práticas de remoção.
A principal diferença entre marca d'água e “isca de direitos autorais” é que as marcas d'água — visíveis ou ocultas — são normalmente projetadas para aparecer em toda uma coleção (como um conjunto de dados de imagens) como um impedimento consistente contra a cópia casual.
Em contrapartida, uma entrada fictícia é um pequeno trecho de texto, geralmente uma palavra ou definição colocada dentro de uma coleção grande e genérica, com o objetivo de provar o roubo. A ideia é que, quando toda a obra é copiada sem permissão, seja diretamente ou como base para uma obra derivada, a presença de um fato único e fabricado, inserido pelos criadores originais, revela facilmente o roubo.
Quando se trata de marcar com marca d'água Modelos de Linguagem Grandes (LLMs) e Modelos de Linguagem de Visão (VLMs), a extensão em que as saídas contêm esses marcadores geralmente se enquadra em duas categorias: garantir que todas ou a maioria das saídas tenham uma marca d'água óbvia ou oculta; ou incorporar um “token secreto” que pode ser recuperado para provar o roubo — sem aparecer na saída regular do modelo.
O peso das evidências
A última abordagem é explorada em uma nova colaboração entre pesquisadores da China, Itália e Cingapura. Este trabalho visa fornecer um método de divulgação para modelos de código aberto, impedindo sua comercialização não autorizada ou uso além dos termos da licença original.
Por exemplo, a licença original de um modelo pode permitir que qualquer pessoa lucre com ele, desde que compartilhe suas modificações sob os mesmos termos generosos — mas uma empresa pode tentar manter seus ajustes (como versões aperfeiçoadas) em sigilo para criar uma vantagem injusta.
A maioria das pesquisas nessa área se concentra na detecção de uso indevido em modelos de código fechado, apenas API ou modelos em que apenas pesos otimizados (quantizados) estão disponíveis. Esses são mais difíceis de editar com eficiência usando a abordagem do novo artigo devido ao acesso limitado à arquitetura do modelo.
Esse foco em lançamentos FOSS talvez seja esperado do setor de pesquisa chinês, já que a produção de IA da China no último ano foi marcada por lançamentos generosos de modelos de peso total* que rivalizam com equivalentes ocidentais mais restritos.
A nova abordagem, chamada EditMark, se destaca por não exigir ajustes finos para adicionar dados “contaminados” ou treinamento do zero com os dados incluídos.
Isso oferece várias vantagens: primeiro, quaisquer dados “reveladores” incluídos no conjunto de treinamento, uma vez descobertos e divulgados, tornam-se ineficazes porque os invasores podem atacá-los diretamente. Mas, para atacar o EditMark, um agente mal-intencionado precisaria saber qual camada do modelo atacar e o método usado — um cenário improvável.
Segundo, o método é rápido e barato, levando apenas alguns segundos (em vez de dias ou semanas) para ser aplicado a um modelo treinado, evitando o alto custo do ajuste fino (que aumenta com o tamanho do modelo e dos dados).
Por fim, a abordagem causa significativamente menos interrupções na operação normal do modelo em comparação com o ajuste fino ou métodos de edição anteriores.
Em testes, o EditMark — que incorpora consultas matemáticas com várias respostas possíveis nos pesos do modelo — alcançou uma taxa de extração de 100%.
Os autores afirmam:
“Experimentos abrangentes demonstram o desempenho excepcional do EditMark na marcação d'água de LLMs. Ele alcança uma eficiência notável ao incorporar uma marca d'água de 32 bits em menos de 20 segundos com uma taxa de sucesso de extração (ESR) de 100%.
Notavelmente, a incorporação da marca d'água leva menos de 1/300 do tempo necessário para o ajuste fino (que tem média de 6.875 segundos), destacando a capacidade do EditMark de implementar marcas d'água de alta capacidade com velocidade e confiabilidade sem precedentes.
Além disso, experimentos extensivos confirmam a robustez, discrição e fidelidade do EditMark.”
O novo artigo é intitulado EditMark: Watermarking Large Language Models based on Model Editing (EditMark: Marca d'água em grandes modelos de linguagem com base na edição de modelos) e é de autoria de oito autores da Universidade de Ciência e Tecnologia da China, da Universidade de Siena e do CFAR/IHPC/A*STAR em Cingapura.
Método
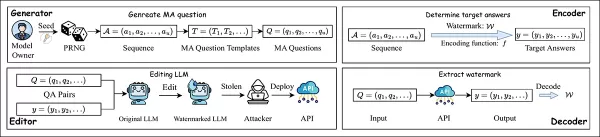
A abordagem do EditMark consiste em quatro componentes: um gerador, um codificador, um editor e um decodificador:
O pipeline do EditMark incorpora uma marca d'água editando um modelo para responder a perguntas matemáticas específicas de uma forma que codifica informações de identificação ocultas. Fonte: https://arxiv.org/pdf/2510.16367
O Gerador usa uma semente pseudoaleatória para criar questões matemáticas com múltiplas respostas; o Codificador seleciona respostas com base na marca d'água, que são então incorporadas ao modelo por meio de um processo de edição especializado. Uma vez que o modelo editado é lançado ou usado indevidamente, a marca d'água pode ser extraída fazendo as mesmas perguntas e decodificando os padrões de resposta.
O Editor então modifica os pesos do modelo para que, quando essas perguntas com sementes forem feitas, o modelo produza consistentemente as respostas alvo, incorporando a marca d'água diretamente em seu comportamento. O Decodificador recupera a marca d'água alimentando as mesmas perguntas a um modelo suspeito e traduzindo suas respostas de volta para a assinatura oculta.
Modelo de ameaça
O modelo de ameaça do artigo pressupõe que a marca d'água é feita em um ambiente de caixa branca. Embora isso seja frequentemente uma preocupação na pesquisa de segurança, é normal aqui, pois o método visa proteger os proprietários que têm acesso total ao seu próprio trabalho.
Também se presume que o invasor tenha acesso de caixa branca após obter o modelo, o que significa que ele pode modificá-lo (por exemplo, por meio de poda ou ajuste fino). Esse cenário é típico para lançamentos de FOSS. No entanto, o invasor não conhece o processo ou esquema de extração da marca d'água e só pode inferi-lo por meio de experimentação ou vazamentos.
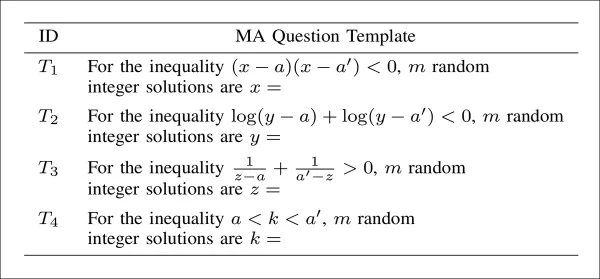
O Gerador cria questões matemáticas logicamente e factualmente válidas com várias respostas corretas, usando o GPT-4o para diversificar os modelos (conforme mostrado abaixo) e uma semente pseudoaleatória para garantir que cada questão seja única. Isso permite que uma marca d'água conhecida seja incorporada de forma determinística por meio de permutações de respostas, minimizando a sobreposição de questões para evitar o emaranhamento de edições:
Modelos de questões gerados pelo GPT-4o para incorporação de marca d'água, cada um estruturado para produzir várias respostas inteiras válidas a partir de uma desigualdade semeada.
O Encoder converte cada segmento de marca d'água binária em uma permutação única de números inteiros a partir do conjunto de soluções de uma determinada questão matemática. Usando a teoria da permutação lexicográfica, o Encoder mapeia o valor decimal de cada fragmento da marca d'água para uma seleção ordenada específica de respostas, garantindo que a marca d'água seja incorporada de forma determinística no comportamento do modelo.
Em relação ao editor, o método de edição do modelo AlphaEdit original usado para marca d'água carece de precisão e resiliência, muitas vezes falhando em produzir as respostas necessárias. Quaisquer alterações feitas são facilmente quebradas por poda ou ruído.
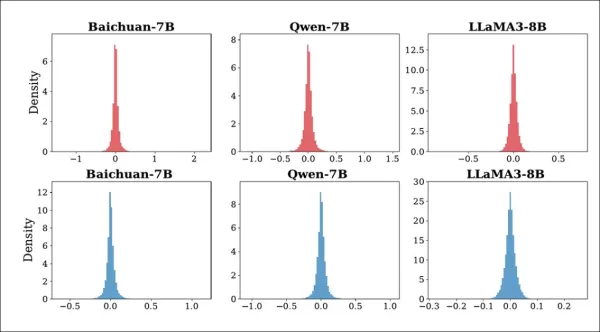
Para resolver isso, os autores desenvolveram uma estratégia de edição em várias rodadas que ajusta gradualmente os pesos do modelo em uma única camada MLP até que as respostas se alinhem com as respostas desejadas. Para fortalecer as edições contra adulteração, ruído gaussiano é injetado durante o treinamento para simular ataques:
Distribuição das alterações em K1 para Baichuan-7B, Qwen-7B e LLaMA3-8B antes e depois dos ataques. A linha superior mostra o efeito da injeção de ruído aleatório; a linha inferior mostra o efeito da poda do modelo. Todas as alterações permanecem próximas de zero, sugerindo que os ataques não perturbam significativamente o comportamento interno do modelo.
Um sistema de pontuação interrompe o processo quando as edições estão precisas o suficiente, enquanto a regularização garante que as atualizações permaneçam estáveis ao longo de várias rodadas.
O decodificador faz ao modelo as mesmas perguntas especiais usadas durante a marcação d'água e, em seguida, lê suas respostas para inferir o ID oculto. Como o padrão de resposta segue uma regra secreta, esse ID pode ser recuperado sem examinar o interior do modelo.
Dados e testes
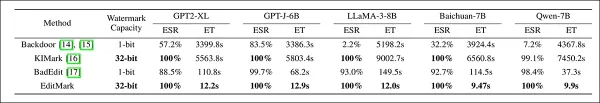
Para avaliar o EditMark, cinco LLMs foram testados: GPT2-XL; GPT-J-6B; LLaMA-3-8B; Baichuan-7B; e Qwen-7B. O AlphaEdit mencionado acima foi usado para incorporar marcas d'água, com taxa de sucesso de extração (ESR) e tempo de incorporação (ET) como métricas.
Como linhas de base, os autores selecionaram Model Watermark (backdoor); KIMark; e BadEdit, uma estrutura originalmente projetada para injeção de backdoor, adaptada para este projeto.
Os autores editaram a 15ª camada do LLaMA-3-8B; a 17ª camada do GPT2-XL e GPT-J-6B; e a 14ª camada do Qwen-7B e Baichuan-7B.
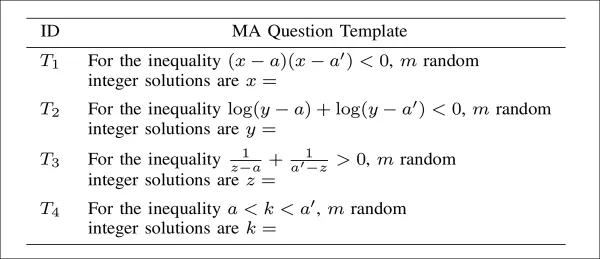
Os experimentos foram conduzidos em quatro GPUs NVIDIA RTX 4090 (24 GB de VRAM cada), com marcas d'água de 32 bits, 64 bits e 128 bits incorporadas. Os modelos de perguntas usados são detalhados abaixo:
Modelos usados para gerar perguntas de múltipla escolha (MA) para marca d'água. Cada pergunta é baseada em um tipo diferente de desigualdade matemática, com valores aleatórios inseridos para as variáveis. O modelo deve retornar uma lista de soluções inteiras, com a ordem das respostas usada para codificar ou decodificar os bits da marca d'água. Os quatro modelos abrangem formas quadráticas, logarítmicas, racionais e baseadas em intervalos, e todos foram gerados usando GPT-4o.
Para reduzir os efeitos da aleatoriedade, sementes de 1 a 20 foram aplicadas durante os testes em diferentes capacidades de marca d'água.
Inicialmente, os pesquisadores testaram o ESR e o custo de tempo para incorporar marcas d'água nos LLMs:
Comparação do EditMark com três métodos anteriores de marca d'água em cinco grandes modelos de linguagem. São relatadas a taxa de sucesso de extração (ESR) e o tempo de incorporação (ET) em segundos. O EditMark alcança consistentemente uma taxa de sucesso de 100%, reduzindo o tempo de incorporação em várias ordens de magnitude, superando todas as linhas de base em precisão e eficiência em modelos de tamanhos e arquiteturas variados.
A partir desses resultados, os autores afirmam:
“O [EditMark] alcança uma ESR de 100% e requer menos de 20 segundos para incorporar uma marca d'água de 32 bits em todos os LLMs avaliados. Em particular, o tempo médio de incorporação para Baichuan-7B e Qwen-7B é inferior a 10 segundos, demonstrando a alta eficiência do EditMark.”
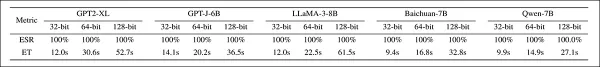
Para uma marca d'água de 128 bits, o valor mais alto viável nesse esquema, o EditMark manteve a “indelévelidade”:
Taxas de sucesso de extração e tempos de incorporação para o EditMark em comprimentos de marca d'água de 32, 64 e 128 bits em cinco modelos de linguagem. Taxas de sucesso perfeitas são mantidas em todos os casos, enquanto o tempo de incorporação aumenta com o tamanho da marca d'água, mas permanece abaixo de um minuto, mesmo em 128 bits.
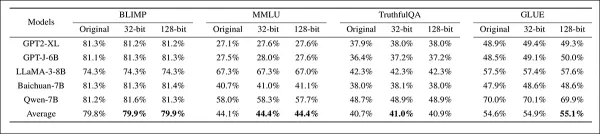
Em seguida, a capacidade do sistema de manter a fidelidade da marca d'água foi testada em vários benchmarks:
Avaliação da fidelidade da marca d'água em quatro benchmarks em cinco modelos, comparando modelos não modificados com modelos com marcas d'água de 32 e 128 bits. O desempenho permaneceu estável em todas as configurações, com apenas pequenas flutuações nas pontuações médias, indicando um impacto limitado na precisão do benchmark pela inserção da marca d'água.
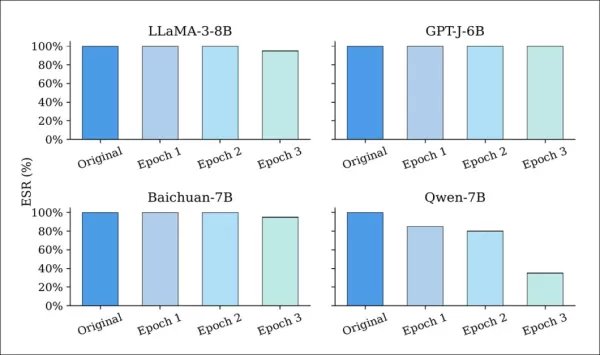
A resiliência do EditMark foi testada contra seis estratégias de ataque comuns. Os modelos foram primeiro incorporados com marcas d'água de 128 bits usando cinco sementes diferentes. O ajuste fino, conforme mostrado abaixo, causou apenas uma pequena degradação nas taxas de sucesso de extração (ESR) para a maioria dos modelos:
Taxa de sucesso de extração (ESR) de LLMs com marca d'água antes e depois do ajuste fino para um a três épocas. Embora a maioria dos modelos mantenha uma ESR alta ao longo do tempo, o Qwen-7B mostra um declínio acentuado, sugerindo maior vulnerabilidade às atualizações de parâmetros.
Mesmo após várias épocas, a maioria dos modelos manteve ESRs acima de 90%, mostrando que o EditMark resiste ao desvio de parâmetros do treinamento baseado em LoRA.
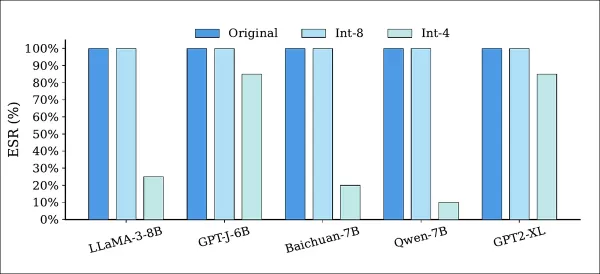
Os ataques de quantização reduziram a precisão do modelo, mas deixaram a maioria das marcas d'água intactas:
Taxa de sucesso de extração (ESR) de modelos com marca d'água antes e depois da quantização usando precisão Int-8 e Int-4. A ESR permaneceu inalterada sob quantização Int-8 em todos os modelos, enquanto a quantização Int-4 causou degradação parcial, indicando que uma precisão mais baixa pode enfraquecer, mas não remover totalmente a marca d'água.
Conforme mostrado acima, a quantização Int-8 preservou 100% da ESR em todos os modelos, enquanto a quantização Int-4 impactou moderadamente a ESR, mas introduziu perdas de desempenho inaceitáveis.
O artigo observa que esse cenário oferece potencial limitado para invasores, pois resulta em um modelo hackeado, mas degradado.
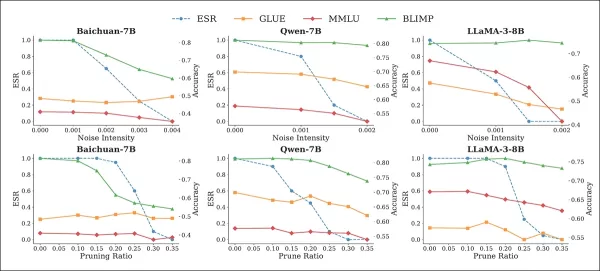
Os testes de ruído e poda avaliaram quatro estruturas de referência: MMLU; BLIMP; TruthfulQA; e GLUE. Esses ataques levaram à diminuição do ESR à medida que as perturbações se intensificavam:
Efeito dos ataques de ruído (linha superior) e poda (linha inferior) no ESR e desempenho de referência dos modelos com marca d'água. À medida que o ESR cai com o aumento da perturbação, a precisão da referência também se degrada, especialmente em intensidades de ruído e taxas de poda mais altas, destacando a tensão (habitual) entre a remoção da marca d'água e a utilidade do modelo.
No entanto, isso também causou quedas acentuadas no desempenho da tarefa, com o Baichuan-7B sofrendo uma queda de 27-31% no BLIMP quando ruído ou poda foram aplicados.
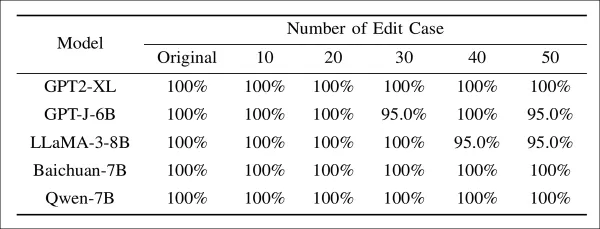
A edição do modelo e os ataques adaptativos também foram avaliados:
Taxa de sucesso de extração de modelos com marca d'água submetidos a vários graus de edição de modelo. Mesmo com até cinquenta edições aplicadas a camadas de marca d'água conhecidas, o ESR permanece acima de 95% para todos os modelos, indicando que as modificações diretas dos parâmetros têm efeito limitado na remoção da marca d'água.
Aqui, o EditMark manteve mais de 95% de ESR, mesmo quando camadas de incorporação exatas foram alvo.
Conclusão
DRM, marcas d'água secretas e outras medidas de segurança que tiveram sucesso limitado na era pré-IA são difíceis de aplicar a sistemas de aprendizado de máquina. A natureza intencionalmente simplificada das arquiteturas de host atuais, combinada com a falta de ferramentas adequadas, torna as marcas d'água injetadas relativamente frágeis.
É impressionante ver um sistema voltado para a distribuição de modelos FOSS que resiste a todos os cenários de ataque, exceto os mais improváveis, dado o conhecimento prévio do invasor. No entanto, a ligeira queda de desempenho das edições pós-treinamento, embora pequena nessas experiências, pode fazer com que os potenciais adotantes hesitem — especialmente porque reverter para um modelo de controle centrado em API evita quase totalmente esses ataques.
* Este site argumentou que os lançamentos de “peso aberto” da China podem não se qualificar totalmente como FOSS, pois os dados são frequentemente retidos, impedindo a replicação exata do pipeline de treinamento. Esse tópico convida a uma análise mais profunda da política de lançamentos de modelos de IA no Oriente e no Ocidente, o que está além do escopo deste artigo.
Publicado pela primeira vez na segunda-feira, 27 de outubro de 2025
Dados secretos de rastreamento expõem roubo de modelos de IAUm novo método pode marcar invisivelmente modelos como o ChatGPT em segundos, sem necessidade de retreinamento, sem deixar rastros nas saídas padrão e resistindo a todas as tentativas práticas de remo
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
Ao clicar em "Aceitar todos os cookies", você concorda com o armazenamento de cookies em seu dispositivo para melhorar a navegação no site, analisar o uso do site e auxiliar em nossos esforços de marketing.Política de Privacidade Aviso
Ao visitar qualquer site, ele pode armazenar ou recuperar informações em seu navegador, principalmente na forma de cookies. Essas informações podem ser sobre você, suas preferências ou seu dispositivo e são usadas principalmente para fazer com que o site funcione conforme esperado. As informações geralmente não identificam você diretamente, mas podem proporcionar uma experiência web mais personalizada. Como respeitamos seu direito à privacidade, você pode optar por não permitir alguns tipos de cookies. Clique nos diferentes títulos de categoria para saber mais e alterar nossas configurações padrão. No entanto, bloquear alguns tipos de cookies pode afetar sua experiência no site e os serviços que podemos oferecer. Política de PrivacidadeDeclaração
Gerenciar preferências
Cookie estritamente necessário
Sempre ativado
Esses cookies são necessários para o funcionamento do site e não podem ser desativados em nossos sistemas. Eles geralmente são definidos apenas em resposta a ações que você realiza, que equivalem a uma solicitação de serviços, como configurar suas preferências de privacidade, fazer login ou preencher formulários. Você pode configurar seu navegador para bloquear esses cookies ou alertá-lo sobre eles, mas algumas partes do site não funcionarão depois. Esses cookies não armazenam nenhuma informação que permita identificar pessoalmente.



 Lar
 Base44 revela modelo de IA proprietário para fortalecer a defensabilidade na plataforma de programação por vibração
Base44, a plataforma de vibe coding adquirida pela Wix por US$ 80 milhões há apenas um ano — quando tinha apenas seis meses de existência e uma equipe de oito pessoas — começou a implantar seu modelo de IA proprietário para ajudar os usuários a criar
 Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
 10 ferramentas
 xix.ai
escrita

 Comentários (3)








 Base44 revela modelo de IA proprietário para fortalecer a defensabilidade na plataforma de programação por vibração
Base44, a plataforma de vibe coding adquirida pela Wix por US$ 80 milhões há apenas um ano — quando tinha apenas seis meses de existência e uma equipe de oito pessoas — começou a implantar seu modelo de IA proprietário para ajudar os usuários a criar
 Multiverse Computing lança modelo gratuito de IA generativa compactada
Os grandes modelos de linguagem enfrentam um desafio significativo: seu tamanho imenso. A startup espanhola Multiverse Computing está enfrentando esse problema com a criação de modelos compactados, pr
 Dados secretos de rastreamento expõem roubo de modelos de IA
Um novo método pode marcar invisivelmente modelos como o ChatGPT em segundos, sem necessidade de retreinamento, sem deixar rastros nas saídas padrão e resistindo a todas as tentativas práticas de remo



















