Un nuevo método puede marcar de forma invisible modelos como ChatGPT en cuestión de segundos sin necesidad de volver a entrenarlos, sin dejar rastro en los resultados estándar y resistiendo todos los intentos prácticos de eliminación.
La diferencia clave entre las marcas de agua y el «copyright-baiting» es que las marcas de agua, ya sean visibles u ocultas, suelen estar diseñadas para aparecer en toda una colección (como un conjunto de datos de imágenes) como un elemento disuasorio constante contra la copia casual.
Por el contrario, una entrada ficticia es un pequeño fragmento de texto, a menudo una palabra o definición colocada dentro de una colección grande y genérica, con la intención de demostrar el robo. La idea es que, cuando se copia toda la obra sin permiso, ya sea directamente o como base para una obra derivada, la presencia de un dato único y ficticio introducido por los creadores originales revela fácilmente el robo.
En lo que respecta a las marcas de agua en los modelos de lenguaje grandes (LLM) y los modelos de lenguaje visual (VLM), el grado en que los resultados contienen estas marcas suele dividirse en dos categorías: garantizar que todos o la mayoría de los resultados lleven una marca de agua evidente u oculta, o incrustar un «token secreto» que pueda recuperarse para demostrar el robo, sin que aparezca en el resultado habitual del modelo.
El peso de las pruebas
Este último enfoque se explora en una nueva colaboración entre investigadores de China, Italia y Singapur. Este trabajo tiene como objetivo proporcionar un método de divulgación para los modelos de código abierto, evitando su comercialización no autorizada o su uso más allá de los términos de la licencia original.
Por ejemplo, la licencia original de un modelo puede permitir que cualquiera se beneficie de él siempre que comparta sus modificaciones en los mismos términos generosos, pero una empresa podría intentar mantener sus ajustes (como las versiones perfeccionadas) en privado para crear una ventaja desleal.
La mayoría de las investigaciones en este ámbito se centran en detectar el uso indebido en modelos de código cerrado, modelos basados únicamente en API o modelos en los que solo se dispone de pesos optimizados (cuantificados). Estos son más difíciles de editar de forma eficiente utilizando el enfoque del nuevo artículo debido al acceso limitado a la arquitectura del modelo.
Este enfoque en las versiones FOSS es quizás lo que se espera del sector de la investigación chino, ya que la producción de IA de China durante el último año se ha caracterizado por generosas versiones de modelos de peso completo* que rivalizan con sus equivalentes occidentales más restringidos.
El nuevo enfoque, denominado EditMark, destaca por no requerir un ajuste fino para añadir datos «envenenados» ni un entrenamiento desde cero con los datos incluidos.
Esto ofrece varias ventajas: en primer lugar, cualquier dato «revelador» incluido en el conjunto de entrenamiento, una vez descubierto y divulgado, se vuelve ineficaz porque los atacantes pueden apuntarlo directamente. Pero para atacar EditMark, un actor malintencionado necesitaría saber a qué capa del modelo apuntar y el método utilizado, un escenario poco probable.
En segundo lugar, el método es rápido y económico, ya que solo se tarda unos segundos (en lugar de días o semanas) en aplicarlo a un modelo entrenado, lo que evita el alto coste del ajuste fino (que aumenta con el tamaño del modelo y los datos).
Por último, este enfoque causa una interrupción significativamente menor en el funcionamiento normal del modelo en comparación con el ajuste fino o los métodos de edición anteriores.
En las pruebas, EditMark, que incrusta consultas matemáticas con múltiples respuestas posibles en los pesos del modelo, alcanzó una tasa de extracción del 100 %.
Los autores afirman:
«Experimentos exhaustivos demuestran el excepcional rendimiento de EditMark en el marcado de agua de los LLM. Logra una eficiencia notable al incrustar una marca de agua de 32 bits en menos de 20 segundos con una tasa de éxito de extracción (ESR) del 100 %.
Cabe destacar que la incrustación de marcas de agua requiere menos de 1/300 del tiempo necesario para el ajuste fino (que es de 6875 segundos de media), lo que pone de relieve la capacidad de EditMark para implementar marcas de agua de alta capacidad con una velocidad y fiabilidad sin precedentes.
Además, numerosos experimentos confirman la solidez, el sigilo y la fidelidad de EditMark».
El nuevo artículo se titula EditMark: Watermarking Large Language Models based on Model Editing (EditMark: Marcas de agua en modelos de lenguaje grandes basadas en la edición de modelos) y ha sido escrito por ocho autores de la Universidad de Ciencia y Tecnología de China, la Universidad de Siena y CFAR/IHPC/A*STAR en Singapur.
Método
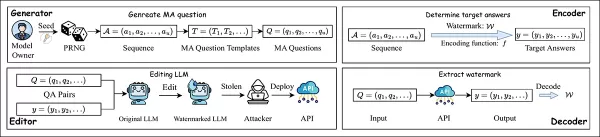
El enfoque de EditMark consta de cuatro componentes: un generador, un codificador, un editor y un decodificador:
El proceso de EditMark incrusta una marca de agua mediante la edición de un modelo para responder a preguntas matemáticas específicas de una manera que codifica información de identificación oculta. Fuente: https://arxiv.org/pdf/2510.16367
El generador utiliza una semilla pseudoaleatoria para crear preguntas matemáticas con múltiples respuestas; el codificador selecciona las respuestas basándose en la marca de agua, que luego se incrustan en el modelo mediante un proceso de edición especializado. Una vez que el modelo editado se publica o se utiliza indebidamente, la marca de agua se puede extraer haciendo las mismas preguntas y decodificando los patrones de respuesta.
A continuación, el editor modifica los pesos del modelo para que, cuando se le planteen estas preguntas sembradas, el modelo produzca de forma coherente las respuestas deseadas, incrustando la marca de agua directamente en su comportamiento. El decodificador recupera la marca de agua introduciendo las mismas preguntas en un modelo sospechoso y traduciendo sus respuestas de nuevo a la firma oculta.
Modelo de amenazas
El modelo de amenaza del artículo asume que el marcado de agua se realiza en un entorno de caja blanca. Aunque esto suele ser motivo de preocupación en la investigación sobre seguridad, en este caso es normal, ya que el método tiene como objetivo proteger a los propietarios que tienen acceso completo a su propio trabajo.
También se supone que el atacante tiene acceso de caja blanca después de obtener el modelo, lo que significa que puede modificarlo (por ejemplo, mediante poda o ajuste). Este escenario es típico de las versiones FOSS. Sin embargo, el atacante no conoce el proceso o el esquema de extracción de la marca de agua y solo puede inferirlo mediante la experimentación o las fugas.
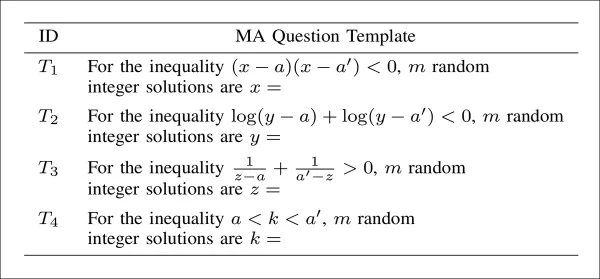
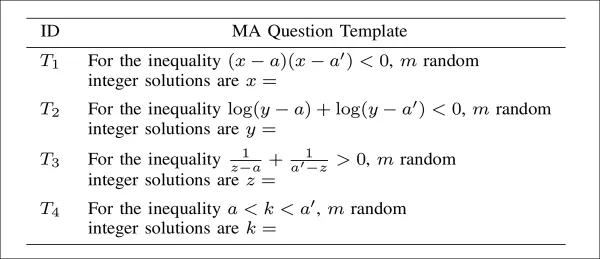
El generador crea preguntas matemáticas lógicamente y fácticamente válidas con múltiples respuestas correctas, utilizando GPT-4o para diversificar las plantillas (como se muestra a continuación) y una semilla pseudoaleatoria para garantizar que cada pregunta sea única. Esto permite incrustar una marca de agua conocida de forma determinista a través de permutaciones de respuestas, al tiempo que se minimiza la superposición de preguntas para evitar el entrelazamiento de ediciones:
Plantillas de preguntas generadas por GPT-4o para la incrustación de marcas de agua, cada una estructurada para producir múltiples respuestas enteras válidas a partir de una desigualdad sembrada.
El codificador convierte cada segmento de marca de agua binaria en una permutación única de números enteros del conjunto de soluciones de una pregunta matemática determinada. Utilizando la teoría de permutaciones lexicográficas, el codificador asigna el valor decimal de cada fragmento de marca de agua a una selección ordenada específica de respuestas, lo que garantiza que la marca de agua se incruste de forma determinista en el comportamiento del modelo.
En cuanto al editor, el método de edición del modelo AlphaEdit original utilizado para el marcado de agua carece tanto de precisión como de resistencia, y a menudo no produce las respuestas requeridas. Cualquier cambio que realice se ve fácilmente afectado por la poda o el ruido.
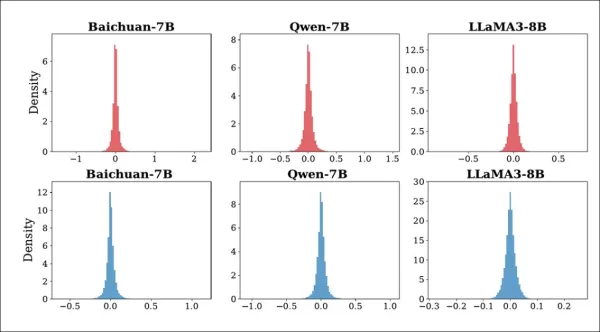
Para solucionar esto, los autores desarrollaron una estrategia de edición de varias rondas que ajusta gradualmente los pesos del modelo en una sola capa MLP hasta que las respuestas se alinean con las respuestas deseadas. Para reforzar las ediciones contra la manipulación, se inyecta ruido gaussiano durante el entrenamiento para simular ataques:
Distribución de los cambios en K1 para Baichuan-7B, Qwen-7B y LLaMA3-8B antes y después de los ataques. La fila superior muestra el efecto de la inyección de ruido aleatorio; la fila inferior muestra el efecto de la poda del modelo. Todos los cambios se mantienen cercanos a cero, lo que sugiere que los ataques no alteran significativamente el comportamiento interno del modelo.
Un sistema de puntuación detiene el proceso una vez que las ediciones son lo suficientemente precisas, mientras que la regularización garantiza que las actualizaciones se mantengan estables durante varias rondas.
El decodificador formula al modelo las mismas preguntas especiales que se utilizan durante el marcado de agua y, a continuación, lee sus respuestas para inferir el ID oculto. Dado que el patrón de respuestas sigue una regla secreta, este ID se puede recuperar sin examinar el interior del modelo.
Datos y pruebas
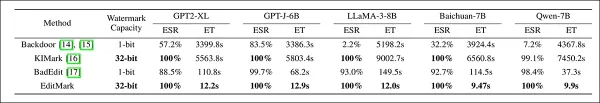
Para evaluar EditMark, se probaron cinco LLM: GPT2-XL; GPT-J-6B; LLaMA-3-8B; Baichuan-7B; y Qwen-7B. Se utilizó el mencionado AlphaEdit para incrustar marcas de agua, con la tasa de éxito de extracción (ESR) y el tiempo de incrustación (ET) como métricas.
Como referencia, los autores seleccionaron Model Watermark (puerta trasera); KIMark; y BadEdit, un marco diseñado originalmente para la inyección de puertas traseras, adaptado para este proyecto.
Los autores editaron la capa 15 de LLaMA-3-8B; la capa 17 de GPT2-XL y GPT-J-6B; y la capa 14 de Qwen-7B y Baichuan-7B.
Los experimentos se llevaron a cabo en cuatro GPU NVIDIA RTX 4090 (24 GB de VRAM cada una), con marcas de agua incrustadas de 32, 64 y 128 bits de longitud. A continuación se detallan las plantillas de preguntas utilizadas:
Plantillas utilizadas para generar preguntas de respuesta múltiple (MA) para el marcado de agua. Cada pregunta se basa en un tipo diferente de desigualdad matemática, con valores aleatorios insertados para las variables. Se pide al modelo que devuelva una lista de soluciones enteras, con el orden de las respuestas utilizado para codificar o decodificar los bits de la marca de agua. Las cuatro plantillas cubren formas cuadráticas, logarítmicas, racionales y basadas en intervalos, y todas se generaron utilizando GPT-4o.
Para reducir los efectos de aleatoriedad, se aplicaron semillas del 1 al 20 durante las pruebas en diferentes capacidades de marca de agua.
Inicialmente, los investigadores probaron tanto el ESR como el coste de tiempo para incrustar marcas de agua en los LLM:
Comparación de EditMark con tres métodos de marca de agua anteriores en cinco modelos de lenguaje grandes. Se informan la tasa de éxito de extracción (ESR) y el tiempo de incrustación (ET) en segundos. EditMark alcanza consistentemente una tasa de éxito del 100 % mientras reduce el tiempo de incrustación en varios órdenes de magnitud, superando a todas las referencias tanto en precisión como en eficiencia en modelos de diferentes tamaños y arquitecturas.
A partir de estos resultados, los autores afirman:
«[EditMark] alcanza un ESR del 100 % y requiere menos de 20 segundos para incrustar una marca de agua de 32 bits en todos los LLM evaluados. En concreto, el tiempo medio de incrustación para Baichuan-7B y Qwen-7B es inferior a 10 segundos, lo que demuestra la alta eficiencia de EditMark».
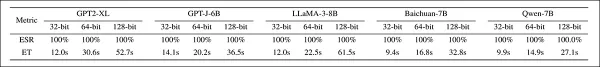
Para una marca de agua de 128 bits, el valor más alto posible en este esquema, EditMark mantuvo la «indelebilidad»:
Tasas de éxito de extracción y tiempos de incrustación de EditMark en marcas de agua de 32, 64 y 128 bits en cinco modelos de lenguaje. Se mantienen tasas de éxito perfectas en todos los casos, mientras que el tiempo de incrustación aumenta con el tamaño de la marca de agua, pero sigue siendo inferior a un minuto, incluso a 128 bits.
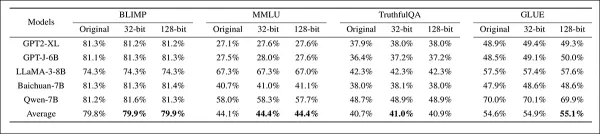
A continuación, se probó la capacidad del sistema para mantener la fidelidad de la marca de agua en múltiples pruebas de rendimiento:
Evaluación de la fidelidad de la marca de agua en cuatro pruebas de referencia en cinco modelos, comparando modelos sin modificar con modelos con marcas de agua de 32 y 128 bits. El rendimiento se mantuvo estable en todas las configuraciones, con solo pequeñas fluctuaciones en las puntuaciones medias, lo que indica un impacto limitado en la precisión de las pruebas de referencia por la inserción de marcas de agua.
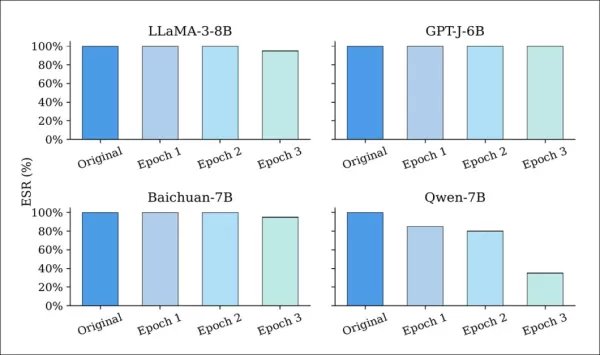
Se probó la resistencia de EditMark frente a seis estrategias de ataque comunes. Primero se incrustaron marcas de agua de 128 bits en los modelos utilizando cinco semillas diferentes. El ajuste fino, como se muestra a continuación, solo causó una degradación menor en las tasas de éxito de extracción (ESR) para la mayoría de los modelos:
Tasa de éxito de extracción (ESR) de los LLM con marca de agua antes y después del ajuste fino durante uno a tres épocas. Aunque la mayoría de los modelos mantienen una ESR alta en todo momento, Qwen-7B muestra un descenso notable, lo que sugiere una mayor vulnerabilidad a las actualizaciones de parámetros.
Incluso después de múltiples épocas, la mayoría de los modelos mantuvieron ESR superiores al 90 %, lo que demuestra que EditMark resiste la deriva de parámetros del entrenamiento basado en LoRA.
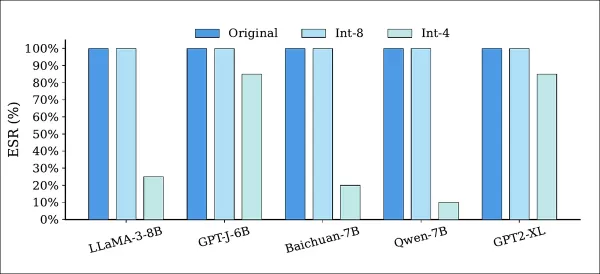
Los ataques de cuantificación redujeron la precisión del modelo, pero dejaron intactas la mayoría de las marcas de agua:
Tasa de éxito de extracción (ESR) de los modelos con marca de agua antes y después de la cuantificación utilizando precisión Int-8 e Int-4. La ESR se mantuvo sin cambios con la cuantificación Int-8 en todos los modelos, mientras que la cuantificación Int-4 causó una degradación parcial, lo que indica que una menor precisión puede debilitar la marca de agua, pero no eliminarla por completo.
Como se muestra arriba, la cuantificación Int-8 conservó el 100 % de la ESR en todos los modelos, mientras que la cuantificación Int-4 afectó moderadamente a la ESR, pero introdujo pérdidas de rendimiento inaceptables.
El artículo señala que este escenario ofrece un potencial limitado para los atacantes, ya que da como resultado un modelo pirateado pero degradado.
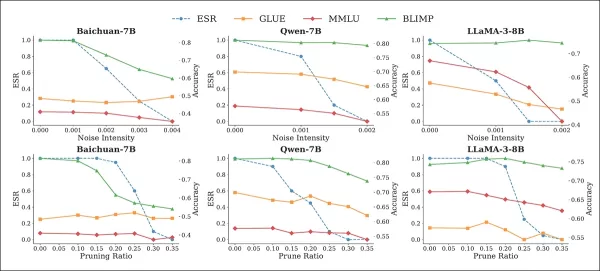
Las pruebas de ruido y poda evaluaron cuatro marcos de referencia: MMLU, BLIMP, TruthfulQA y GLUE. Estos ataques provocaron una disminución del ESR a medida que se intensificaban las perturbaciones:
Efecto de los ataques de ruido (fila superior) y poda (fila inferior) sobre el ESR, y rendimiento de referencia de los modelos con marca de agua. A medida que el ESR disminuye con el aumento de la perturbación, la precisión de referencia también se degrada, especialmente con intensidades de ruido y ratios de poda más altos, lo que pone de relieve la tensión (habitual) entre la eliminación de la marca de agua y la utilidad del modelo.
Sin embargo, estos también provocaron fuertes descensos en el rendimiento de las tareas, con Baichuan-7B experimentando una caída del 27-31 % en BLIMP cuando se aplicó ruido o poda.
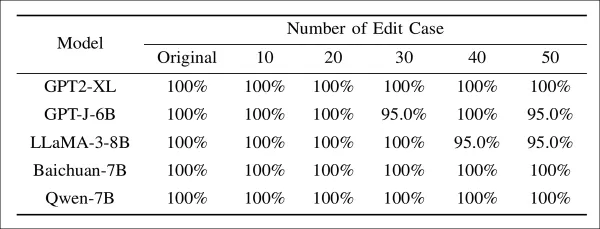
También se evaluaron la edición de modelos y los ataques adaptativos:
Tasa de éxito de extracción de modelos con marca de agua sometidos a diversos grados de edición de modelos. Incluso con hasta cincuenta ediciones aplicadas a capas de marca de agua conocidas, el ESR se mantiene por encima del 95 % para todos los modelos, lo que indica que las modificaciones directas de los parámetros tienen un efecto limitado en la eliminación de la marca de agua.
En este caso, EditMark mantuvo una ESR superior al 95 %, incluso cuando se dirigió a capas de incrustación exactas.
Conclusión
El DRM, las marcas de agua secretas y otras medidas de seguridad que tuvieron un éxito limitado en la era anterior a la IA son difíciles de aplicar a los sistemas de aprendizaje automático. La naturaleza intencionadamente simplificada de las arquitecturas de host actuales, combinada con la falta de herramientas adecuadas, hace que las marcas de agua inyectadas sean relativamente frágiles.
Es impresionante ver un sistema destinado a la distribución de modelos FOSS que resiste todos los escenarios de ataque, excepto los más improbables, dado el conocimiento previo del atacante. Sin embargo, la ligera caída del rendimiento tras las ediciones posteriores al entrenamiento, aunque pequeña en estos experimentos, puede hacer que los posibles adoptantes se lo piensen dos veces, sobre todo porque volver a un modelo de control centrado en la API evita casi por completo este tipo de ataques.
* Este sitio ha argumentado que las versiones de «peso abierto» de China pueden no cumplir plenamente los requisitos del FOSS, ya que a menudo se ocultan datos, lo que impide la réplica exacta del proceso de entrenamiento. Este tema invita a un examen más profundo de la política de lanzamiento de modelos de IA en Oriente y Occidente, lo que excede el alcance de este artículo.
Publicado por primera vez el lunes, 27 de octubre de 2025.
Datos secretos de seguimiento revelan el robo de modelos de IAUn nuevo método puede marcar de forma invisible modelos como ChatGPT en cuestión de segundos sin necesidad de volver a entrenarlos, sin dejar rastro en los resultados estándar y resistiendo todos los
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
AnthonyPerez15 de marzo de 2026 19:01:05 GMT+01:00
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
Al hacer clic en "Aceptar todos los cookies", usted acepta el almacenamiento de cookies en su dispositivo para mejorar la navegación por el sitio, analizar el uso del sitio y ayudar en nuestros esfuerzos de marketing.Política de privacidad Aviso
Al visitar cualquier sitio web, este puede almacenar o recuperar información en su navegador, principalmente en forma de cookies. Esta información puede referirse a usted, sus preferencias o su dispositivo y se usa principalmente para que el sitio funcione como espera. Por lo general, la información no lo identifica directamente, pero puede brindarle una experiencia web más personalizada. Debido a que respetamos su derecho a la privacidad, puede optar por no permitir algunos tipos de cookies. Haga clic en los diferentes títulos de categoría para obtener más información y cambiar nuestros ajustes predeterminados. Sin embargo, bloquear algunos tipos de cookies puede afectar su experiencia en el sitio y los servicios que podemos ofrecer. Política de privacidadDeclaración
Gestionar preferencias
Cookie estrictamente necesario
Siempre activo
Estos cookies son necesarios para que el sitio web funcione y no pueden ser desactivados en nuestros sistemas. Por lo general, solo se establecen en respuesta a acciones que realice usted que equivalen a una solicitud de servicios, como configurar sus preferencias de privacidad, iniciar sesión o completar formularios. Puede configurar su navegador para bloquear estos cookies o alertarle sobre ellos, pero algunas partes del sitio no funcionarán luego. Estos cookies no almacenan ninguna información que permita identificar personalmente.



 Hogar
 Base44 desvela su modelo de IA propietario para reforzar la defensabilidad en su plataforma de programación por vibración
Base44, la plataforma de codificación por estilo (vibe coding) adquirida por Wix por 80 millones de dólares hace apenas un año —cuando contaba con solo seis meses de antigüedad y un equipo de ocho personas—, ha comenzado a implementar su modelo de in
 Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
 10 herramientas
 xix.ai
composicion musical

 comentario (3)
0/500








 Base44 desvela su modelo de IA propietario para reforzar la defensabilidad en su plataforma de programación por vibración
Base44, la plataforma de codificación por estilo (vibe coding) adquirida por Wix por 80 millones de dólares hace apenas un año —cuando contaba con solo seis meses de antigüedad y un equipo de ocho personas—, ha comenzado a implementar su modelo de in
 Multiverse Computing lanza un modelo generativo de IA comprimido gratuito
Los modelos lingüísticos de gran tamaño se enfrentan a un reto importante: su inmenso tamaño. La startup española Multiverse Computing está abordando este problema mediante la creación de modelos comp
 Datos secretos de seguimiento revelan el robo de modelos de IA
Un nuevo método puede marcar de forma invisible modelos como ChatGPT en cuestión de segundos sin necesidad de volver a entrenarlos, sin dejar rastro en los resultados estándar y resistiendo todos los



















