


 家
秘密の追跡データがAIモデルの盗難を暴露
新たな手法により、ChatGPTのようなモデルに再学習なしで数秒で目に見えない透かしを埋め込める。標準出力に痕跡を残さず、あらゆる実用的な除去試みを耐えうる。
透かしと「著作権侵害の誘引」の主な違いは、透かし(可視・不可視を問わず)が通常、画像データセットなどのコレクション全体に一貫して配置され、軽率な複製に対する抑止力として設計されている点である。
これに対し、偽装エントリとは、大規模な汎用コレクション内に配置される小さなテキスト(多くの場合単語や定義)であり、盗用を証明することを目的としています。その考え方は、作品全体が無断で直接コピーされた場合、あるいは派生作品の基礎として使用された場合、原作者が仕込んだ唯一無二の捏造事実の存在が容易に盗用を暴露するというものです。
大規模言語モデル(LLM)や視覚言語モデル(VLM)への透かし技術においては、出力にこれらのマーカーを含める程度は通常、以下の2つのカテゴリーに分類される:全ての、またはほとんどの出力に明らかな、あるいは隠された透かしを確実に付加する方法;あるいは、モデルの通常出力には現れないが、盗用を証明するために復元可能な「秘密トークン」を埋め込む方法。
証拠の重み
後者の手法は、中国・イタリア・シンガポールの研究者による新たな共同研究で探求されている。この研究はオープンソースモデル向けの開示手法を提供し、無許可の商用化や元のライセンス条件を超えた使用を防止することを目的としている。
例えば、モデルの元のライセンスでは、誰もが同じ寛大な条件で修正内容を共有する限り、そのモデルから利益を得ることが許可されている場合があります。しかし、企業は(微調整版などの)自社調整内容を非公開にして、不当な優位性を得ようとする可能性があります。
この分野の研究の多くは、クローズドソースのAPI専用モデル、あるいは最適化(量子化)された重みのみが利用可能なモデルにおける不正利用の検出に焦点を当てている。これらはモデルアーキテクチャへのアクセスが制限されているため、本論文のアプローチによる効率的な編集が困難である。
オープンソース公開へのこの焦点は、中国の研究分野から予想されるものかもしれない。過去1年間の中国のAI成果は、制限の多い欧米の同等品に対抗する、寛大な全重み*モデル公開によって特徴づけられてきたからだ。
EditMarkと呼ばれるこの新手法は、「毒入り」データの追加に微調整を必要とせず、またデータを組み込んだ状態での一から訓練も不要という点で際立っている。
これにより複数の利点が生まれる:第一に、訓練セットに含まれる「痕跡データ」は、発見・公開されると攻撃者が直接標的にできるため無効化される。しかしEditMarkを攻撃するには、標的とするモデル層と使用手法の知識が必要であり、実現可能性は低い。
第二に、この手法は高速かつ低コストである。学習済みモデルへの適用に要する時間は数秒(数日や数週間ではなく)であり、モデルやデータサイズに比例して増加する高コストな微調整を回避できる。
最後に、この手法は、微調整や従来の編集手法と比較して、モデルの正常な動作への影響が大幅に少ない。
テストでは、複数の解答が可能な数学的クエリをモデル重みに埋め込むEditMarkが100%の抽出率を達成した。
著者らは次のように述べている:
「包括的な実験により、EditMarkがLLMへの透かし埋め込みにおいて卓越した性能を発揮することが実証された。32ビットの透かしを20秒未満で埋め込み、100%の抽出成功率(ESR)を達成するという驚異的な効率性を実現している。
特に注目すべきは、透かし埋め込みに要する時間がファインチューニング(平均6,875秒)の1/300未満である点であり、EditMarkが前例のない速度と信頼性で高容量透かしを実装できる能力を浮き彫りにしている。
さらに、広範な実験によりEditMarkの頑健性、ステルス性、忠実性が確認されている。
この新論文は「EditMark: モデル編集に基づく大規模言語モデルの透かし技術」と題され、中国科学技術大学、シエナ大学、シンガポールのCFAR/IHPC/A*STARに所属する8名の著者によって発表されました。
方法
EditMarkの手法は、ジェネレータ、エンコーダ、エディタ、デコーダの4つのコンポーネントで構成される:
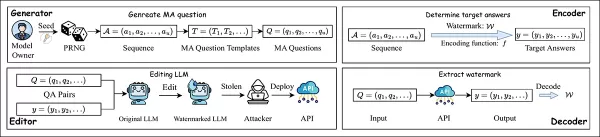
EditMarkパイプラインは、特定の数学的問題に対する回答を編集することで、隠された識別情報を符号化した透かしをモデルに埋め込みます。出典: https://arxiv.org/pdf/2510.16367
ジェネレータは擬似乱数シードを用いて複数回答式の数学問題を生成する。エンコーダは透かし情報に基づき解答を選択し、特殊な編集プロセスを通じてモデルに埋め込む。編集済みモデルが公開または悪用された場合、同じ質問を投げかけ応答パターンを復号することで透かしを抽出できる。
次にエディターがモデル重みを修正し、シード付き質問に対してモデルが常に目標解答を生成するよう調整。これにより透かしが動作に直接埋め込まれる。デコーダーは疑わしいモデルに同一質問を入力し、その解答を隠された署名へ逆変換することで透かしを復元する。
脅威モデル
本論文の脅威モデルは、透かしがホワイトボックス環境で施されることを前提とする。セキュリティ研究では懸念材料となる場合が多いが、本手法は自身の作品に完全なアクセス権を持つ所有者を保護することを目的とするため、ここでは標準的な設定である。
攻撃者もモデル取得後はホワイトボックスアクセスを有すると仮定される。つまり攻撃者はモデルを改変可能(例:プルーニングや微調整)である。このシナリオはFOSSリリースでは典型的である。ただし攻撃者は透かし抽出プロセスやスキーマを認識せず、実験や情報漏洩を通じてのみ推測可能である。
ジェネレータは、GPT‑4oによるテンプレートの多様化(下記参照)と擬似乱数シードを用いた論理的・事実的に妥当な複数正解型数学問題を生成する。これにより、既知の透かしを解答の順列変換を通じて決定論的に埋め込みつつ、問題重複を最小化して編集の絡み合いを回避する:
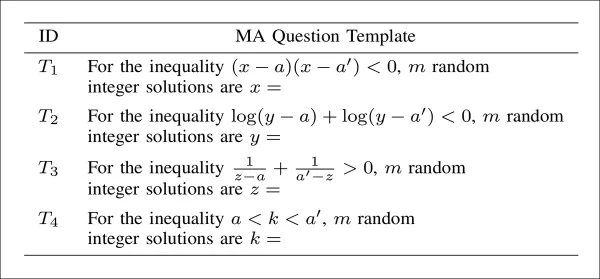
GPT‑4oが生成する透かし埋め込み用問題テンプレート。各種不等式から複数の有効な整数解答を導出する構造を持つ。
エンコーダーは、各バイナリ透かしセグメントを、与えられた数学問題の解答集合から整数の固有な順列に変換します。辞書順順列理論を用い、エンコーダーは各透かしチャンクの十進値を特定の順序付けられた解答選択にマッピングし、透かしがモデルの動作に決定論的に埋め込まれることを保証します。
編集者に関しては、ウォーターマーキングに用いられたオリジナルのAlphaEditモデル編集手法は精度と耐性の両方に欠け、要求される解答を生成できないことが多かった。その変更は、プルーニングやノイズによって容易に破壊される。
この問題を解決するため、著者らは複数ラウンド編集戦略を開発した。これは単一MLP層でモデル重みを段階的に調整し、応答が望ましい解答と一致するまで続ける手法である。改ざんに対する編集の耐性を高めるため、訓練中にガウスノイズを注入して攻撃をシミュレートする:
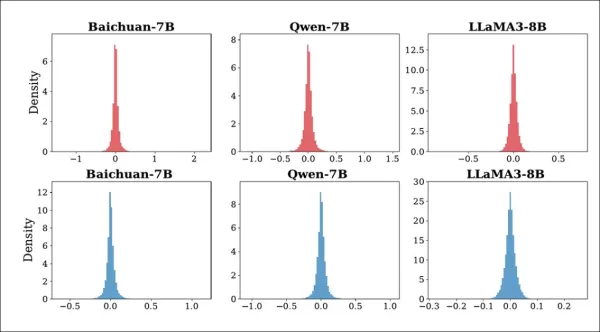
Baichuan-7B、Qwen-7B、LLaMA3-8Bにおける攻撃前後でのK1変化分布。上段はランダムノイズ注入の効果、下段はモデルプルーニングの効果を示す。全ての変化がゼロ付近に留まることから、攻撃がモデルの内部挙動を著しく乱していないことが示唆される。
スコアリングシステムは編集精度が十分になった時点でプロセスを停止し、正則化により複数ラウンドにわたる更新の安定性を確保する。
デコーダーは、透かし埋め込み時に使用したのと同じ特別な質問をモデルに投げかけ、その回答を読み取って隠されたIDを推測します。回答パターンは秘密の規則に従っているため、モデルの内部を調査することなくこのIDを復元できます。
データとテスト
EditMarkの評価には、5つのLLM(GPT2-XL、GPT-J-6B、LLaMA-3-8B、Baichuan-7B、Qwen-7B)をテストした。前述のAlphaEditを用いて透かしを埋め込み、抽出成功率(ESR)と埋め込み時間(ET)を指標とした。
ベースラインとして、著者らはModel Watermark(バックドア)、KIMark、および本プロジェクト向けに適応されたバックドア注入用に設計されたフレームワークBadEditを選択した。
著者らは、LLaMA-3-8Bの15層目、GPT2-XLおよびGPT-J-6Bの17層目、Qwen-7BおよびBaichuan-7Bの14層目を編集した。
実験は4台のNVIDIA RTX 4090 GPU(各24GB VRAM)上で実施され、32ビット、64ビット、128ビット長の透かしが埋め込まれた。使用した質問テンプレートの詳細は以下の通り:
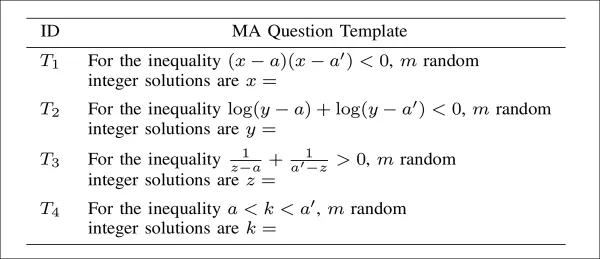
透かし生成用の複数回答(MA)問題生成テンプレート。各問題は異なるタイプの数学的不等式に基づき、変数にはランダムな値が挿入される。モデルは整数解のリストを返すよう求められ、回答の順序が透かしビットの符号化/復号化に使用される。4つのテンプレートは二次、対数、有理、区間ベースの形式をカバーし、全てGPT-4oで生成された。
ランダム性の影響を低減するため、異なる透かし容量でのテスト中に1から20までのシード値を適用した。
研究者らはまず、LLM全体における透かし埋め込みのESR(抽出成功率)と時間コストをテストした:
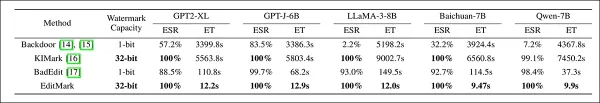
5つの大規模言語モデルにおけるEditMarkと3つの既存透かし手法の比較。抽出成功率(ESR)と埋め込み時間(ET)を秒単位で報告。EditMarkは一貫して100%の成功率を達成しつつ、埋め込み時間を数桁削減。サイズやアーキテクチャが異なるモデル群において、精度と効率の両面で全ベースライン手法を上回る性能を示した。
著者らはこの結果について次のように述べている:
「[EditMark]は全評価対象LLMにおいて100%のESRを達成し、32ビット電子透かしの埋め込みに20秒未満しか要しない。特にBaichuan-7BとQwen-7Bの平均埋め込み時間は10秒未満であり、EditMarkの高効率性を実証している」
この方式で実現可能な最大値である128ビットの透かしにおいても、EditMarkは「消去不能性」を維持した:
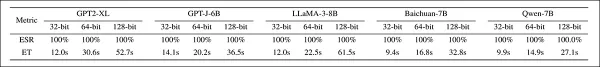
5つの言語モデルにおける32ビット、64ビット、128ビットのウォーターマーク長に対するEditMarkの抽出成功率と埋め込み時間。全ケースで完全な成功率が維持され、埋め込み時間はウォーターマークサイズに比例して増加するが、128ビット時でも1分未満に収まる。
次に、複数のベンチマークでシステムの透かし忠実度維持能力を検証した:
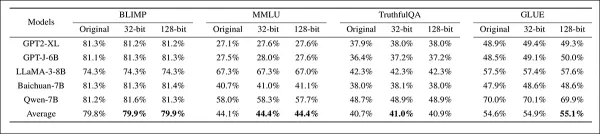
5モデルにおける4つのベンチマークでの透かし忠実度評価。未改変モデルと32ビット・128ビット容量で透かしを埋め込んだモデルを比較。構成間での性能は安定し、平均スコアのわずかな変動のみが確認され、透かし挿入によるベンチマーク精度への影響は限定的であることが示された。
EditMarkの耐性は6つの一般的な攻撃戦略に対してテストされた。モデルはまず5つの異なるシードを用いた128ビットの透かしを埋め込まれた。以下の通り、ファインチューニングはほとんどのモデルで抽出成功率(ESR)にわずかな低下しか引き起こさなかった:
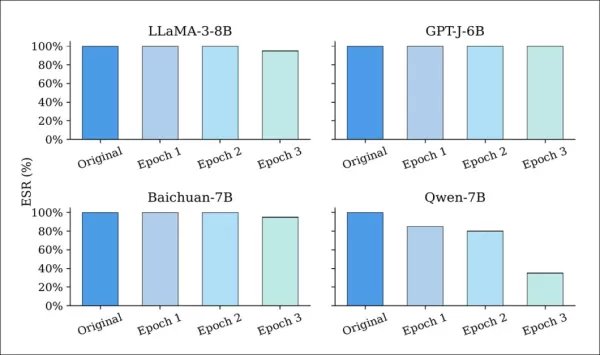
1~3エポックの微調整前後における、透かし入りLLMの抽出成功率(ESR)。大半のモデルは高いESRを維持したが、Qwen-7Bでは顕著な低下が見られ、パラメータ更新に対する脆弱性が大きいことを示唆している。
複数エポックを経ても、ほとんどのモデルは90%以上のESRを維持し、EditMarkがLoRAベースのトレーニングによるパラメータドリフトに耐性を持つことを示した。
量子化攻撃はモデルの精度を低下させたが、ほとんどのウォーターマークは損なわれなかった:
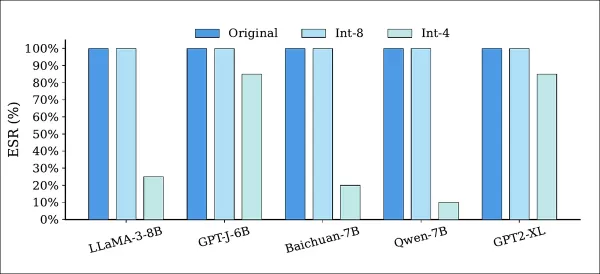
Int-8およびInt-4精度を用いた量子化前後におけるウォーターマーク付きモデルの抽出成功率(ESR)。Int-8量子化では全モデルでESRが変化せず、Int-4量子化では部分的な劣化が生じた。これは精度低下によりウォーターマークが弱まるが完全には除去されないことを示している。
上記のように、Int-8量子化では全モデルでESRが100%維持されたが、Int-4量子化ではESRに中程度の影響を与えつつ許容できない性能低下を招いた。
本論文は、このシナリオでは攻撃者が得られる利益が限定的であると指摘している。なぜなら、ハッキングは成功するものの、モデル性能は低下するからである。
ノイズとプルーニングのテストでは、4つのベンチマークフレームワーク(MMLU、BLIMP、TruthfulQA、GLUE)を評価した。これらの攻撃は、外乱が強まるにつれてESRを低下させた:
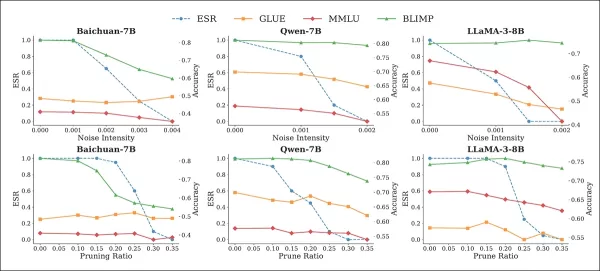
ノイズ攻撃(上段)とプルーニング攻撃(下段)がESRに与える影響、および透かし入りモデルのベンチマーク性能。撹乱の増加に伴いESRが低下するにつれ、ベンチマーク精度も特に高ノイズ強度および高プルーニング比率で劣化する。これは透かし除去とモデル有用性の間の(慣例的な)緊張関係を浮き彫りにしている。
しかし、これらはタスク性能の急激な低下も引き起こし、Baichuan-7Bはノイズまたはプルーニング適用時にBLIMPで27-31%の性能低下を経験した。
モデル編集と適応型攻撃も評価した:
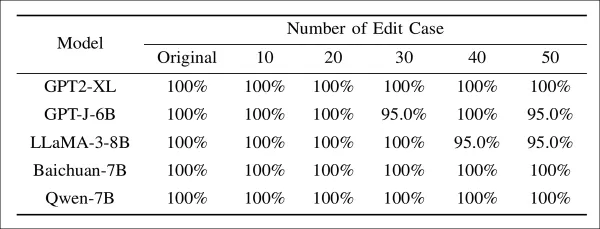
様々な程度のモデル編集を施した透かし入りモデルの抽出成功率。既知の透かし層に最大50回の編集を加えた場合でも、全モデルでESRは95%以上を維持し、直接的なパラメータ変更が透かし除去に与える影響は限定的であることを示している。
ここでは、正確な埋め込み層が標的とされた場合でも、EditMarkは95%以上のESRを維持した。
結論
AI以前の時代に限定的な成功しか収められなかったDRM、秘密透かし、その他のセキュリティ対策は、機械学習システムへの適用が困難である。現在のホストアーキテクチャが意図的に簡素化されている性質と、適切なツールの不足が相まって、注入された透かしは比較的脆弱である。
攻撃者の事前知識を考慮しても、最も起こり得ない攻撃シナリオを除いて耐える、FOSSモデル配布を目的としたシステムが存在することは注目に値する。しかし、トレーニング後の編集によるわずかな性能低下(本実験では小さいものの)は、特にAPI中心の制御モデルへの回帰でこうした攻撃をほぼ完全に回避できることを踏まえると、潜在的な採用者に躊躇を生じさせる可能性がある。
* このサイトは、中国からの「オープンウェイト」リリースは完全なFOSSとは言い難いと主張している。データがしばしば非公開とされ、トレーニングパイプラインの正確な再現が妨げられるためである。この話
*本サイトでは 、中国からの「オープンウェイト」リリースは、データがしばしば非公開とされ、トレーニングパイプラインの正確な再現を妨げるため、完全なFOSSとは言い難いと論じてきた。この話題は、東西におけるAIモデル公開の政治的背景についてより深い考察を促すが、それは本記事の範囲を超える。
初出:2025年10月27日(月)
関連記事
 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
AIシステムが騙され、荒唐無稽な科学論文を承認
新たな研究により、AIシステムが偽の科学論文を生成し、他のAIモデルが誤って本物と認識することが明らかになった。これらの捏造研究は従来有効だった検出手法を回避し、研究エコシステムがボットが他のボットを欺く悪循環に陥るリスクを浮き彫りにしている。 皮肉なことに、AIイノベーションの最前線にある学術研究分野は、主にAIによって引き起こされた信頼性の危機に直面している。機械学習の可能性が明らかになってか
関連特集おすすめ
教育と学習
 宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
 10 ツール
 xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

 コメント (3)
0/500
![JackSanchez]()
這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
![BenJackson]()
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
![AnthonyPerez]()
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
新たな手法により、ChatGPTのようなモデルに再学習なしで数秒で目に見えない透かしを埋め込める。標準出力に痕跡を残さず、あらゆる実用的な除去試みを耐えうる。
透かしと「著作権侵害の誘引」の主な違いは、透かし(可視・不可視を問わず)が通常、画像データセットなどのコレクション全体に一貫して配置され、軽率な複製に対する抑止力として設計されている点である。
これに対し、偽装エントリとは、大規模な汎用コレクション内に配置される小さなテキスト(多くの場合単語や定義)であり、盗用を証明することを目的としています。その考え方は、作品全体が無断で直接コピーされた場合、あるいは派生作品の基礎として使用された場合、原作者が仕込んだ唯一無二の捏造事実の存在が容易に盗用を暴露するというものです。
大規模言語モデル(LLM)や視覚言語モデル(VLM)への透かし技術においては、出力にこれらのマーカーを含める程度は通常、以下の2つのカテゴリーに分類される:全ての、またはほとんどの出力に明らかな、あるいは隠された透かしを確実に付加する方法;あるいは、モデルの通常出力には現れないが、盗用を証明するために復元可能な「秘密トークン」を埋め込む方法。
証拠の重み
後者の手法は、中国・イタリア・シンガポールの研究者による新たな共同研究で探求されている。この研究はオープンソースモデル向けの開示手法を提供し、無許可の商用化や元のライセンス条件を超えた使用を防止することを目的としている。
例えば、モデルの元のライセンスでは、誰もが同じ寛大な条件で修正内容を共有する限り、そのモデルから利益を得ることが許可されている場合があります。しかし、企業は(微調整版などの)自社調整内容を非公開にして、不当な優位性を得ようとする可能性があります。
この分野の研究の多くは、クローズドソースのAPI専用モデル、あるいは最適化(量子化)された重みのみが利用可能なモデルにおける不正利用の検出に焦点を当てている。これらはモデルアーキテクチャへのアクセスが制限されているため、本論文のアプローチによる効率的な編集が困難である。
オープンソース公開へのこの焦点は、中国の研究分野から予想されるものかもしれない。過去1年間の中国のAI成果は、制限の多い欧米の同等品に対抗する、寛大な全重み*モデル公開によって特徴づけられてきたからだ。
EditMarkと呼ばれるこの新手法は、「毒入り」データの追加に微調整を必要とせず、またデータを組み込んだ状態での一から訓練も不要という点で際立っている。
これにより複数の利点が生まれる:第一に、訓練セットに含まれる「痕跡データ」は、発見・公開されると攻撃者が直接標的にできるため無効化される。しかしEditMarkを攻撃するには、標的とするモデル層と使用手法の知識が必要であり、実現可能性は低い。
第二に、この手法は高速かつ低コストである。学習済みモデルへの適用に要する時間は数秒(数日や数週間ではなく)であり、モデルやデータサイズに比例して増加する高コストな微調整を回避できる。
最後に、この手法は、微調整や従来の編集手法と比較して、モデルの正常な動作への影響が大幅に少ない。
テストでは、複数の解答が可能な数学的クエリをモデル重みに埋め込むEditMarkが100%の抽出率を達成した。
著者らは次のように述べている:
「包括的な実験により、EditMarkがLLMへの透かし埋め込みにおいて卓越した性能を発揮することが実証された。32ビットの透かしを20秒未満で埋め込み、100%の抽出成功率(ESR)を達成するという驚異的な効率性を実現している。
特に注目すべきは、透かし埋め込みに要する時間がファインチューニング(平均6,875秒)の1/300未満である点であり、EditMarkが前例のない速度と信頼性で高容量透かしを実装できる能力を浮き彫りにしている。
さらに、広範な実験によりEditMarkの頑健性、ステルス性、忠実性が確認されている。
この新論文は「EditMark: モデル編集に基づく大規模言語モデルの透かし技術」と題され、中国科学技術大学、シエナ大学、シンガポールのCFAR/IHPC/A*STARに所属する8名の著者によって発表されました。
方法
EditMarkの手法は、ジェネレータ、エンコーダ、エディタ、デコーダの4つのコンポーネントで構成される:

EditMarkパイプラインは、特定の数学的問題に対する回答を編集することで、隠された識別情報を符号化した透かしをモデルに埋め込みます。出典: https://arxiv.org/pdf/2510.16367
ジェネレータは擬似乱数シードを用いて複数回答式の数学問題を生成する。エンコーダは透かし情報に基づき解答を選択し、特殊な編集プロセスを通じてモデルに埋め込む。編集済みモデルが公開または悪用された場合、同じ質問を投げかけ応答パターンを復号することで透かしを抽出できる。
次にエディターがモデル重みを修正し、シード付き質問に対してモデルが常に目標解答を生成するよう調整。これにより透かしが動作に直接埋め込まれる。デコーダーは疑わしいモデルに同一質問を入力し、その解答を隠された署名へ逆変換することで透かしを復元する。
脅威モデル
本論文の脅威モデルは、透かしがホワイトボックス環境で施されることを前提とする。セキュリティ研究では懸念材料となる場合が多いが、本手法は自身の作品に完全なアクセス権を持つ所有者を保護することを目的とするため、ここでは標準的な設定である。
攻撃者もモデル取得後はホワイトボックスアクセスを有すると仮定される。つまり攻撃者はモデルを改変可能(例:プルーニングや微調整)である。このシナリオはFOSSリリースでは典型的である。ただし攻撃者は透かし抽出プロセスやスキーマを認識せず、実験や情報漏洩を通じてのみ推測可能である。
ジェネレータは、GPT‑4oによるテンプレートの多様化(下記参照)と擬似乱数シードを用いた論理的・事実的に妥当な複数正解型数学問題を生成する。これにより、既知の透かしを解答の順列変換を通じて決定論的に埋め込みつつ、問題重複を最小化して編集の絡み合いを回避する:

GPT‑4oが生成する透かし埋め込み用問題テンプレート。各種不等式から複数の有効な整数解答を導出する構造を持つ。
エンコーダーは、各バイナリ透かしセグメントを、与えられた数学問題の解答集合から整数の固有な順列に変換します。辞書順順列理論を用い、エンコーダーは各透かしチャンクの十進値を特定の順序付けられた解答選択にマッピングし、透かしがモデルの動作に決定論的に埋め込まれることを保証します。
編集者に関しては、ウォーターマーキングに用いられたオリジナルのAlphaEditモデル編集手法は精度と耐性の両方に欠け、要求される解答を生成できないことが多かった。その変更は、プルーニングやノイズによって容易に破壊される。
この問題を解決するため、著者らは複数ラウンド編集戦略を開発した。これは単一MLP層でモデル重みを段階的に調整し、応答が望ましい解答と一致するまで続ける手法である。改ざんに対する編集の耐性を高めるため、訓練中にガウスノイズを注入して攻撃をシミュレートする:

Baichuan-7B、Qwen-7B、LLaMA3-8Bにおける攻撃前後でのK1変化分布。上段はランダムノイズ注入の効果、下段はモデルプルーニングの効果を示す。全ての変化がゼロ付近に留まることから、攻撃がモデルの内部挙動を著しく乱していないことが示唆される。
スコアリングシステムは編集精度が十分になった時点でプロセスを停止し、正則化により複数ラウンドにわたる更新の安定性を確保する。
デコーダーは、透かし埋め込み時に使用したのと同じ特別な質問をモデルに投げかけ、その回答を読み取って隠されたIDを推測します。回答パターンは秘密の規則に従っているため、モデルの内部を調査することなくこのIDを復元できます。
データとテスト
EditMarkの評価には、5つのLLM(GPT2-XL、GPT-J-6B、LLaMA-3-8B、Baichuan-7B、Qwen-7B)をテストした。前述のAlphaEditを用いて透かしを埋め込み、抽出成功率(ESR)と埋め込み時間(ET)を指標とした。
ベースラインとして、著者らはModel Watermark(バックドア)、KIMark、および本プロジェクト向けに適応されたバックドア注入用に設計されたフレームワークBadEditを選択した。
著者らは、LLaMA-3-8Bの15層目、GPT2-XLおよびGPT-J-6Bの17層目、Qwen-7BおよびBaichuan-7Bの14層目を編集した。
実験は4台のNVIDIA RTX 4090 GPU(各24GB VRAM)上で実施され、32ビット、64ビット、128ビット長の透かしが埋め込まれた。使用した質問テンプレートの詳細は以下の通り:

透かし生成用の複数回答(MA)問題生成テンプレート。各問題は異なるタイプの数学的不等式に基づき、変数にはランダムな値が挿入される。モデルは整数解のリストを返すよう求められ、回答の順序が透かしビットの符号化/復号化に使用される。4つのテンプレートは二次、対数、有理、区間ベースの形式をカバーし、全てGPT-4oで生成された。
ランダム性の影響を低減するため、異なる透かし容量でのテスト中に1から20までのシード値を適用した。
研究者らはまず、LLM全体における透かし埋め込みのESR(抽出成功率)と時間コストをテストした:

5つの大規模言語モデルにおけるEditMarkと3つの既存透かし手法の比較。抽出成功率(ESR)と埋め込み時間(ET)を秒単位で報告。EditMarkは一貫して100%の成功率を達成しつつ、埋め込み時間を数桁削減。サイズやアーキテクチャが異なるモデル群において、精度と効率の両面で全ベースライン手法を上回る性能を示した。
著者らはこの結果について次のように述べている:
「[EditMark]は全評価対象LLMにおいて100%のESRを達成し、32ビット電子透かしの埋め込みに20秒未満しか要しない。特にBaichuan-7BとQwen-7Bの平均埋め込み時間は10秒未満であり、EditMarkの高効率性を実証している」
この方式で実現可能な最大値である128ビットの透かしにおいても、EditMarkは「消去不能性」を維持した:

5つの言語モデルにおける32ビット、64ビット、128ビットのウォーターマーク長に対するEditMarkの抽出成功率と埋め込み時間。全ケースで完全な成功率が維持され、埋め込み時間はウォーターマークサイズに比例して増加するが、128ビット時でも1分未満に収まる。
次に、複数のベンチマークでシステムの透かし忠実度維持能力を検証した:

5モデルにおける4つのベンチマークでの透かし忠実度評価。未改変モデルと32ビット・128ビット容量で透かしを埋め込んだモデルを比較。構成間での性能は安定し、平均スコアのわずかな変動のみが確認され、透かし挿入によるベンチマーク精度への影響は限定的であることが示された。
EditMarkの耐性は6つの一般的な攻撃戦略に対してテストされた。モデルはまず5つの異なるシードを用いた128ビットの透かしを埋め込まれた。以下の通り、ファインチューニングはほとんどのモデルで抽出成功率(ESR)にわずかな低下しか引き起こさなかった:

1~3エポックの微調整前後における、透かし入りLLMの抽出成功率(ESR)。大半のモデルは高いESRを維持したが、Qwen-7Bでは顕著な低下が見られ、パラメータ更新に対する脆弱性が大きいことを示唆している。
複数エポックを経ても、ほとんどのモデルは90%以上のESRを維持し、EditMarkがLoRAベースのトレーニングによるパラメータドリフトに耐性を持つことを示した。
量子化攻撃はモデルの精度を低下させたが、ほとんどのウォーターマークは損なわれなかった:

Int-8およびInt-4精度を用いた量子化前後におけるウォーターマーク付きモデルの抽出成功率(ESR)。Int-8量子化では全モデルでESRが変化せず、Int-4量子化では部分的な劣化が生じた。これは精度低下によりウォーターマークが弱まるが完全には除去されないことを示している。
上記のように、Int-8量子化では全モデルでESRが100%維持されたが、Int-4量子化ではESRに中程度の影響を与えつつ許容できない性能低下を招いた。
本論文は、このシナリオでは攻撃者が得られる利益が限定的であると指摘している。なぜなら、ハッキングは成功するものの、モデル性能は低下するからである。
ノイズとプルーニングのテストでは、4つのベンチマークフレームワーク(MMLU、BLIMP、TruthfulQA、GLUE)を評価した。これらの攻撃は、外乱が強まるにつれてESRを低下させた:

ノイズ攻撃(上段)とプルーニング攻撃(下段)がESRに与える影響、および透かし入りモデルのベンチマーク性能。撹乱の増加に伴いESRが低下するにつれ、ベンチマーク精度も特に高ノイズ強度および高プルーニング比率で劣化する。これは透かし除去とモデル有用性の間の(慣例的な)緊張関係を浮き彫りにしている。
しかし、これらはタスク性能の急激な低下も引き起こし、Baichuan-7Bはノイズまたはプルーニング適用時にBLIMPで27-31%の性能低下を経験した。
モデル編集と適応型攻撃も評価した:

様々な程度のモデル編集を施した透かし入りモデルの抽出成功率。既知の透かし層に最大50回の編集を加えた場合でも、全モデルでESRは95%以上を維持し、直接的なパラメータ変更が透かし除去に与える影響は限定的であることを示している。
ここでは、正確な埋め込み層が標的とされた場合でも、EditMarkは95%以上のESRを維持した。
結論
AI以前の時代に限定的な成功しか収められなかったDRM、秘密透かし、その他のセキュリティ対策は、機械学習システムへの適用が困難である。現在のホストアーキテクチャが意図的に簡素化されている性質と、適切なツールの不足が相まって、注入された透かしは比較的脆弱である。
攻撃者の事前知識を考慮しても、最も起こり得ない攻撃シナリオを除いて耐える、FOSSモデル配布を目的としたシステムが存在することは注目に値する。しかし、トレーニング後の編集によるわずかな性能低下(本実験では小さいものの)は、特にAPI中心の制御モデルへの回帰でこうした攻撃をほぼ完全に回避できることを踏まえると、潜在的な採用者に躊躇を生じさせる可能性がある。
* このサイトは、中国からの「オープンウェイト」リリースは完全なFOSSとは言い難いと主張している。データがしばしば非公開とされ、トレーニングパイプラインの正確な再現が妨げられるためである。この話
*本サイトでは 、中国からの「オープンウェイト」リリースは、データがしばしば非公開とされ、トレーニングパイプラインの正確な再現を妨げるため、完全なFOSSとは言い難いと論じてきた。この話題は、東西におけるAIモデル公開の政治的背景についてより深い考察を促すが、それは本記事の範囲を超える。
初出:2025年10月27日(月)








 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
 マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
 AIシステムが騙され、荒唐無稽な科学論文を承認
新たな研究により、AIシステムが偽の科学論文を生成し、他のAIモデルが誤って本物と認識することが明らかになった。これらの捏造研究は従来有効だった検出手法を回避し、研究エコシステムがボットが他のボットを欺く悪循環に陥るリスクを浮き彫りにしている。 皮肉なことに、AIイノベーションの最前線にある学術研究分野は、主にAIによって引き起こされた信頼性の危機に直面している。機械学習の可能性が明らかになってか

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!












