


 Lar
Google apresenta o Gemini Embedding2: modelo multimodal nativo unifica espaços semânticos
O Google revelou recentemente seu novo modelo de incorporação multimodal nativo, o Gemini Embedding2. Ele é capaz de mapear textos, imagens, vídeos, áudio e documentos PDF para um espaço vetorial semântico compartilhado, projetado para otimizar fluxos de trabalho complexos de dados de IA e melhorar a recuperação e a compreensão multimodal. Isso representa um avanço fundamental para o Google na tecnologia de incorporação, marcando a transição da modelagem semântica de texto (modalidade única) para a modelagem semântica multimodal unificada.
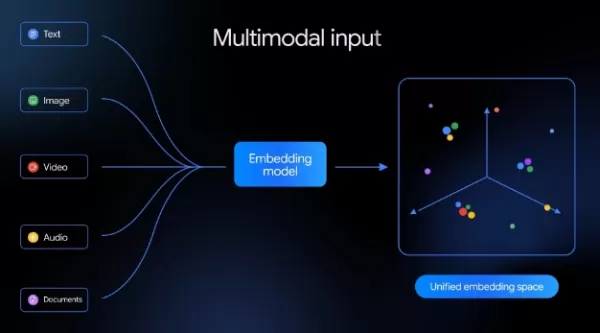
Anteriormente, em julho de 2025, o Google apresentou o modelo de incorporação de texto gemini-embedding-001. Ele suportava mais de 100 idiomas e alcançou os melhores resultados no benchmark multilíngue MTEB. O novo Gemini Embedding2 se baseia na arquitetura Gemini, mas expande significativamente seu escopo. Agora, ele processa cinco modalidades diferentes — texto, imagens, vídeo, áudio e PDFs — e as projeta em um único espaço vetorial. Isso permite comparações semânticas diretas entre diferentes tipos de mídia sem a necessidade de múltiplos modelos especializados ou etapas extras de processamento. Essa capacidade é particularmente valiosa para aplicações como pesquisa semântica, geração aumentada por recuperação (RAG), análise de sentimentos e agrupamento de dados.
Em relação aos recursos de entrada, o novo modelo suporta até 8.192 tokens de texto, o quádruplo do limite anterior de 2.048 tokens. Ele pode processar até seis imagens PNG ou JPEG por solicitação, vídeos de até 120 segundos de duração e documentos PDF de até seis páginas. Uma característica notável é o suporte nativo do Gemini Embedding2 para processamento de áudio, eliminando a necessidade de conversão de fala para texto e evitando a perda potencial de informações na transcrição. O Google também introduziu a tecnologia de “entrada intercalada”, permitindo que os desenvolvedores combinem múltiplas modalidades em uma única solicitação — como misturar imagens com texto descritivo — para capturar melhor as relações semânticas entre elas.
Em termos de arquitetura, o modelo continua empregando o Matryoshka Representation Learning (MRL). Essa técnica usa uma estrutura hierárquica para ajustar dinamicamente as dimensões dos vetores. A dimensão padrão de incorporação é 3072, com configurações opcionais de 1536 e 768 disponíveis, dando aos desenvolvedores flexibilidade para equilibrar a precisão da recuperação com a eficiência de armazenamento.
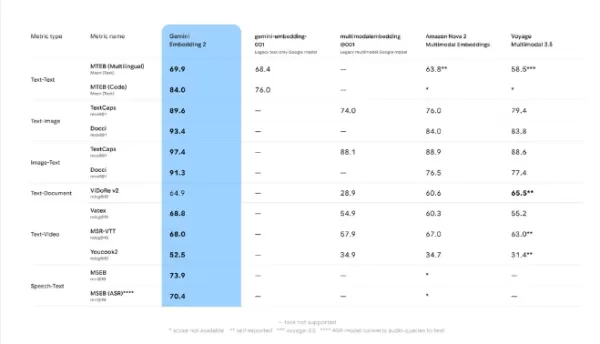
Os resultados de benchmark do Google indicam que o Gemini Embedding2 oferece desempenho líder em tarefas de texto, imagem, vídeo e fala. Por exemplo, na recuperação de texto-vídeo, ele obtém uma pontuação de 68,8, superando o Amazon Nova2Multimodal Embeddings (60,3) e o Voyage Multimodal3.5 (55,2). Na comparação de texto-imagem, ele alcança uma pontuação de 93,4, significativamente à frente da pontuação do modelo da Amazon, que é de 84,0.
O Gemini Embedding2 está atualmente disponível para desenvolvedores por meio da API Gemini e do Vertex AI. Ele se integra a frameworks populares e bancos de dados vetoriais como LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB e Vector Search. Para ajudar os desenvolvedores a começarem, o Google oferece notebooks Colab interativos e demonstrações leves de pesquisa semântica multimodal.
A competição em embedding multimodal está esquentando. Notavelmente, no final de fevereiro deste ano, o mecanismo de busca de IA Perplexity lançou seus modelos de embedding de código aberto, pplx-embed-v1 e pplx-embed-context-v1.
Artigo relacionado
 MiniMax Lança Programa de Equipes 10x para Incentivar Especialistas Globais em IA
A MiniMax (Xiyu Technology), o Laboratório de Inteligência Artificial Geral, lançou oficialmente o "Equipe 10x", uma iniciativa global de colaboração de talentos. Este programa visa recrutar os melhores especialistas de diversos setores para explorar
A Coreia do Sul inicia a construção do Centro Nacional de Computação em IA, investindo 2,5 trilhões de won com meta para 2028
O outlet sul-coreano EtNews relata que a cerimônia de lançamento da pedra fundamental do Centro de Computação em IA da Coreia (KOACC) ocorreu em 3 de agosto no parque de data centers Solar City, em Sunan, Jeollanam-do. Com um investimento total de 2,
Seis Gigantes da Tecnologia Apoiam a Linux Foundation com US$ 12,5 Milhões para Enfrentar o Ruído das Vulnerabilidades de IA
Para enfrentar o fluxo de relatórios de segurança de baixa qualidade produzidos por ferramentas de automação de IA, seis grandes empresas de tecnologia — Anthropic, Amazon (AWS), GitHub, Google, Microsoft e OpenAI — contribuíram coletivamente com US$
Recomendações de tópicos especiais relacionados
Composição musical
 Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
 9 ferramentas
 xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai
Educação e Aprendizagem
Plataformas de Construção de Questionários de IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes
2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai
código
Ferramentas de revisão de pull requests com IA para equipes do GitHub que lidam com refatorações, bugs e falhas de segurança
As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai

 Comentários (0)
O Google revelou recentemente seu novo modelo de incorporação multimodal nativo, o Gemini Embedding2. Ele é capaz de mapear textos, imagens, vídeos, áudio e documentos PDF para um espaço vetorial semântico compartilhado, projetado para otimizar fluxos de trabalho complexos de dados de IA e melhorar a recuperação e a compreensão multimodal. Isso representa um avanço fundamental para o Google na tecnologia de incorporação, marcando a transição da modelagem semântica de texto (modalidade única) para a modelagem semântica multimodal unificada.
Anteriormente, em julho de 2025, o Google apresentou o modelo de incorporação de texto gemini-embedding-001. Ele suportava mais de 100 idiomas e alcançou os melhores resultados no benchmark multilíngue MTEB. O novo Gemini Embedding2 se baseia na arquitetura Gemini, mas expande significativamente seu escopo. Agora, ele processa cinco modalidades diferentes — texto, imagens, vídeo, áudio e PDFs — e as projeta em um único espaço vetorial. Isso permite comparações semânticas diretas entre diferentes tipos de mídia sem a necessidade de múltiplos modelos especializados ou etapas extras de processamento. Essa capacidade é particularmente valiosa para aplicações como pesquisa semântica, geração aumentada por recuperação (RAG), análise de sentimentos e agrupamento de dados.
Em relação aos recursos de entrada, o novo modelo suporta até 8.192 tokens de texto, o quádruplo do limite anterior de 2.048 tokens. Ele pode processar até seis imagens PNG ou JPEG por solicitação, vídeos de até 120 segundos de duração e documentos PDF de até seis páginas. Uma característica notável é o suporte nativo do Gemini Embedding2 para processamento de áudio, eliminando a necessidade de conversão de fala para texto e evitando a perda potencial de informações na transcrição. O Google também introduziu a tecnologia de “entrada intercalada”, permitindo que os desenvolvedores combinem múltiplas modalidades em uma única solicitação — como misturar imagens com texto descritivo — para capturar melhor as relações semânticas entre elas.
Em termos de arquitetura, o modelo continua empregando o Matryoshka Representation Learning (MRL). Essa técnica usa uma estrutura hierárquica para ajustar dinamicamente as dimensões dos vetores. A dimensão padrão de incorporação é 3072, com configurações opcionais de 1536 e 768 disponíveis, dando aos desenvolvedores flexibilidade para equilibrar a precisão da recuperação com a eficiência de armazenamento.
Os resultados de benchmark do Google indicam que o Gemini Embedding2 oferece desempenho líder em tarefas de texto, imagem, vídeo e fala. Por exemplo, na recuperação de texto-vídeo, ele obtém uma pontuação de 68,8, superando o Amazon Nova2Multimodal Embeddings (60,3) e o Voyage Multimodal3.5 (55,2). Na comparação de texto-imagem, ele alcança uma pontuação de 93,4, significativamente à frente da pontuação do modelo da Amazon, que é de 84,0.
O Gemini Embedding2 está atualmente disponível para desenvolvedores por meio da API Gemini e do Vertex AI. Ele se integra a frameworks populares e bancos de dados vetoriais como LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB e Vector Search. Para ajudar os desenvolvedores a começarem, o Google oferece notebooks Colab interativos e demonstrações leves de pesquisa semântica multimodal.
A competição em embedding multimodal está esquentando. Notavelmente, no final de fevereiro deste ano, o mecanismo de busca de IA Perplexity lançou seus modelos de embedding de código aberto, pplx-embed-v1 e pplx-embed-context-v1.








 MiniMax Lança Programa de Equipes 10x para Incentivar Especialistas Globais em IA
A MiniMax (Xiyu Technology), o Laboratório de Inteligência Artificial Geral, lançou oficialmente o "Equipe 10x", uma iniciativa global de colaboração de talentos. Este programa visa recrutar os melhores especialistas de diversos setores para explorar
 A Coreia do Sul inicia a construção do Centro Nacional de Computação em IA, investindo 2,5 trilhões de won com meta para 2028
O outlet sul-coreano EtNews relata que a cerimônia de lançamento da pedra fundamental do Centro de Computação em IA da Coreia (KOACC) ocorreu em 3 de agosto no parque de data centers Solar City, em Sunan, Jeollanam-do. Com um investimento total de 2,
 Seis Gigantes da Tecnologia Apoiam a Linux Foundation com US$ 12,5 Milhões para Enfrentar o Ruído das Vulnerabilidades de IA
Para enfrentar o fluxo de relatórios de segurança de baixa qualidade produzidos por ferramentas de automação de IA, seis grandes empresas de tecnologia — Anthropic, Amazon (AWS), GitHub, Google, Microsoft e OpenAI — contribuíram coletivamente com US$

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai












