


 Hogar
Google presenta Gemini Embedding2: un modelo multimodal nativo que unifica los espacios semánticos
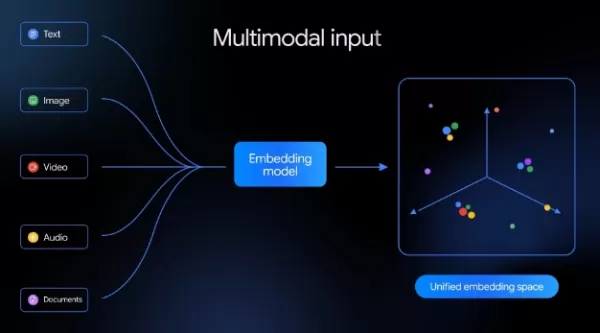
Google ha presentado recientemente su nuevo modelo de incrustación multimodal nativo, Gemini Embedding2. Este modelo permite mapear texto, imágenes, vídeos, audio y documentos PDF en un espacio vectorial semántico compartido, diseñado para optimizar los complejos flujos de trabajo de datos de IA y mejorar la recuperación y la comprensión multimodal. Esto supone un avance clave para Google en la tecnología de incrustación, al pasar de la incrustación de texto de una sola modalidad a un modelado semántico multimodal unificado.
Anteriormente, en julio de 2025, Google presentó el modelo de incrustación de texto gemini-embedding-001. Este modelo era compatible con más de 100 idiomas y obtuvo los mejores resultados en el banco de pruebas multilingüe MTEB. El nuevo Gemini Embedding2 se basa en la arquitectura Gemini, pero amplía significativamente su alcance. Ahora procesa cinco modalidades diferentes —texto, imágenes, vídeo, audio y PDF— y las proyecta en un único espacio vectorial. Esto permite realizar comparaciones semánticas directas entre diferentes tipos de medios sin necesidad de múltiples modelos especializados ni pasos de procesamiento adicionales. Esta capacidad resulta especialmente valiosa para aplicaciones como la búsqueda semántica, la generación aumentada por recuperación (RAG), el análisis de sentimientos y la agrupación de datos.
En cuanto a las capacidades de entrada, el nuevo modelo admite hasta 8192 tokens de texto, el cuádruple del límite anterior de 2048 tokens. Puede gestionar hasta seis imágenes PNG o JPEG por solicitud, vídeos de hasta 120 segundos de duración y documentos PDF de hasta seis páginas. Una característica destacable es la compatibilidad nativa de Gemini Embedding2 con el procesamiento de audio, lo que elimina la necesidad de conversión de voz a texto y evita la posible pérdida de información derivada de la transcripción. Google también ha introducido la tecnología de «entrada intercalada», que permite a los desarrolladores combinar múltiples modalidades en una sola solicitud —como mezclar imágenes con texto descriptivo— para captar mejor las relaciones semánticas entre ellas.
Desde el punto de vista arquitectónico, el modelo sigue empleando el Matryoshka Representation Learning (MRL). Esta técnica utiliza una estructura jerárquica para ajustar dinámicamente las dimensiones de los vectores. La dimensión de incrustación predeterminada es 3072, con configuraciones opcionales de 1536 y 768 disponibles, lo que ofrece a los desarrolladores flexibilidad para equilibrar la precisión de la recuperación con la eficiencia del almacenamiento.
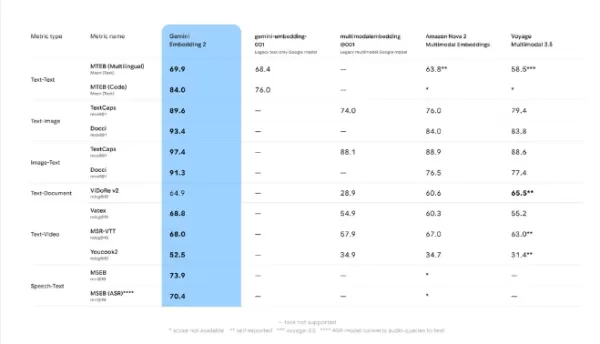
Los resultados de las pruebas comparativas de Google indican que Gemini Embedding2 ofrece un rendimiento líder en tareas de texto, imagen, vídeo y voz. Por ejemplo, en la recuperación de texto y vídeo, obtiene una puntuación de 68,8, superando a Amazon Nova2Multimodal Embeddings (60,3) y a Voyage Multimodal3.5 (55,2). En la comparación de texto e imagen, alcanza una puntuación de 93,4, muy por delante de la puntuación del modelo de Amazon, que es de 84,0.
Actualmente, los desarrolladores pueden acceder a Gemini Embedding2 a través de la API de Gemini y Vertex AI. Se integra con marcos de trabajo y bases de datos vectoriales populares como LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB y Vector Search. Para ayudar a los desarrolladores a dar sus primeros pasos, Google ofrece cuadernos Colab interactivos y demostraciones de búsqueda semántica multimodal ligeras.
La competencia en el ámbito de la incrustación multimodal se está recrudeciendo. Cabe destacar que, a finales de febrero de este año, el motor de búsqueda de IA Perplexity lanzó sus modelos de incrustación de código abierto, pplx-embed-v1 y pplx-embed-context-v1.
Artículo relacionado
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Slackbot se convierte en un agente de IA
Slackbot, el asistente automatizado integrado en la plataforma de mensajería corporativa Slack de Salesforce, está evolucionando hacia un agente de inteligencia artificial. El CTO de Salesforce, Parker Harris, prevé que alcance un estatus viral compa
ByteDance Refuerza los Incentivos de IA Central mientras Doubao Aumenta un 14.6%
ByteDance ha convocado recientemente una sesión informativa sobre la participación accionaria de DouBao para presentar nuevas políticas de incentivos para el personal involucrado en la división de DouBao. El precio de ejercicio de las acciones de Dou
Recomendaciones de temas especiales relacionados
Educación y aprendizaje
 Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
 10 herramientas
 xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai
Educación y aprendizaje
Plataformas de construcción de cuestionarios con IA para profesores, tutores y programas de aprendizaje basados en cohortes
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai

 comentario (0)
0/500
Google ha presentado recientemente su nuevo modelo de incrustación multimodal nativo, Gemini Embedding2. Este modelo permite mapear texto, imágenes, vídeos, audio y documentos PDF en un espacio vectorial semántico compartido, diseñado para optimizar los complejos flujos de trabajo de datos de IA y mejorar la recuperación y la comprensión multimodal. Esto supone un avance clave para Google en la tecnología de incrustación, al pasar de la incrustación de texto de una sola modalidad a un modelado semántico multimodal unificado.
Anteriormente, en julio de 2025, Google presentó el modelo de incrustación de texto gemini-embedding-001. Este modelo era compatible con más de 100 idiomas y obtuvo los mejores resultados en el banco de pruebas multilingüe MTEB. El nuevo Gemini Embedding2 se basa en la arquitectura Gemini, pero amplía significativamente su alcance. Ahora procesa cinco modalidades diferentes —texto, imágenes, vídeo, audio y PDF— y las proyecta en un único espacio vectorial. Esto permite realizar comparaciones semánticas directas entre diferentes tipos de medios sin necesidad de múltiples modelos especializados ni pasos de procesamiento adicionales. Esta capacidad resulta especialmente valiosa para aplicaciones como la búsqueda semántica, la generación aumentada por recuperación (RAG), el análisis de sentimientos y la agrupación de datos.
En cuanto a las capacidades de entrada, el nuevo modelo admite hasta 8192 tokens de texto, el cuádruple del límite anterior de 2048 tokens. Puede gestionar hasta seis imágenes PNG o JPEG por solicitud, vídeos de hasta 120 segundos de duración y documentos PDF de hasta seis páginas. Una característica destacable es la compatibilidad nativa de Gemini Embedding2 con el procesamiento de audio, lo que elimina la necesidad de conversión de voz a texto y evita la posible pérdida de información derivada de la transcripción. Google también ha introducido la tecnología de «entrada intercalada», que permite a los desarrolladores combinar múltiples modalidades en una sola solicitud —como mezclar imágenes con texto descriptivo— para captar mejor las relaciones semánticas entre ellas.
Desde el punto de vista arquitectónico, el modelo sigue empleando el Matryoshka Representation Learning (MRL). Esta técnica utiliza una estructura jerárquica para ajustar dinámicamente las dimensiones de los vectores. La dimensión de incrustación predeterminada es 3072, con configuraciones opcionales de 1536 y 768 disponibles, lo que ofrece a los desarrolladores flexibilidad para equilibrar la precisión de la recuperación con la eficiencia del almacenamiento.
Los resultados de las pruebas comparativas de Google indican que Gemini Embedding2 ofrece un rendimiento líder en tareas de texto, imagen, vídeo y voz. Por ejemplo, en la recuperación de texto y vídeo, obtiene una puntuación de 68,8, superando a Amazon Nova2Multimodal Embeddings (60,3) y a Voyage Multimodal3.5 (55,2). En la comparación de texto e imagen, alcanza una puntuación de 93,4, muy por delante de la puntuación del modelo de Amazon, que es de 84,0.
Actualmente, los desarrolladores pueden acceder a Gemini Embedding2 a través de la API de Gemini y Vertex AI. Se integra con marcos de trabajo y bases de datos vectoriales populares como LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB y Vector Search. Para ayudar a los desarrolladores a dar sus primeros pasos, Google ofrece cuadernos Colab interactivos y demostraciones de búsqueda semántica multimodal ligeras.
La competencia en el ámbito de la incrustación multimodal se está recrudeciendo. Cabe destacar que, a finales de febrero de este año, el motor de búsqueda de IA Perplexity lanzó sus modelos de incrustación de código abierto, pplx-embed-v1 y pplx-embed-context-v1.








 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
 Slackbot se convierte en un agente de IA
Slackbot, el asistente automatizado integrado en la plataforma de mensajería corporativa Slack de Salesforce, está evolucionando hacia un agente de inteligencia artificial. El CTO de Salesforce, Parker Harris, prevé que alcance un estatus viral compa
 ByteDance Refuerza los Incentivos de IA Central mientras Doubao Aumenta un 14.6%
ByteDance ha convocado recientemente una sesión informativa sobre la participación accionaria de DouBao para presentar nuevas políticas de incentivos para el personal involucrado en la división de DouBao. El precio de ejercicio de las acciones de Dou

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai












