


 Heim
Google stellt „Gemini Embedding2“ vor: Ein natives multimodales Modell vereint semantische Räume
Google hat kürzlich sein neues natives multimodales Einbettungsmodell „Gemini Embedding2“ vorgestellt. Es kann Texte, Bilder, Videos, Audiodateien und PDF-Dokumente in einen gemeinsamen semantischen Vektorraum abbilden und wurde entwickelt, um komplexe KI-Daten-Workflows zu optimieren sowie die multimodale Suche und das Verständnis zu verbessern. Dies stellt für Google einen entscheidenden Fortschritt in der Einbettungstechnologie dar und markiert den Übergang von der einmodalen Textverarbeitung hin zu einer einheitlichen multimodalen semantischen Modellierung.
Zuvor hatte Google im Juli 2025 das Text-Einbettungsmodell „gemini-embedding-001“ vorgestellt. Es unterstützte über 100 Sprachen und erzielte Spitzenergebnisse beim mehrsprachigen Benchmark MTEB. Das neue Gemini Embedding2 baut auf der Gemini-Architektur auf, erweitert deren Anwendungsbereich jedoch erheblich. Es verarbeitet nun fünf verschiedene Modalitäten – Text, Bilder, Video, Audio und PDFs – und projiziert diese in einen einzigen Vektorraum. Dies ermöglicht direkte semantische Vergleiche zwischen verschiedenen Medientypen, ohne dass mehrere spezialisierte Modelle oder zusätzliche Verarbeitungsschritte erforderlich sind. Diese Fähigkeit ist besonders wertvoll für Anwendungen wie die semantische Suche, Retrieval-Augmented Generation (RAG), Sentimentanalyse und Datenclustering.
Was die Eingabekapazitäten betrifft, unterstützt das neue Modell bis zu 8192 Text-Tokens, was einer Vervierfachung des bisherigen Limits von 2048 Tokens entspricht. Es kann bis zu sechs PNG- oder JPEG-Bilder pro Anfrage, Videos mit einer Länge von bis zu 120 Sekunden und PDF-Dokumente mit bis zu sechs Seiten verarbeiten. Ein bemerkenswertes Merkmal ist die native Unterstützung von Gemini Embedding2 für die Audioverarbeitung, wodurch die Umwandlung von Sprache in Text entfällt und ein potenzieller Informationsverlust durch die Transkription vermieden wird. Google führte außerdem die „Interleaved Input“-Technologie ein, die es Entwicklern ermöglicht, mehrere Modalitäten in einer Anfrage zu kombinieren – beispielsweise Bilder mit beschreibendem Text zu mischen –, um die semantischen Beziehungen zwischen ihnen besser zu erfassen.
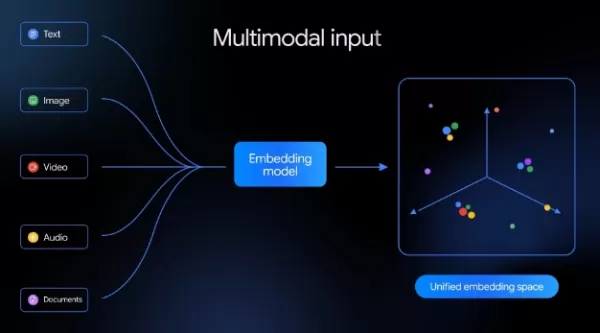
Architektonisch setzt das Modell weiterhin auf Matryoshka Representation Learning (MRL). Diese Technik nutzt eine hierarchische Struktur, um Vektordimensionen dynamisch anzupassen. Die Standard-Einbettungsdimension beträgt 3072, wobei optionale Konfigurationen von 1536 und 768 verfügbar sind, was Entwicklern Flexibilität bietet, um die Genauigkeit der Abfrage mit der Speichereffizienz in Einklang zu bringen.
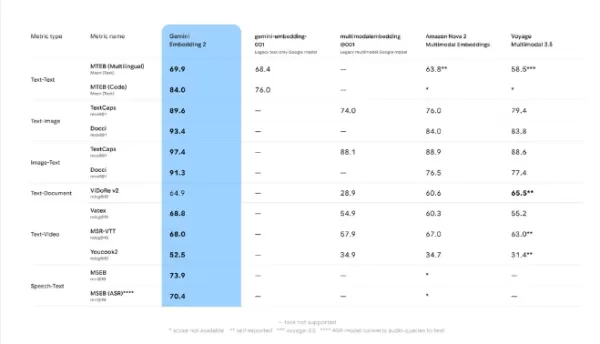
Die Benchmark-Ergebnisse von Google zeigen, dass Gemini Embedding2 bei Text-, Bild-, Video- und Sprachaufgaben eine führende Leistung erbringt. Bei der Text-Video-Suche erreicht es beispielsweise 68,8 Punkte und übertrifft damit Amazon Nova2Multimodal Embeddings (60,3) und Voyage Multimodal3.5 (55,2). Beim Text-Bild-Vergleich erreicht es einen Wert von 93,4 und liegt damit deutlich vor dem Wert von 84,0 des Amazon-Modells.
Gemini Embedding2 steht Entwicklern derzeit über die Gemini-API und Vertex AI zur Verfügung. Es lässt sich in beliebte Frameworks und Vektordatenbanken wie LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB und Vector Search integrieren. Um Entwicklern den Einstieg zu erleichtern, stellt Google interaktive Colab-Notebooks und leichtgewichtige Demonstrationen der multimodalen semantischen Suche bereit.
Der Wettbewerb im Bereich der multimodalen Einbettung spitzt sich zu. Insbesondere veröffentlichte die KI-Suchmaschine Perplexity Ende Februar dieses Jahres ihre Open-Source-Einbettungsmodelle pplx-embed-v1 und pplx-embed-context-v1.
Verwandter Artikel
 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
Google hat kürzlich sein neues natives multimodales Einbettungsmodell „Gemini Embedding2“ vorgestellt. Es kann Texte, Bilder, Videos, Audiodateien und PDF-Dokumente in einen gemeinsamen semantischen Vektorraum abbilden und wurde entwickelt, um komplexe KI-Daten-Workflows zu optimieren sowie die multimodale Suche und das Verständnis zu verbessern. Dies stellt für Google einen entscheidenden Fortschritt in der Einbettungstechnologie dar und markiert den Übergang von der einmodalen Textverarbeitung hin zu einer einheitlichen multimodalen semantischen Modellierung.
Zuvor hatte Google im Juli 2025 das Text-Einbettungsmodell „gemini-embedding-001“ vorgestellt. Es unterstützte über 100 Sprachen und erzielte Spitzenergebnisse beim mehrsprachigen Benchmark MTEB. Das neue Gemini Embedding2 baut auf der Gemini-Architektur auf, erweitert deren Anwendungsbereich jedoch erheblich. Es verarbeitet nun fünf verschiedene Modalitäten – Text, Bilder, Video, Audio und PDFs – und projiziert diese in einen einzigen Vektorraum. Dies ermöglicht direkte semantische Vergleiche zwischen verschiedenen Medientypen, ohne dass mehrere spezialisierte Modelle oder zusätzliche Verarbeitungsschritte erforderlich sind. Diese Fähigkeit ist besonders wertvoll für Anwendungen wie die semantische Suche, Retrieval-Augmented Generation (RAG), Sentimentanalyse und Datenclustering.
Was die Eingabekapazitäten betrifft, unterstützt das neue Modell bis zu 8192 Text-Tokens, was einer Vervierfachung des bisherigen Limits von 2048 Tokens entspricht. Es kann bis zu sechs PNG- oder JPEG-Bilder pro Anfrage, Videos mit einer Länge von bis zu 120 Sekunden und PDF-Dokumente mit bis zu sechs Seiten verarbeiten. Ein bemerkenswertes Merkmal ist die native Unterstützung von Gemini Embedding2 für die Audioverarbeitung, wodurch die Umwandlung von Sprache in Text entfällt und ein potenzieller Informationsverlust durch die Transkription vermieden wird. Google führte außerdem die „Interleaved Input“-Technologie ein, die es Entwicklern ermöglicht, mehrere Modalitäten in einer Anfrage zu kombinieren – beispielsweise Bilder mit beschreibendem Text zu mischen –, um die semantischen Beziehungen zwischen ihnen besser zu erfassen.
Architektonisch setzt das Modell weiterhin auf Matryoshka Representation Learning (MRL). Diese Technik nutzt eine hierarchische Struktur, um Vektordimensionen dynamisch anzupassen. Die Standard-Einbettungsdimension beträgt 3072, wobei optionale Konfigurationen von 1536 und 768 verfügbar sind, was Entwicklern Flexibilität bietet, um die Genauigkeit der Abfrage mit der Speichereffizienz in Einklang zu bringen.
Die Benchmark-Ergebnisse von Google zeigen, dass Gemini Embedding2 bei Text-, Bild-, Video- und Sprachaufgaben eine führende Leistung erbringt. Bei der Text-Video-Suche erreicht es beispielsweise 68,8 Punkte und übertrifft damit Amazon Nova2Multimodal Embeddings (60,3) und Voyage Multimodal3.5 (55,2). Beim Text-Bild-Vergleich erreicht es einen Wert von 93,4 und liegt damit deutlich vor dem Wert von 84,0 des Amazon-Modells.
Gemini Embedding2 steht Entwicklern derzeit über die Gemini-API und Vertex AI zur Verfügung. Es lässt sich in beliebte Frameworks und Vektordatenbanken wie LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB und Vector Search integrieren. Um Entwicklern den Einstieg zu erleichtern, stellt Google interaktive Colab-Notebooks und leichtgewichtige Demonstrationen der multimodalen semantischen Suche bereit.
Der Wettbewerb im Bereich der multimodalen Einbettung spitzt sich zu. Insbesondere veröffentlichte die KI-Suchmaschine Perplexity Ende Februar dieses Jahres ihre Open-Source-Einbettungsmodelle pplx-embed-v1 und pplx-embed-context-v1.








 Slackbot wird zu einem KI-Agenten
Slackbot, der automatisierte Assistent, der in Salesforce’s Unternehmens-Messaging-Plattform Slack integriert ist, entwickelt sich zu einem KI-Agenten. Salesforce-CTO Parker Harris sieht das Potenzial für eine virale Verbreitung, die mit OpenAIs Chat
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












