


 Lar
Claude Mythos é lançado a US$ 125 por 1 milhão de tokens; o método “Homem das Cavernas da Montanha Frugal” ganha popularidade
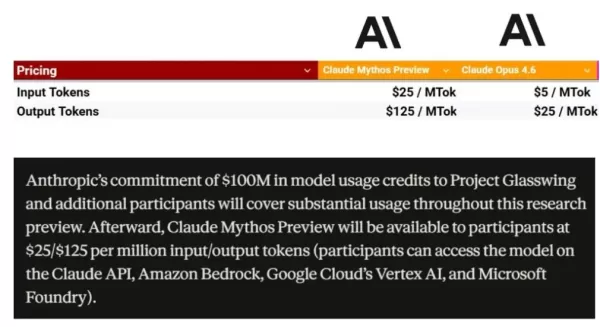
Recentemente, a Anthropic lançou o modelo de IA Claude Mythos, descrito como seu lançamento mais poderoso até o momento. No entanto, o preço causou grande comoção na comunidade de desenvolvedores: os custos de geração de resultados foram fixados em US$ 125 por milhão de tokens, quase oito vezes mais do que os do atual modelo principal, o Claude Sonnet 4.6.
Foco principal: o Mythos, de custo proibitivo
A estrutura de preços do Claude Mythos sinaliza uma nova era de sobretaxas pelo poder de computação da IA:
Custos exorbitantes: a entrada e a saída custam US$ 25 e US$ 125 por milhão de tokens, respectivamente. Em comparação, o Claude Sonnet 4.6 custa apenas US$ 3 e US$ 15.
Alta barreira de entrada: devido ao seu poder extremo e ao alto custo, o modelo ainda não está acessível a usuários comuns. Alguns usuários do Reddit brincaram dizendo que até mesmo um simples “Olá” poderia consumir 13% da cota mensal de tokens.
Auto-resgate geek: o método viral de economia “Caveman”
Com os custos dos tokens rivalizando com o ouro, os desenvolvedores recorreram a táticas extremas de economia. Um projeto, apropriadamente chamado de Caveman, rapidamente se tornou viral no GitHub:
Lógica central: ele força a IA a cortar todas as formalidades (como “É um prazer atendê-lo”), eliminar artigos, evitar conversas triviais vagas e gerar apenas termos técnicos essenciais.
Resultados impressionantes: Testes indicam que esse modo de “linguagem do homem das cavernas” pode economizar cerca de 65% dos tokens sem sacrificar a precisão da resposta.
Base científica: Estudos mostram que forçar o modelo a produzir respostas concisas não apenas reduz custos, mas também elimina os efeitos negativos do excesso de reflexão, aumentando a precisão em alguns benchmarks em 26%.
Dicas práticas: 10 truques para economizar tokens
Além de soluções técnicas, os usuários comuns podem contornar o “assassino de tokens” ajustando seus hábitos de interação:
Edite no local: se um resultado não for satisfatório, use o botão “Editar” para refinar o prompt original, evitando cobranças repetidas decorrentes de conversas longas.
Encerre as conversas: inicie um novo chat a cada 15–20 mensagens para evitar que o acúmulo de contexto se transforme em um buraco negro de tokens.
Combine perguntas: agrupe várias instruções em uma única mensagem para reduzir a carga no sistema.
Use o Espaço de Projetos com sabedoria: envie documentos longos para os Projetos e aproveite o cache para que o documento não seja digitalizado repetidamente.
Opte por modelos mais econômicos quando possível: delegue tarefas simples, como verificações gramaticais, a modelos mais baratos, como o Haiku, reservando o Claude Mythos , que é mais caro, para tarefas mais complexas.
Aproveite os horários fora do pico: evite o horário de pico, das 5h às 11h, horário do Pacífico, para se beneficiar de custos mais baixos.
Conclusão: Do desperdício à precisão
Das mensagens curtas do ano 2000, cobradas por palavra, aos grandes modelos atuais, cobrados por token, nossa busca pela eficiência na comunicação completou um ciclo. Esta é a era da IA de alto custo inaugurada pelo Claude Mythos .
Artigo relacionado
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (0)
Recentemente,
Foco principal: o Mythos, de custo proibitivo
A estrutura de preços do
Custos exorbitantes: a entrada e a saída custam US$ 25 e US$ 125 por milhão de tokens, respectivamente. Em comparação,
Alta barreira de entrada: devido ao seu poder extremo e ao alto custo, o modelo ainda não está acessível a usuários comuns. Alguns usuários do Reddit brincaram dizendo que até mesmo um simples “Olá” poderia consumir 13% da cota mensal de tokens.
Auto-resgate geek: o método viral de economia “Caveman”
Com os custos dos tokens rivalizando com o ouro, os desenvolvedores recorreram a táticas extremas de economia. Um projeto, apropriadamente chamado de Caveman, rapidamente se tornou viral no GitHub:
Lógica central: ele força a IA a cortar todas as formalidades (como “É um prazer atendê-lo”), eliminar artigos, evitar conversas triviais vagas e gerar apenas termos técnicos essenciais.
Resultados impressionantes: Testes indicam que esse modo de “linguagem do homem das cavernas” pode economizar cerca de 65% dos tokens sem sacrificar a precisão da resposta.
Base científica: Estudos mostram que forçar o modelo a produzir respostas concisas não apenas reduz custos, mas também elimina os efeitos negativos do excesso de reflexão, aumentando a precisão em alguns benchmarks em 26%.
Dicas práticas: 10 truques para economizar tokens
Além de soluções técnicas, os usuários comuns podem contornar o “assassino de tokens” ajustando seus hábitos de interação:
Edite no local: se um resultado não for satisfatório, use o botão “Editar” para refinar o prompt original, evitando cobranças repetidas decorrentes de conversas longas.
Encerre as conversas: inicie um novo chat a cada 15–20 mensagens para evitar que o acúmulo de contexto se transforme em um buraco negro de tokens.
Combine perguntas: agrupe várias instruções em uma única mensagem para reduzir a carga no sistema.
Use o Espaço de Projetos com sabedoria: envie documentos longos para os Projetos e aproveite o cache para que o documento não seja digitalizado repetidamente.
Opte por modelos mais econômicos quando possível: delegue tarefas simples, como verificações gramaticais, a modelos mais baratos, como o Haiku, reservando o
Aproveite os horários fora do pico: evite o horário de pico, das 5h às 11h, horário do Pacífico, para se beneficiar de custos mais baixos.
Conclusão: Do desperdício à precisão
Das mensagens curtas do ano 2000, cobradas por palavra, aos grandes modelos atuais, cobrados por token, nossa busca pela eficiência na comunicação completou um ciclo. Esta é a era da IA de alto custo inaugurada pelo








 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai












