


 Lar
A ByteDance lança o Seed Audio 1.0, revolucionando a criação de áudio com uma nova ferramenta de conversão de fala em conteúdo
Recentemente, a ByteDance lançou o Seed Audio 1.0, seu novo modelo de criação de áudio, marcando um avanço significativo na geração de áudio por IA. Essa atualização leva a tecnologia além da síntese de fala básica, permitindo a criação de cenas sonoras totalmente integradas. O modelo está atualmente disponível para os criadores testarem no Volcano Fangzhou Experience Center.
Tradicionalmente, a produção de conteúdo de áudio com qualidade comparável à usada em filmes e na televisão exigia vários modelos separados para gerar vozes, efeitos sonoros e ruídos ambientais, que eram então combinados manualmente. Essa abordagem era demorada e tornava difícil manter uma narrativa consistente ao longo do áudio. O Seed Audio 1.0 resolve essa questão ao integrar todos os elementos de áudio em uma única estrutura, em vez de simplesmente combinar materiais pré-criados, permitindo a produção de obras sonoras completas que dão suporte à narrativa de ponta a ponta.
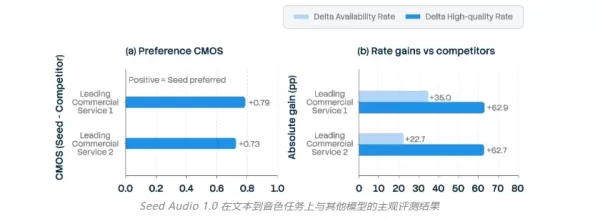
De acordo com as informações oficiais, o Seed Audio 1.0 apresenta três recursos principais. Primeiro, oferece controle temporal-espacial preciso, permitindo que os criadores definam o tempo exato para diálogos e efeitos sonoros com precisão de até 100 milissegundos, o que é ideal para dublagem de vídeos e produção de publicidade. Em segundo lugar, proporciona um desempenho vocal estável, com suporte à geração “zero-shot” e saída de áudio prolongada, preservando as características vocais do personagem. Também é capaz de transmitir naturalmente uma variedade de emoções, como raiva ou alegria, e até mesmo permitir que uma única voz represente vários personagens. Em terceiro lugar, oferece suporte multilíngue robusto para mais de 20 idiomas, incluindo chinês, inglês e japonês, garantindo que a voz soe natural e se adapte aos padrões linguísticos locais de cada idioma.
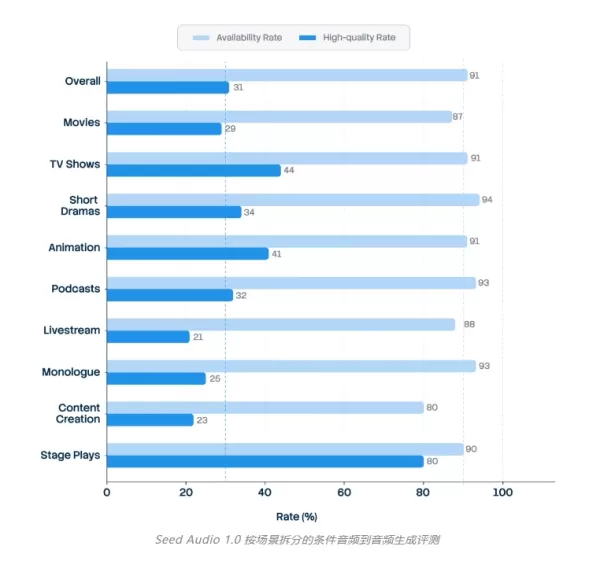
Os resultados da avaliação mostram que o modelo tem bom desempenho em nove cenários criativos comuns, com disponibilidade de áudio superior a 90%. Além disso, sua pontuação MOS de naturalidade para geração multilíngue geralmente fica acima de 4 pontos, o que é considerado uma classificação excelente.
Ao evoluir de uma ferramenta capaz apenas de gerar fala para uma que pode criar conteúdo de áudio completo, o Seed Audio 1.0 reduz as barreiras à produção de material de áudio de alta qualidade. A equipe de desenvolvimento planeja aprimorar ainda mais o modelo, incorporando entradas multimodais, como referências de vídeo, e explorando recursos de tradução controláveis. Eles também pretendem continuar aprimorando os recursos de geração de áudio longo e de faixas, ajudando os criadores a transformar suas ideias conceituais de som em obras de áudio totalmente funcionais de maneira mais eficiente.
Página inicial do projeto:
https://seed.bytedance.com/seedaudio1_0
Acesso à experiência:
Centro de Experiências Volcano Fangzhou - Login - Selecionar modelo de voz - Síntese de voz - Doubao - Geração de áudio - 1.0
Artigo relacionado
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (0)
Recentemente, a ByteDance lançou o Seed Audio 1.0, seu novo modelo de criação de áudio, marcando um avanço significativo na geração de áudio por IA. Essa atualização leva a tecnologia além da síntese de fala básica, permitindo a criação de cenas sonoras totalmente integradas. O modelo está atualmente disponível para os criadores testarem no Volcano Fangzhou Experience Center.
Tradicionalmente, a produção de conteúdo de áudio com qualidade comparável à usada em filmes e na televisão exigia vários modelos separados para gerar vozes, efeitos sonoros e ruídos ambientais, que eram então combinados manualmente. Essa abordagem era demorada e tornava difícil manter uma narrativa consistente ao longo do áudio. O Seed Audio 1.0 resolve essa questão ao integrar todos os elementos de áudio em uma única estrutura, em vez de simplesmente combinar materiais pré-criados, permitindo a produção de obras sonoras completas que dão suporte à narrativa de ponta a ponta.
De acordo com as informações oficiais, o Seed Audio 1.0 apresenta três recursos principais. Primeiro, oferece controle temporal-espacial preciso, permitindo que os criadores definam o tempo exato para diálogos e efeitos sonoros com precisão de até 100 milissegundos, o que é ideal para dublagem de vídeos e produção de publicidade. Em segundo lugar, proporciona um desempenho vocal estável, com suporte à geração “zero-shot” e saída de áudio prolongada, preservando as características vocais do personagem. Também é capaz de transmitir naturalmente uma variedade de emoções, como raiva ou alegria, e até mesmo permitir que uma única voz represente vários personagens. Em terceiro lugar, oferece suporte multilíngue robusto para mais de 20 idiomas, incluindo chinês, inglês e japonês, garantindo que a voz soe natural e se adapte aos padrões linguísticos locais de cada idioma.
Os resultados da avaliação mostram que o modelo tem bom desempenho em nove cenários criativos comuns, com disponibilidade de áudio superior a 90%. Além disso, sua pontuação MOS de naturalidade para geração multilíngue geralmente fica acima de 4 pontos, o que é considerado uma classificação excelente.
Ao evoluir de uma ferramenta capaz apenas de gerar fala para uma que pode criar conteúdo de áudio completo, o Seed Audio 1.0 reduz as barreiras à produção de material de áudio de alta qualidade. A equipe de desenvolvimento planeja aprimorar ainda mais o modelo, incorporando entradas multimodais, como referências de vídeo, e explorando recursos de tradução controláveis. Eles também pretendem continuar aprimorando os recursos de geração de áudio longo e de faixas, ajudando os criadores a transformar suas ideias conceituais de som em obras de áudio totalmente funcionais de maneira mais eficiente.
Página inicial do projeto:
https://seed.bytedance.com/seedaudio1_0
Acesso à experiência:
Centro de Experiências Volcano Fangzhou - Login - Selecionar modelo de voz - Síntese de voz - Doubao - Geração de áudio - 1.0








 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai












