


 Maison
ByteDance dévoile Seed Audio 1.0, un outil de conversion de la parole en contenu qui révolutionne la création audio
Récemment, ByteDance a présenté Seed Audio 1.0, son nouveau modèle de création audio, qui marque une avancée significative dans le domaine de la génération audio par IA. Cette mise à jour fait évoluer la technologie au-delà de la simple synthèse vocale pour permettre la création de scènes sonores entièrement intégrées. Le modèle est actuellement disponible pour que les créateurs puissent le tester au Volcano Fangzhou Experience Center.
Traditionnellement, la production de contenus audio d'une qualité comparable à celle utilisée au cinéma et à la télévision nécessitait plusieurs modèles distincts pour générer les voix, les effets sonores et les bruits d'ambiance, qui étaient ensuite combinés manuellement. Cette approche prenait beaucoup de temps et rendait difficile le maintien d'une narration cohérente tout au long de l'enregistrement. Seed Audio 1.0 résout ce problème en intégrant tous les éléments audio au sein d’un cadre unique, plutôt que de se contenter d’assembler des éléments préenregistrés, ce qui lui permet de produire des œuvres sonores complètes soutenant un récit de bout en bout.
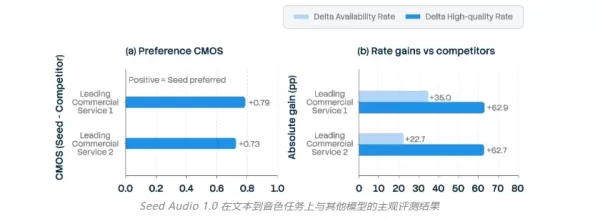
Selon les informations officielles, Seed Audio 1.0 présente trois fonctionnalités clés. Premièrement, il offre un contrôle spatio-temporel précis, permettant aux créateurs de définir le timing exact des dialogues et des effets sonores avec une précision allant jusqu’à 100 millisecondes, ce qui est idéal pour le doublage vidéo et la production publicitaire. Deuxièmement, il offre des performances vocales stables, prenant en charge la génération « zero-shot » et une sortie audio étendue tout en préservant les caractéristiques vocales du personnage. Il peut également transmettre naturellement toute une gamme d’émotions telles que la colère ou la joie, et permet même à une seule voix de représenter plusieurs personnages. Troisièmement, il offre une prise en charge multilingue robuste pour plus de 20 langues, dont le chinois, l’anglais et le japonais, garantissant ainsi que la voix sonne naturellement et s’adapte aux particularités linguistiques propres à chaque langue.
Les résultats d’évaluation montrent que le modèle offre de bonnes performances dans neuf scénarios créatifs courants, avec un taux de disponibilité audio supérieur à 90 %. De plus, son score MOS de naturel pour la génération multilingue se situe généralement au-dessus de 4 points, ce qui est considéré comme une excellente note.
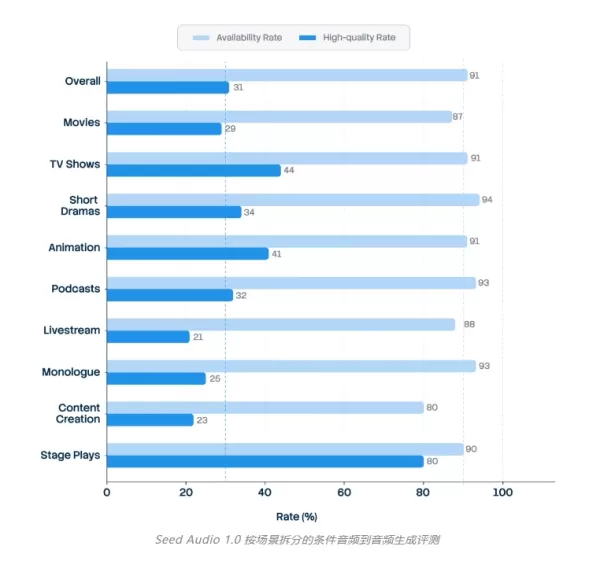
En passant d’un outil capable uniquement de générer de la parole à un outil capable de créer du contenu audio complet, Seed Audio 1.0 réduit les obstacles à la production de matériel audio de haute qualité. L’équipe de développement prévoit d’améliorer encore le modèle en y intégrant des entrées multimodales telles que des références vidéo et en explorant des fonctionnalités de traduction contrôlables. Elle vise également à continuer d’améliorer les capacités de génération de longs fichiers audio et de pistes, afin d’aider les créateurs à transformer plus efficacement leurs idées sonores conceptuelles en œuvres audio pleinement fonctionnelles.
Page d'accueil du projet :
https://seed.bytedance.com/seedaudio1_0
Accès à l’expérience :
Centre d’expérience Volcano de Fangzhou - Connexion - Sélectionner un modèle vocal - Synthèse vocale - Doubao - Génération audio - 1.0
Article connexe
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc
Recommandations de sujets spéciaux liés
en écrivant
 Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
 8 outils
 xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

 commentaires (0)
Récemment, ByteDance a présenté Seed Audio 1.0, son nouveau modèle de création audio, qui marque une avancée significative dans le domaine de la génération audio par IA. Cette mise à jour fait évoluer la technologie au-delà de la simple synthèse vocale pour permettre la création de scènes sonores entièrement intégrées. Le modèle est actuellement disponible pour que les créateurs puissent le tester au Volcano Fangzhou Experience Center.
Traditionnellement, la production de contenus audio d'une qualité comparable à celle utilisée au cinéma et à la télévision nécessitait plusieurs modèles distincts pour générer les voix, les effets sonores et les bruits d'ambiance, qui étaient ensuite combinés manuellement. Cette approche prenait beaucoup de temps et rendait difficile le maintien d'une narration cohérente tout au long de l'enregistrement. Seed Audio 1.0 résout ce problème en intégrant tous les éléments audio au sein d’un cadre unique, plutôt que de se contenter d’assembler des éléments préenregistrés, ce qui lui permet de produire des œuvres sonores complètes soutenant un récit de bout en bout.
Selon les informations officielles, Seed Audio 1.0 présente trois fonctionnalités clés. Premièrement, il offre un contrôle spatio-temporel précis, permettant aux créateurs de définir le timing exact des dialogues et des effets sonores avec une précision allant jusqu’à 100 millisecondes, ce qui est idéal pour le doublage vidéo et la production publicitaire. Deuxièmement, il offre des performances vocales stables, prenant en charge la génération « zero-shot » et une sortie audio étendue tout en préservant les caractéristiques vocales du personnage. Il peut également transmettre naturellement toute une gamme d’émotions telles que la colère ou la joie, et permet même à une seule voix de représenter plusieurs personnages. Troisièmement, il offre une prise en charge multilingue robuste pour plus de 20 langues, dont le chinois, l’anglais et le japonais, garantissant ainsi que la voix sonne naturellement et s’adapte aux particularités linguistiques propres à chaque langue.
Les résultats d’évaluation montrent que le modèle offre de bonnes performances dans neuf scénarios créatifs courants, avec un taux de disponibilité audio supérieur à 90 %. De plus, son score MOS de naturel pour la génération multilingue se situe généralement au-dessus de 4 points, ce qui est considéré comme une excellente note.
En passant d’un outil capable uniquement de générer de la parole à un outil capable de créer du contenu audio complet, Seed Audio 1.0 réduit les obstacles à la production de matériel audio de haute qualité. L’équipe de développement prévoit d’améliorer encore le modèle en y intégrant des entrées multimodales telles que des références vidéo et en explorant des fonctionnalités de traduction contrôlables. Elle vise également à continuer d’améliorer les capacités de génération de longs fichiers audio et de pistes, afin d’aider les créateurs à transformer plus efficacement leurs idées sonores conceptuelles en œuvres audio pleinement fonctionnelles.
Page d'accueil du projet :
https://seed.bytedance.com/seedaudio1_0
Accès à l’expérience :
Centre d’expérience Volcano de Fangzhou - Connexion - Sélectionner un modèle vocal - Synthèse vocale - Doubao - Génération audio - 1.0








 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
 Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai












