


 Lar
Black Tech, de Ali: modelo de 0,6 bilhão atualizado para 17 bilhões de MoE com 5% de parâmetros ativos, rodando na CPU a 30 tokens por segundo
A equipe de Comércio Digital da Ali International apresentou o Marco-Mini-Instruct, a mais recente adição à série Marco-MoE, demonstrando como “escalas menores podem gerar grandes resultados”. Com um total de 17,3 bilhões de parâmetros, apenas 0,86 bilhão estão ativos (aproximadamente 5%), permitindo uma velocidade de inferência excepcional que funciona perfeitamente até mesmo em CPUs padrão.
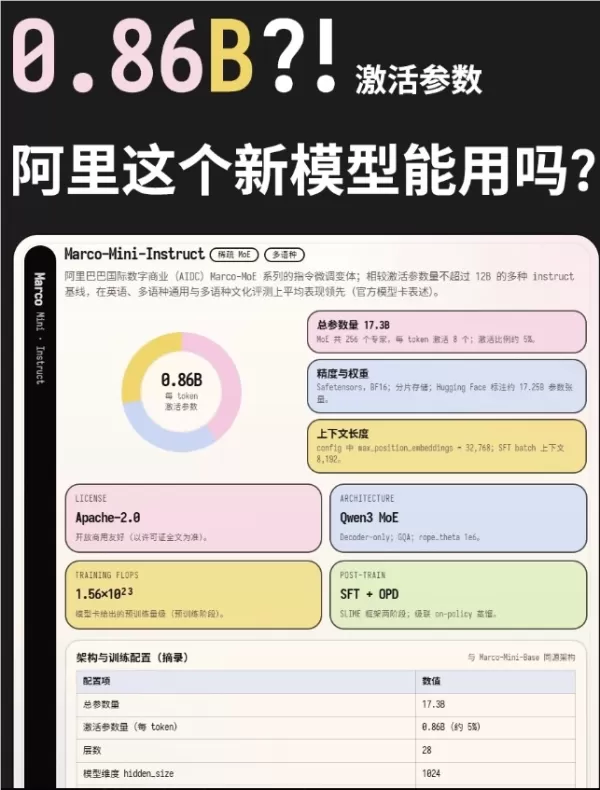
Ultraleve: otimizado para desempenho da CPU
De acordo com dados oficiais, utilizando quantização de 8 bits com quatro módulos de memória DDR4 2400, o modelo atinge uma velocidade de inferência de aproximadamente 30 tokens por segundo. Essa eficiência aproxima a arquitetura Mixture-of-Experts (MoE) da acessibilidade generalizada, reduzindo significativamente as barreiras à implantação local.
Inovação-chave: a tecnologia de upcycling transforma o potencial
A característica que mais se destaca no Marco-Mini-Instruct não é seu tamanho ou velocidade, mas seu método de criação exclusivo. Em vez de ser treinado do zero, esse modelo foi desenvolvido a partir do modelo Qwen3-0.6B-Base usando a tecnologia de upcycling.
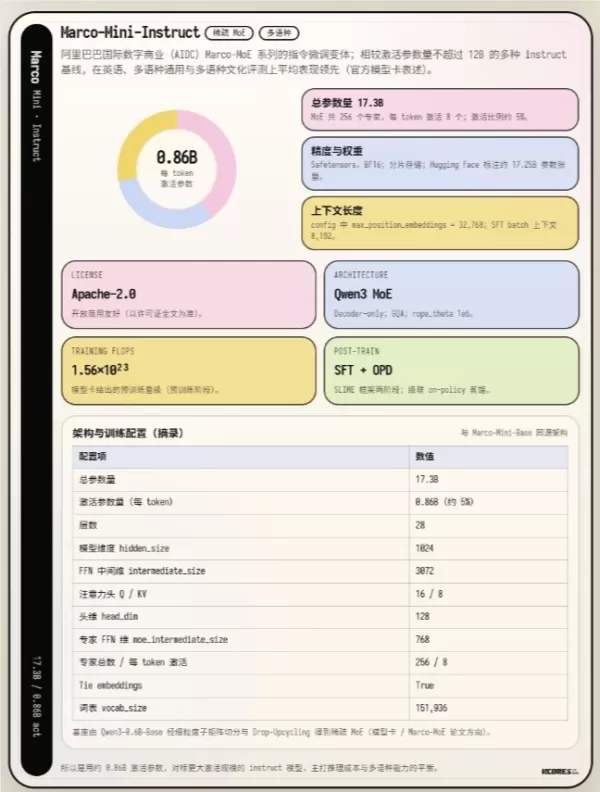
Esse processo envolve dividir ou copiar componentes de um modelo pequeno e denso em múltiplos especialistas, introduzindo um mecanismo de roteamento. Ele também integra o particionamento refinado de submatrizes e estratégias de “Drop-Upcycling” — descartando aleatoriamente certos especialistas ou caminhos de roteamento durante o treinamento para adicionar regularização e melhorar a robustez. Essa abordagem transforma com sucesso um modelo Dense puro em uma arquitetura MoE, oferecendo ao setor um caminho novo, econômico e eficiente para o treinamento MoE.
Comprimento do contexto e configuração do treinamento
A configuração do modelo expande o `max_position_embeddings` para 32K, embora a fase de Ajuste Fino Supervisionado (SFT) utilize um contexto de 8.192 tokens. Consequentemente, o comprimento padrão do contexto é adequado para a maioria dos cenários práticos de aplicação.
Avanço pós-treinamento: destilação em cascata baseada na política
A fase pós-treinamento é igualmente impressionante: ela começa com o pré-aquecimento do SFT, seguido por uma estratégia de destilação on-policy em cascata. Inicialmente, a destilação utiliza o Qwen3-30B-A3B-Instruct como modelo professor e, em seguida, muda para o Qwen3-Next-80B-A3B-Instruct, que é mais potente. Os dados de destilação abrangem o cumprimento de instruções, raciocínio complexo, segurança de alinhamento e capacidades matemáticas, garantindo que o modelo mantenha a eficiência ao mesmo tempo em que aumenta significativamente a inteligência geral.
Resultados de benchmark: 0,86 bilhão de parâmetros ativos superam modelos densos de 4 bilhões
O Marco-Mini-Instruct final supera muitos modelos densos, como o Qwen3-4B, na maioria dos benchmarks convencionais. Com apenas 0,86 bilhão de parâmetros ativos, ele valida plenamente o vasto potencial da arquitetura MoE em oferecer um desempenho “pequeno, mas poderoso”.
Impacto no setor: um novo paradigma de treinamento MoE de código aberto
A AIbase acredita que o maior valor dessa conquista reside na abertura de novas oportunidades para os desenvolvedores. Não há mais necessidade de treinar modelos MoE em grande escala a partir do zero; em vez disso, as equipes podem selecionar um modelo denso pequeno adequado e reproduzir rigorosamente os processos de upcycling e Drop-Upcycling descritos no artigo. O custo total do treinamento permanece administrável: a fase SFT requer 64 GPUs por 24 horas, e a fase de destilação precisa de 64 GPUs por 110 horas, reduzindo significativamente o limiar para que equipes de pequeno e médio porte experimentem o MoE.
A mais recente “modificação” da Alibaba prova mais uma vez que avanços na eficiência dos modelos não dependem necessariamente do empilhamento de parâmetros; paradigmas inovadores de treinamento também podem impulsionar saltos qualitativos. O lançamento do Marco-Mini-Instruct, sem dúvida, acelerará a adoção da tecnologia MoE em dispositivos de borda e em cenários de desenvolvimento pessoal, tornando-o um avanço fundamental a ser acompanhado por todo o setor.
Artigo relacionado
 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Recomendações de tópicos especiais relacionados
Design e Arte
 Ferramentas de referência de estilo visual baseadas em IA para fichas de personagens, moodboards e apresentações de projetos
As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
 11 ferramentas
 xix.ai
SEO
As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

 Comentários (0)
A equipe de Comércio Digital da Ali International apresentou o Marco-Mini-Instruct, a mais recente adição à série Marco-MoE, demonstrando como “escalas menores podem gerar grandes resultados”. Com um total de 17,3 bilhões de parâmetros, apenas 0,86 bilhão estão ativos (aproximadamente 5%), permitindo uma velocidade de inferência excepcional que funciona perfeitamente até mesmo em CPUs padrão.
Ultraleve: otimizado para desempenho da CPU
De acordo com dados oficiais, utilizando quantização de 8 bits com quatro módulos de memória DDR4 2400, o modelo atinge uma velocidade de inferência de aproximadamente 30 tokens por segundo. Essa eficiência aproxima a arquitetura Mixture-of-Experts (MoE) da acessibilidade generalizada, reduzindo significativamente as barreiras à implantação local.
Inovação-chave: a tecnologia de upcycling transforma o potencial
A característica que mais se destaca no Marco-Mini-Instruct não é seu tamanho ou velocidade, mas seu método de criação exclusivo. Em vez de ser treinado do zero, esse modelo foi desenvolvido a partir do modelo Qwen3-0.6B-Base usando a tecnologia de upcycling.
Esse processo envolve dividir ou copiar componentes de um modelo pequeno e denso em múltiplos especialistas, introduzindo um mecanismo de roteamento. Ele também integra o particionamento refinado de submatrizes e estratégias de “Drop-Upcycling” — descartando aleatoriamente certos especialistas ou caminhos de roteamento durante o treinamento para adicionar regularização e melhorar a robustez. Essa abordagem transforma com sucesso um modelo Dense puro em uma arquitetura MoE, oferecendo ao setor um caminho novo, econômico e eficiente para o treinamento MoE.
Comprimento do contexto e configuração do treinamento
A configuração do modelo expande o `max_position_embeddings` para 32K, embora a fase de Ajuste Fino Supervisionado (SFT) utilize um contexto de 8.192 tokens. Consequentemente, o comprimento padrão do contexto é adequado para a maioria dos cenários práticos de aplicação.
Avanço pós-treinamento: destilação em cascata baseada na política
A fase pós-treinamento é igualmente impressionante: ela começa com o pré-aquecimento do SFT, seguido por uma estratégia de destilação on-policy em cascata. Inicialmente, a destilação utiliza o Qwen3-30B-A3B-Instruct como modelo professor e, em seguida, muda para o Qwen3-Next-80B-A3B-Instruct, que é mais potente. Os dados de destilação abrangem o cumprimento de instruções, raciocínio complexo, segurança de alinhamento e capacidades matemáticas, garantindo que o modelo mantenha a eficiência ao mesmo tempo em que aumenta significativamente a inteligência geral.
Resultados de benchmark: 0,86 bilhão de parâmetros ativos superam modelos densos de 4 bilhões
O Marco-Mini-Instruct final supera muitos modelos densos, como o Qwen3-4B, na maioria dos benchmarks convencionais. Com apenas 0,86 bilhão de parâmetros ativos, ele valida plenamente o vasto potencial da arquitetura MoE em oferecer um desempenho “pequeno, mas poderoso”.
Impacto no setor: um novo paradigma de treinamento MoE de código aberto
A AIbase acredita que o maior valor dessa conquista reside na abertura de novas oportunidades para os desenvolvedores. Não há mais necessidade de treinar modelos MoE em grande escala a partir do zero; em vez disso, as equipes podem selecionar um modelo denso pequeno adequado e reproduzir rigorosamente os processos de upcycling e Drop-Upcycling descritos no artigo. O custo total do treinamento permanece administrável: a fase SFT requer 64 GPUs por 24 horas, e a fase de destilação precisa de 64 GPUs por 110 horas, reduzindo significativamente o limiar para que equipes de pequeno e médio porte experimentem o MoE.
A mais recente “modificação” da Alibaba prova mais uma vez que avanços na eficiência dos modelos não dependem necessariamente do empilhamento de parâmetros; paradigmas inovadores de treinamento também podem impulsionar saltos qualitativos. O lançamento do Marco-Mini-Instruct, sem dúvida, acelerará a adoção da tecnologia MoE em dispositivos de borda e em cenários de desenvolvimento pessoal, tornando-o um avanço fundamental a ser acompanhado por todo o setor.








 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA

As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
11 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai












