


 Hogar
Black Tech de Ali: modelo de 0,6 mil millones actualizado a 17 mil millones de MoE con un 5 % de parámetros activos, que se ejecuta en la CPU a 30 tokens por segundo
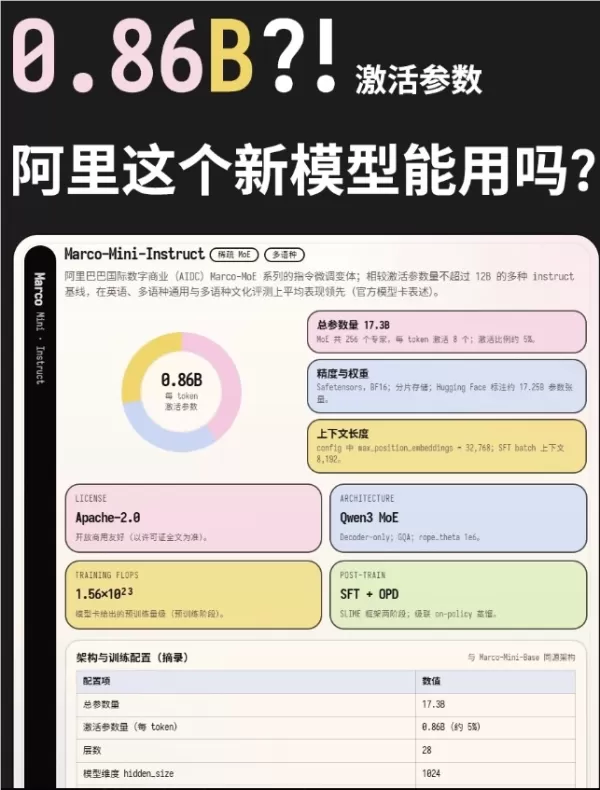
El equipo de Ali International Digital Commerce ha presentado Marco-Mini-Instruct, la última incorporación a la serie Marco-MoE, que demuestra cómo «las escalas más pequeñas pueden ofrecer grandes resultados». De un total de 17 300 millones de parámetros, solo 860 millones están activos (aproximadamente el 5 %), lo que permite una velocidad de inferencia excepcional que funciona con fluidez incluso en CPU estándar.
Ultraligero: optimizado para el rendimiento de la CPU
Según datos oficiales, utilizando una cuantificación de 8 bits con cuatro módulos de memoria DDR4 2400, el modelo alcanza una velocidad de inferencia de aproximadamente 30 tokens por segundo. Esta eficiencia acerca la arquitectura «Mixture-of-Experts» (MoE) a la accesibilidad generalizada, reduciendo significativamente las barreras para su implementación local.
Innovación clave: la tecnología de «upcycling» transforma el potencial
La característica más destacada de Marco-Mini-Instruct no es su tamaño ni su velocidad, sino su método de creación único. En lugar de entrenarse desde cero, este modelo se desarrolló a partir del modelo Qwen3-0.6B-Base utilizando tecnología de «upcycling ».
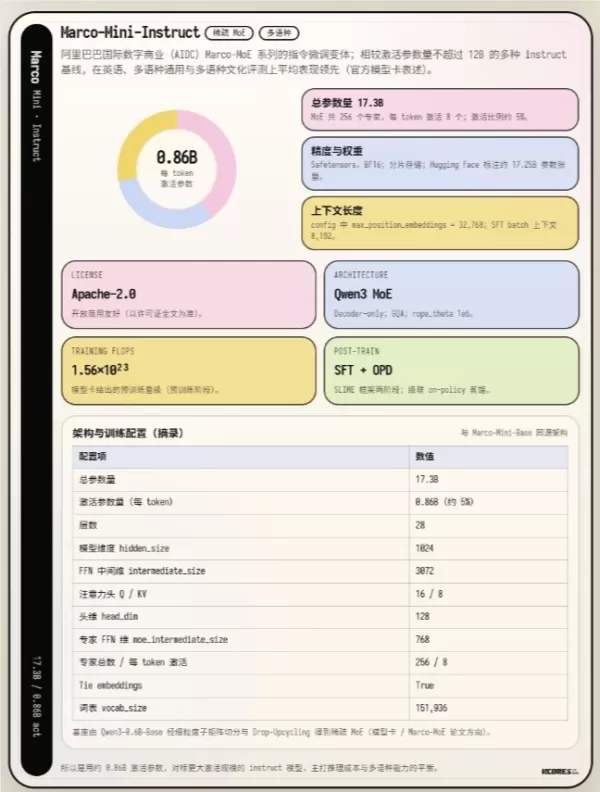
Este proceso implica dividir o copiar componentes de un modelo pequeño denso en múltiples expertos, introduciendo un mecanismo de enrutamiento. También integra una partición de submatrices de alta precisión y estrategias de «Drop-Upcycling» —descartar aleatoriamente ciertos expertos o rutas de enrutamiento durante el entrenamiento para añadir regularización y mejorar la robustez—. Este enfoque consigue convertir con éxito un modelo «Dense» puro en una arquitectura MoE, ofreciendo al sector una vía nueva, rentable y eficiente para el entrenamiento MoE.
Longitud del contexto y configuración del entrenamiento
La configuración del modelo amplía max_position_embeddings a 32K, aunque la fase de ajuste fino supervisado (SFT) utiliza un contexto de 8192 tokens. Por consiguiente, la longitud de contexto predeterminada se adapta bien a la mayoría de los escenarios de aplicación prácticos.
Avance tras el entrenamiento: destilación en cascada «on-policy»
La fase posterior al entrenamiento es igualmente impresionante: comienza con un precalentamiento mediante SFT, seguido de una estrategia de destilación «on-policy» en cascada. Inicialmente, la destilación utiliza Qwen3-30B-A3B-Instruct como modelo maestro, para luego pasar al más potente Qwen3-Next-80B-A3B-Instruct. Los datos de destilación abarcan el seguimiento de instrucciones, el razonamiento complejo, la seguridad en la alineación y las capacidades matemáticas, lo que garantiza que el modelo mantenga su eficiencia al tiempo que potencia significativamente su inteligencia general.
Resultados de las pruebas comparativas: 0,86 mil millones de parámetros activos superan a modelos densos de 4 mil millones
El Marco-Mini-Instruct final supera a muchos modelos densos, como el Qwen3-4B, en la mayoría de las pruebas de rendimiento habituales. Con solo 860 millones de parámetros activos, confirma plenamente el enorme potencial de la arquitectura MoE para ofrecer un rendimiento «pequeño pero potente».
Impacto en el sector: un nuevo paradigma de entrenamiento MoE de código abierto
AIbase cree que el mayor valor de este logro reside en abrir nuevas oportunidades para los desarrolladores. Ya no es necesario entrenar modelos MoE a gran escala desde cero; en su lugar, los equipos pueden seleccionar un modelo denso pequeño adecuado y reproducir fielmente los procesos de «upcycling» y «drop-upcycling» descritos en el artículo. El coste total del entrenamiento sigue siendo asumible: la fase SFT requiere 64 GPU durante 24 horas, y la fase de destilación necesita 64 GPU durante 110 horas, lo que reduce considerablemente el umbral para que los equipos pequeños y medianos experimenten con MoE.
La última «modificación» de Alibaba demuestra una vez más que los avances en la eficiencia de los modelos no dependen necesariamente de la acumulación de parámetros; los paradigmas de entrenamiento innovadores también pueden impulsar saltos cualitativos. El lanzamiento de Marco-Mini-Instruct acelerará sin duda la adopción de la tecnología MoE en dispositivos periféricos y en entornos de desarrollo personal, lo que lo convierte en un avance clave al que debe prestar atención todo el sector.
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
Análisis de datos
 Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
 10 herramientas
 xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

 comentario (0)
0/500
El equipo de Ali International Digital Commerce ha presentado Marco-Mini-Instruct, la última incorporación a la serie Marco-MoE, que demuestra cómo «las escalas más pequeñas pueden ofrecer grandes resultados». De un total de 17 300 millones de parámetros, solo 860 millones están activos (aproximadamente el 5 %), lo que permite una velocidad de inferencia excepcional que funciona con fluidez incluso en CPU estándar.
Ultraligero: optimizado para el rendimiento de la CPU
Según datos oficiales, utilizando una cuantificación de 8 bits con cuatro módulos de memoria DDR4 2400, el modelo alcanza una velocidad de inferencia de aproximadamente 30 tokens por segundo. Esta eficiencia acerca la arquitectura «Mixture-of-Experts» (MoE) a la accesibilidad generalizada, reduciendo significativamente las barreras para su implementación local.
Innovación clave: la tecnología de «upcycling» transforma el potencial
La característica más destacada de Marco-Mini-Instruct no es su tamaño ni su velocidad, sino su método de creación único. En lugar de entrenarse desde cero, este modelo se desarrolló a partir del modelo Qwen3-0.6B-Base utilizando tecnología de «upcycling ».
Este proceso implica dividir o copiar componentes de un modelo pequeño denso en múltiples expertos, introduciendo un mecanismo de enrutamiento. También integra una partición de submatrices de alta precisión y estrategias de «Drop-Upcycling» —descartar aleatoriamente ciertos expertos o rutas de enrutamiento durante el entrenamiento para añadir regularización y mejorar la robustez—. Este enfoque consigue convertir con éxito un modelo «Dense» puro en una arquitectura MoE, ofreciendo al sector una vía nueva, rentable y eficiente para el entrenamiento MoE.
Longitud del contexto y configuración del entrenamiento
La configuración del modelo amplía max_position_embeddings a 32K, aunque la fase de ajuste fino supervisado (SFT) utiliza un contexto de 8192 tokens. Por consiguiente, la longitud de contexto predeterminada se adapta bien a la mayoría de los escenarios de aplicación prácticos.
Avance tras el entrenamiento: destilación en cascada «on-policy»
La fase posterior al entrenamiento es igualmente impresionante: comienza con un precalentamiento mediante SFT, seguido de una estrategia de destilación «on-policy» en cascada. Inicialmente, la destilación utiliza Qwen3-30B-A3B-Instruct como modelo maestro, para luego pasar al más potente Qwen3-Next-80B-A3B-Instruct. Los datos de destilación abarcan el seguimiento de instrucciones, el razonamiento complejo, la seguridad en la alineación y las capacidades matemáticas, lo que garantiza que el modelo mantenga su eficiencia al tiempo que potencia significativamente su inteligencia general.
Resultados de las pruebas comparativas: 0,86 mil millones de parámetros activos superan a modelos densos de 4 mil millones
El Marco-Mini-Instruct final supera a muchos modelos densos, como el Qwen3-4B, en la mayoría de las pruebas de rendimiento habituales. Con solo 860 millones de parámetros activos, confirma plenamente el enorme potencial de la arquitectura MoE para ofrecer un rendimiento «pequeño pero potente».
Impacto en el sector: un nuevo paradigma de entrenamiento MoE de código abierto
AIbase cree que el mayor valor de este logro reside en abrir nuevas oportunidades para los desarrolladores. Ya no es necesario entrenar modelos MoE a gran escala desde cero; en su lugar, los equipos pueden seleccionar un modelo denso pequeño adecuado y reproducir fielmente los procesos de «upcycling» y «drop-upcycling» descritos en el artículo. El coste total del entrenamiento sigue siendo asumible: la fase SFT requiere 64 GPU durante 24 horas, y la fase de destilación necesita 64 GPU durante 110 horas, lo que reduce considerablemente el umbral para que los equipos pequeños y medianos experimenten con MoE.
La última «modificación» de Alibaba demuestra una vez más que los avances en la eficiencia de los modelos no dependen necesariamente de la acumulación de parámetros; los paradigmas de entrenamiento innovadores también pueden impulsar saltos cualitativos. El lanzamiento de Marco-Mini-Instruct acelerará sin duda la adopción de la tecnología MoE en dispositivos periféricos y en entornos de desarrollo personal, lo que lo convierte en un avance clave al que debe prestar atención todo el sector.








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai












