


 Дом
Ali’s Black Tech: модель объёмом 0,6 млрд была модернизирована до 17 млрд MoE с 5 % активных параметров; работает на ЦП со скоростью 30 токенов в секунду
Команда Ali International Digital Commerce представила Marco-Mini-Instruct — новейшую разработку в серии Marco-MoE, которая демонстрирует, как «небольшие масштабы могут приносить большие результаты». Из 17,3 миллиарда параметров всего 0,86 миллиарда являются активными (примерно 5%), что обеспечивает исключительную скорость инференса, позволяющую модели плавно работать даже на стандартных процессорах.
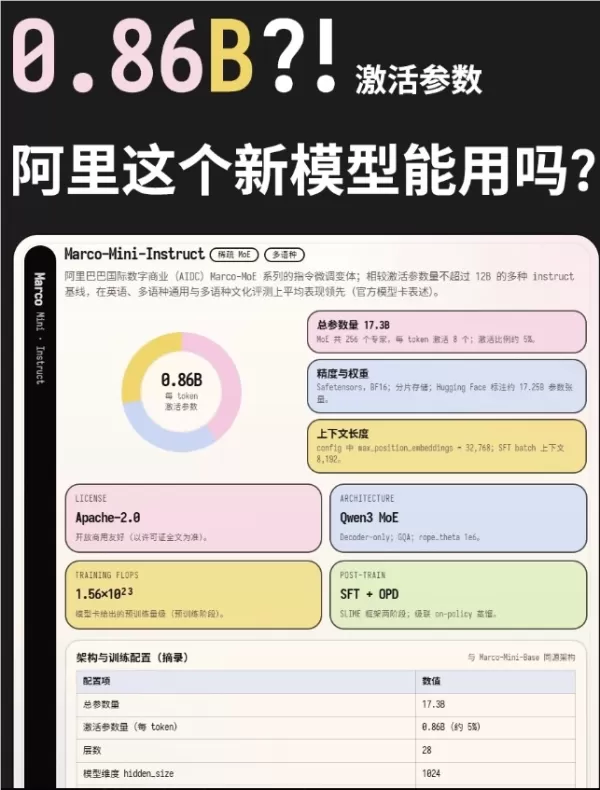
Сверхлегкая модель: оптимизирована для производительности ЦП
Согласно официальным данным, при использовании 8-битного квантования с четырьмя модулями памяти DDR4 2400 модель достигает скорости инференса примерно 30 токенов в секунду. Такая эффективность приближает архитектуру Mixture-of-Experts (MoE) к массовому использованию, значительно снижая барьеры для локального развертывания.
Ключевая инновация: технология «апсайклинга» преобразует потенциал
Отличительной особенностью Marco-Mini-Instruct является не её размер или скорость, а уникальный метод создания. Вместо обучения с нуля эта модель была разработана на основе модели Qwen3-0.6B-Base с использованием технологии «апсайклинга ».
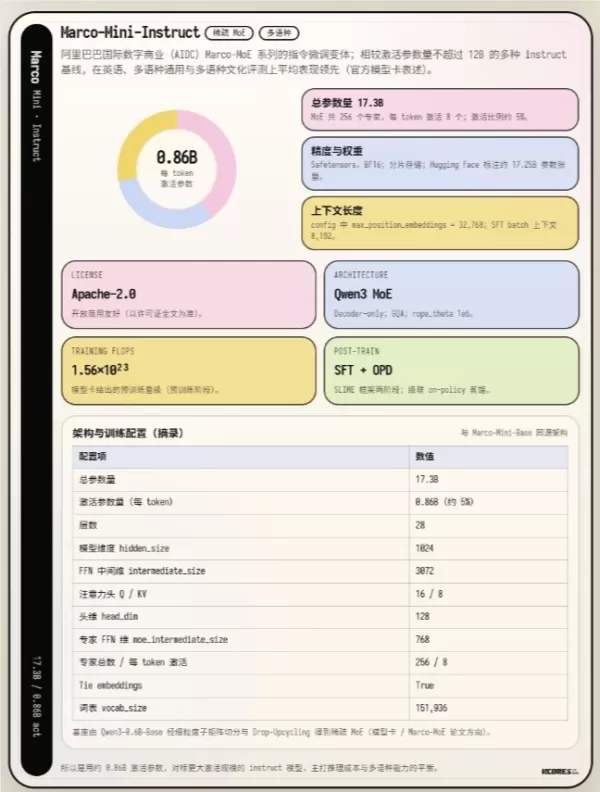
Этот процесс включает в себя разделение или копирование компонентов плотной небольшой модели на несколько экспертов с введением механизма маршрутизации. Он также объединяет мелкозернистое разбиение на подматрицы и стратегии «Drop-Upcycling» — случайное отбрасывание определённых экспертов или путей маршрутизации во время обучения для добавления регуляризации и повышения устойчивости. Данный подход позволяет успешно преобразовать чистую плотную модель в архитектуру MoE, предлагая отрасли новый, экономичный и эффективный путь для обучения моделей MoE.
Длина контекста и настройка обучения
Конфигурация модели расширяет max_position_embeddings до 32K, хотя на этапе Supervised Fine-Tuning (SFT) используется контекст длиной 8192 токена. Следовательно, длина контекста по умолчанию хорошо подходит для большинства практических сценариев применения.
Прорыв после обучения: каскадная дистилляция по политике
Фаза после обучения не менее впечатляет: она начинается с предварительной подготовки SFT, за которой следует стратегия каскадной дистилляции по политике. Первоначально в процессе дистилляции в качестве модели-наставника используется Qwen3-30B-A3B-Instruct, а затем происходит переход на более мощную модель Qwen3-Next-80B-A3B-Instruct. Данные для дистилляции охватывают следование инструкциям, сложное рассуждение, безопасность выравнивания и математические способности, что гарантирует сохранение эффективности модели при значительном повышении общего уровня интеллекта.
Результаты тестирования: 0,86 млрд активных параметров превосходят плотные модели объемом 4 млрд
Окончательная версия Marco-Mini-Instruct превосходит многие плотные модели, такие как Qwen3-4B, по большинству основных тестов. Имея всего 0,86 млрд активных параметров, она полностью подтверждает огромный потенциал архитектуры MoE в обеспечении «небольшой, но мощной» производительности.
Влияние на отрасль: новая парадигма обучения MoE с открытым исходным кодом
В AIbase считают, что главная ценность этого достижения заключается в открытии новых возможностей для разработчиков. Больше нет необходимости обучать крупномасштабные модели MoE с нуля; вместо этого команды могут выбрать подходящую небольшую плотную модель и строго воспроизвести процессы upcycling и Drop-Upcycling, описанные в статье. Общие затраты на обучение остаются приемлемыми: фаза SFT требует 64 графических процессоров в течение 24 часов, а фаза дистилляции — 64 графических процессоров в течение 110 часов, что значительно снижает порог для малых и средних команд, желающих экспериментировать с MoE.
Последнее «усовершенствование» от Alibaba в очередной раз доказывает, что прорывы в эффективности моделей не обязательно зависят от увеличения количества параметров; инновационные парадигмы обучения также могут способствовать качественному скачку. Выпуск Marco-Mini-Instruct, несомненно, ускорит внедрение технологии MoE в периферийных устройствах и сценариях личного разработчика, что делает его ключевым событием, за которым стоит следить всей отрасли.
Связанная статья
 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Рекомендации по связанным специальным темам
SEO
 Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
 13 инструментов
 xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

 Комментарии (0)
Команда Ali International Digital Commerce представила Marco-Mini-Instruct — новейшую разработку в серии Marco-MoE, которая демонстрирует, как «небольшие масштабы могут приносить большие результаты». Из 17,3 миллиарда параметров всего 0,86 миллиарда являются активными (примерно 5%), что обеспечивает исключительную скорость инференса, позволяющую модели плавно работать даже на стандартных процессорах.
Сверхлегкая модель: оптимизирована для производительности ЦП
Согласно официальным данным, при использовании 8-битного квантования с четырьмя модулями памяти DDR4 2400 модель достигает скорости инференса примерно 30 токенов в секунду. Такая эффективность приближает архитектуру Mixture-of-Experts (MoE) к массовому использованию, значительно снижая барьеры для локального развертывания.
Ключевая инновация: технология «апсайклинга» преобразует потенциал
Отличительной особенностью Marco-Mini-Instruct является не её размер или скорость, а уникальный метод создания. Вместо обучения с нуля эта модель была разработана на основе модели Qwen3-0.6B-Base с использованием технологии «апсайклинга ».
Этот процесс включает в себя разделение или копирование компонентов плотной небольшой модели на несколько экспертов с введением механизма маршрутизации. Он также объединяет мелкозернистое разбиение на подматрицы и стратегии «Drop-Upcycling» — случайное отбрасывание определённых экспертов или путей маршрутизации во время обучения для добавления регуляризации и повышения устойчивости. Данный подход позволяет успешно преобразовать чистую плотную модель в архитектуру MoE, предлагая отрасли новый, экономичный и эффективный путь для обучения моделей MoE.
Длина контекста и настройка обучения
Конфигурация модели расширяет max_position_embeddings до 32K, хотя на этапе Supervised Fine-Tuning (SFT) используется контекст длиной 8192 токена. Следовательно, длина контекста по умолчанию хорошо подходит для большинства практических сценариев применения.
Прорыв после обучения: каскадная дистилляция по политике
Фаза после обучения не менее впечатляет: она начинается с предварительной подготовки SFT, за которой следует стратегия каскадной дистилляции по политике. Первоначально в процессе дистилляции в качестве модели-наставника используется Qwen3-30B-A3B-Instruct, а затем происходит переход на более мощную модель Qwen3-Next-80B-A3B-Instruct. Данные для дистилляции охватывают следование инструкциям, сложное рассуждение, безопасность выравнивания и математические способности, что гарантирует сохранение эффективности модели при значительном повышении общего уровня интеллекта.
Результаты тестирования: 0,86 млрд активных параметров превосходят плотные модели объемом 4 млрд
Окончательная версия Marco-Mini-Instruct превосходит многие плотные модели, такие как Qwen3-4B, по большинству основных тестов. Имея всего 0,86 млрд активных параметров, она полностью подтверждает огромный потенциал архитектуры MoE в обеспечении «небольшой, но мощной» производительности.
Влияние на отрасль: новая парадигма обучения MoE с открытым исходным кодом
В AIbase считают, что главная ценность этого достижения заключается в открытии новых возможностей для разработчиков. Больше нет необходимости обучать крупномасштабные модели MoE с нуля; вместо этого команды могут выбрать подходящую небольшую плотную модель и строго воспроизвести процессы upcycling и Drop-Upcycling, описанные в статье. Общие затраты на обучение остаются приемлемыми: фаза SFT требует 64 графических процессоров в течение 24 часов, а фаза дистилляции — 64 графических процессоров в течение 110 часов, что значительно снижает порог для малых и средних команд, желающих экспериментировать с MoE.
Последнее «усовершенствование» от Alibaba в очередной раз доказывает, что прорывы в эффективности моделей не обязательно зависят от увеличения количества параметров; инновационные парадигмы обучения также могут способствовать качественному скачку. Выпуск Marco-Mini-Instruct, несомненно, ускорит внедрение технологии MoE в периферийных устройствах и сценариях личного разработчика, что делает его ключевым событием, за которым стоит следить всей отрасли.








 Suno добавляет водяные знаки на песни в ходе судебных разбирательств
Suno, платформа, позволяющая пользователям создавать музыку с помощью искусственного интеллекта, представила новые функции для маркировки треков, созданных на платформе, ограничения на скачивание и обновления стандартов сообщества для борьбы с несанк
 Маск признал, что утечка кода Grok привела к раскрытию пользовательских данных, и пообещал стереть всю историческую информацию.
Илон Маск напрямую отреагировал на скандал с конфиденциальностью вокруг Grok Build, начав с простого «Да», чтобы подтвердить достоверность инцидента. Он пообещал, что все данные пользователей, ранее загруженные в SpaceXAI, будут безвозвратно удалены,
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai












