


 Lar
A Tongyi, do Alibaba, lança o Fun-CineForge: modelo de IA de código aberto alcança síntese de voz com qualidade cinematográfica
O Alibaba Tongyi Lab lançou oficialmente e disponibilizou como código aberto, em 16 de março, o modelo multimodal de síntese de voz para múltiplos cenários e com qualidade cinematográfica, denominado Fun-CineForge. Esse modelo aborda os principais desafios da dublagem por IA, incluindo a falta de sincronização labial, a ausência de expressão emocional e as características vocais inconsistentes entre vários personagens. Ele também apresenta um método de alta qualidade para a construção de conjuntos de dados.
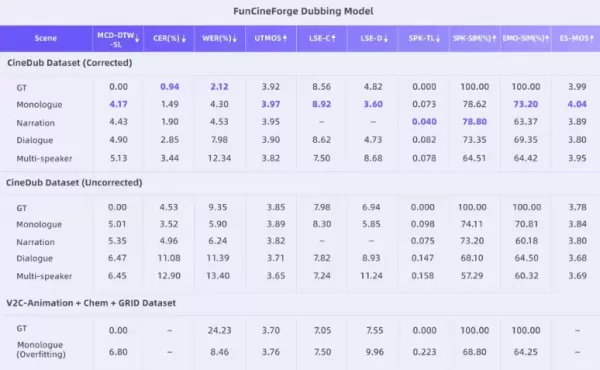
Tecnicamente, o Fun-CineForge é pioneiro no conceito de “modalidade temporal”. Ao contrário dos modelos convencionais que se concentram exclusivamente em texto ou imagens, ele garante que a síntese de voz ocorra em intervalos de tempo precisos por meio de um controle preciso de marcações de tempo. Mesmo em cenas cinematográficas complexas com personagens ocultos, cortes frequentes de câmera ou rostos desfocados, o modelo mantém um alto grau de sincronização audiovisual e adesão às instruções.
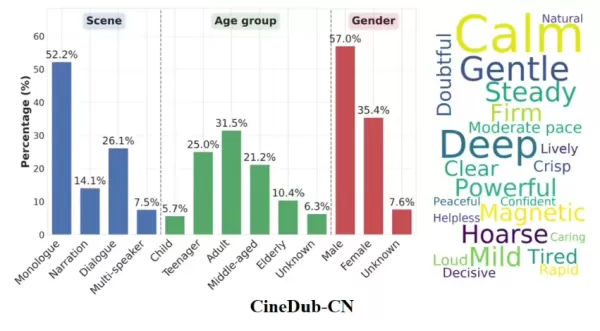
O pipeline de construção do conjunto de dados CineDub de código aberto que o acompanha é outra inovação fundamental. O Tongyi Lab empregou o raciocínio em cadeia de pensamento de grandes modelos de linguagem para transformar automaticamente filmagens brutas em dados estruturados, reduzindo significativamente a necessidade de anotação manual. Esse processo alcança uma taxa de erro de palavras de aproximadamente 1% e uma taxa de erro de diarização de falantes de apenas 1,20%, fornecendo uma base de treinamento altamente competitiva para grandes modelos.
O Fun-CineForge já está disponível no GitHub, HuggingFace e na comunidade ModelScope, oferecendo suporte à inferência para clipes de vídeo de até 30 segundos de duração. Ele se destaca não apenas em monólogos de um único locutor, mas também oferece suporte de nível profissional para cenários de diálogos em dueto e com múltiplos locutores. Esse avanço sinaliza a evolução da tecnologia de voz com IA, passando de funções básicas de atendimento ao cliente e assistência para a pós-produção de animações e filmes de alto padrão.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Artigo relacionado
 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Recomendações de tópicos especiais relacionados
Design e Arte
 Ferramentas de referência de estilo visual baseadas em IA para fichas de personagens, moodboards e apresentações de projetos
As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
 11 ferramentas
 xix.ai
SEO
As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

 Comentários (1)
![NicholasThomas]()
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.
O Alibaba Tongyi Lab lançou oficialmente e disponibilizou como código aberto, em 16 de março, o modelo multimodal de síntese de voz para múltiplos cenários e com qualidade cinematográfica, denominado Fun-CineForge. Esse modelo aborda os principais desafios da dublagem por IA, incluindo a falta de sincronização labial, a ausência de expressão emocional e as características vocais inconsistentes entre vários personagens. Ele também apresenta um método de alta qualidade para a construção de conjuntos de dados.
Tecnicamente, o Fun-CineForge é pioneiro no conceito de “modalidade temporal”. Ao contrário dos modelos convencionais que se concentram exclusivamente em texto ou imagens, ele garante que a síntese de voz ocorra em intervalos de tempo precisos por meio de um controle preciso de marcações de tempo. Mesmo em cenas cinematográficas complexas com personagens ocultos, cortes frequentes de câmera ou rostos desfocados, o modelo mantém um alto grau de sincronização audiovisual e adesão às instruções.
O pipeline de construção do conjunto de dados CineDub de código aberto que o acompanha é outra inovação fundamental. O Tongyi Lab empregou o raciocínio em cadeia de pensamento de grandes modelos de linguagem para transformar automaticamente filmagens brutas em dados estruturados, reduzindo significativamente a necessidade de anotação manual. Esse processo alcança uma taxa de erro de palavras de aproximadamente 1% e uma taxa de erro de diarização de falantes de apenas 1,20%, fornecendo uma base de treinamento altamente competitiva para grandes modelos.
O Fun-CineForge já está disponível no GitHub, HuggingFace e na comunidade ModelScope, oferecendo suporte à inferência para clipes de vídeo de até 30 segundos de duração. Ele se destaca não apenas em monólogos de um único locutor, mas também oferece suporte de nível profissional para cenários de diálogos em dueto e com múltiplos locutores. Esse avanço sinaliza a evolução da tecnologia de voz com IA, passando de funções básicas de atendimento ao cliente e assistência para a pós-produção de animações e filmes de alto padrão.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 A Seed, da ByteDance, lança campanha global de captação de talentos em campus universitários, oferecendo ações virtuais para conquistar os melhores especialistas em grandes modelos de inteligência artificial
No cenário competitivo dos grandes modelos de linguagem, garantir talentos de alto nível continua sendo o ativo estratégico mais crítico.Em 1º de abril, ByteDance anunciou o lançamento de sua iniciativa global de recrutamento campus Seed, parte de se
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA

As melhores e mais recentes ferramentas de referência de estilo visual com IA para fichas de personagens, moodboards e apresentações de projetos de 2026 já estão disponíveis no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta ferramentas poderosas e revolucionárias que passaram por rigorosos testes na prática. Você encontrará uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para ajudar a impulsionar sua criatividade e otimizar seu fluxo de trabalho. Explore agora para descobrir a ferramenta perfeita para aumentar sua produtividade!
11 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.












