


 Hogar
Tongyi, de Alibaba, presenta Fun-CineForge: un modelo de IA de código abierto que logra una síntesis de voz con calidad cinematográfica
El 16 de marzo, Alibaba Tongyi Lab presentó oficialmente y puso a disposición como código abierto el modelo multimodal de síntesis de voz para múltiples escenarios y con calidad cinematográfica Fun-CineForge. Este modelo aborda los principales retos del doblaje con IA, entre los que se incluyen la falta de sincronización labial, la falta de expresión emocional y las características vocales inconsistentes entre los distintos personajes. Además, introduce un método de alta calidad para la construcción de conjuntos de datos.
Técnicamente, Fun-CineForge es pionero en el concepto de «modalidad temporal». A diferencia de los modelos convencionales que se centran únicamente en el texto o las imágenes, garantiza que la síntesis de voz se produzca en intervalos de tiempo precisos mediante un control exacto de las marcas de tiempo. Incluso en escenas cinematográficas complejas con personajes ocultos, cortes frecuentes de cámara o rostros borrosos, el modelo mantiene un alto grado de sincronización audiovisual y de cumplimiento de las instrucciones.
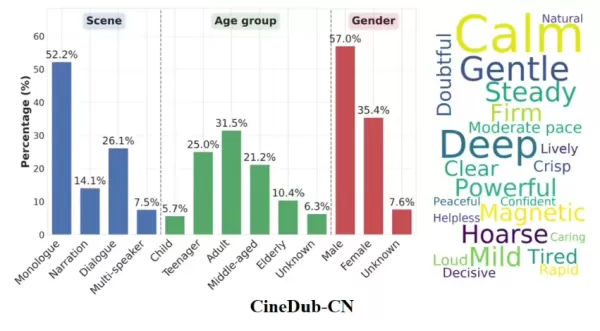
El canal de construcción del conjunto de datos de código abierto CineDub que lo acompaña es otra innovación clave. Tongyi Lab empleó el razonamiento de cadena de pensamiento de los grandes modelos de lenguaje para transformar automáticamente el metraje cinematográfico sin procesar en datos estructurados, lo que redujo significativamente la necesidad de anotación manual. Este proceso alcanza una tasa de error de palabras de aproximadamente el 1 % y una tasa de error de diarización de hablantes de solo el 1,20 %, lo que proporciona una base de entrenamiento altamente competitiva para modelos de gran tamaño.
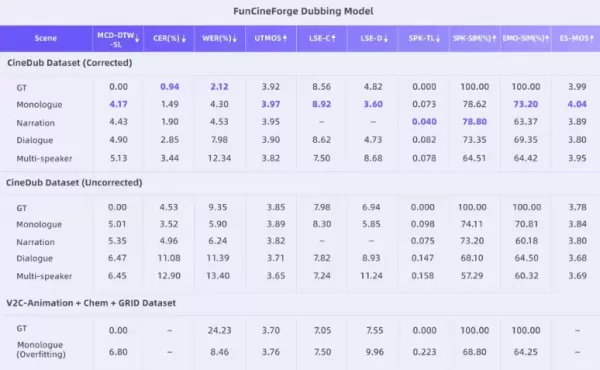
Fun-CineForge ya está disponible en GitHub, HuggingFace y la comunidad ModelScope, y admite la inferencia de clips de vídeo de hasta 30 segundos de duración. Destaca no solo en monólogos de un solo hablante, sino que también ofrece soporte de nivel profesional para escenarios de diálogo a dúo y con varios hablantes. Este avance marca la evolución de la tecnología de voz de IA, pasando de funciones básicas de atención al cliente y asistencia a la postproducción de animación y cine de alto nivel.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Artículo relacionado
 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Herramientas de referencia de estilos visuales basadas en IA para fichas de personajes, moodboards y presentaciones
¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
 11 herramientas
 xix.ai
SEO
Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

 comentario (1)
0/500
![NicholasThomas]()
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.
El 16 de marzo, Alibaba Tongyi Lab presentó oficialmente y puso a disposición como código abierto el modelo multimodal de síntesis de voz para múltiples escenarios y con calidad cinematográfica Fun-CineForge. Este modelo aborda los principales retos del doblaje con IA, entre los que se incluyen la falta de sincronización labial, la falta de expresión emocional y las características vocales inconsistentes entre los distintos personajes. Además, introduce un método de alta calidad para la construcción de conjuntos de datos.
Técnicamente, Fun-CineForge es pionero en el concepto de «modalidad temporal». A diferencia de los modelos convencionales que se centran únicamente en el texto o las imágenes, garantiza que la síntesis de voz se produzca en intervalos de tiempo precisos mediante un control exacto de las marcas de tiempo. Incluso en escenas cinematográficas complejas con personajes ocultos, cortes frecuentes de cámara o rostros borrosos, el modelo mantiene un alto grado de sincronización audiovisual y de cumplimiento de las instrucciones.
El canal de construcción del conjunto de datos de código abierto CineDub que lo acompaña es otra innovación clave. Tongyi Lab empleó el razonamiento de cadena de pensamiento de los grandes modelos de lenguaje para transformar automáticamente el metraje cinematográfico sin procesar en datos estructurados, lo que redujo significativamente la necesidad de anotación manual. Este proceso alcanza una tasa de error de palabras de aproximadamente el 1 % y una tasa de error de diarización de hablantes de solo el 1,20 %, lo que proporciona una base de entrenamiento altamente competitiva para modelos de gran tamaño.
Fun-CineForge ya está disponible en GitHub, HuggingFace y la comunidad ModelScope, y admite la inferencia de clips de vídeo de hasta 30 segundos de duración. Destaca no solo en monólogos de un solo hablante, sino que también ofrece soporte de nivel profesional para escenarios de diálogo a dúo y con varios hablantes. Este avance marca la evolución de la tecnología de voz de IA, pasando de funciones básicas de atención al cliente y asistencia a la postproducción de animación y cine de alto nivel.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se

¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
11 herramientas
xix.ai

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.












