


 Maison
Moonshot AI et l'université Tsinghua dévoilent l'architecture PrfaaS pour surmonter les goulots d'étranglement liés à la puissance de calcul des grands modèles
Les nouvelles technologies permettent de surmonter les goulots d'étranglement en matière de performances des grands modèles linguistiques (LLM). Récemment, des chercheurs de Moonshot AI (Moonshot) et de l'université Tsinghua ont présenté une architecture novatrice appelée Prefill-as-a-Service (PrfaaS). Cette étude s'attaque aux contraintes matérielles liées au déploiement de services de modèles de grande taille dans les centres de données en optimisant l'allocation des ressources de calcul, ce qui améliore considérablement l'efficacité de l'inférence.
Percée technique : une séparation « chirurgicale » entre le préremplissage et le décodage
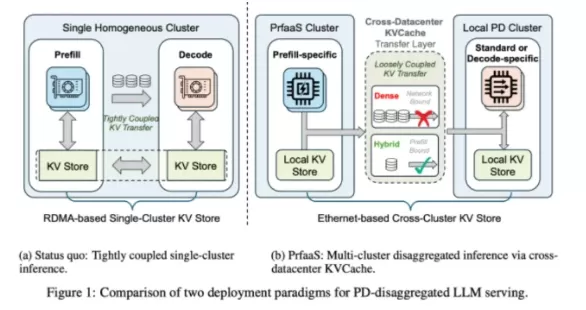
Actuellement, le processus d'inférence des grands modèles linguistiques comprend deux phases distinctes :
Phase de préremplissage : cette phase est très gourmande en ressources de calcul ; elle gère le traitement des entrées et génère un cache clé-valeur (KVCache).
Phase de décodage : cette phase est gourmande en bande passante mémoire et génère la sortie mot par mot.
Dans les architectures traditionnelles, ces deux phases sont généralement gérées au sein du même centre de données, voire du même serveur. Comme elles ont des besoins différents en ressources matérielles, ce « regroupement forcé » crée souvent un déséquilibre dans l’allocation des ressources de calcul et de bande passante, ce qui entraîne une congestion du service.
Innovation principale : collaboration interrégionale efficace
Le principal atoutde PrfaaS réside dans la mise en place d’un service découplé. Il déleste les tâches de préremplissage gourmandes en calcul vers des clusters spécialisés à haute capacité de calcul. Une fois les tâches terminées, le système utilise un réseau Ethernet standard pour transférer à distance le KVCache généré vers un cluster de décodage local.
Cette conception élimine les contraintes d’espace physique, permettant au préremplissage et au décodage de s’exécuter simultanément dans différents centres de données. Pour garantir un transfert efficace, PrfaaS intègre un mécanisme de planification à deux échelles de temps qui alloue les ressources de manière flexible en fonction des fluctuations du trafic en temps réel, associé à un routage précis pour éviter que les requêtes de texte longues ne soient retardées par une répartition inégale des ressources.
Résultats des tests : optimisation du débit et de la latence
Les données de recherche démontrent que l'architecture PrfaaS offre des performances remarquables dans des applications concrètes :
Le débit du service a augmenté de 54 %, améliorant considérablement le nombre de requêtes traitées par unité de temps.
La latence de réponse a considérablement diminué, accélérant la génération du premier jeton du point de vue de l'utilisateur.
L'utilisation des ressources a été optimisée grâce à la séparation des sous-systèmes de calcul, de réseau et de stockage, ce qui a permis d'éviter les problèmes de congestion observés dans les architectures traditionnelles.
La collaboration entre Moonshot AI et l'université de Tsinghua offre non seulement de nouvelles approches techniques pour l'inférence IA à grande échelle, mais jette également les bases de futurs réseaux informatiques interrégionaux. Ce modèle Prefill-as-a-Service pourrait constituer une étape clé dans le déploiement industriel des grands modèles.
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (1)
![HarryRoberts]()
Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔
Les nouvelles technologies permettent de surmonter les goulots d'étranglement en matière de performances des grands modèles linguistiques (LLM). Récemment, des chercheurs de Moonshot AI (Moonshot) et de l'université Tsinghua ont présenté une architecture novatrice appelée Prefill-as-a-Service (PrfaaS). Cette étude s'attaque aux contraintes matérielles liées au déploiement de services de modèles de grande taille dans les centres de données en optimisant l'allocation des ressources de calcul, ce qui améliore considérablement l'efficacité de l'inférence.
Percée technique : une séparation « chirurgicale » entre le préremplissage et le décodage
Actuellement, le processus d'inférence des grands modèles linguistiques comprend deux phases distinctes :
Phase de préremplissage : cette phase est très gourmande en ressources de calcul ; elle gère le traitement des entrées et génère un cache clé-valeur (KVCache).
Phase de décodage : cette phase est gourmande en bande passante mémoire et génère la sortie mot par mot.
Dans les architectures traditionnelles, ces deux phases sont généralement gérées au sein du même centre de données, voire du même serveur. Comme elles ont des besoins différents en ressources matérielles, ce « regroupement forcé » crée souvent un déséquilibre dans l’allocation des ressources de calcul et de bande passante, ce qui entraîne une congestion du service.
Innovation principale : collaboration interrégionale efficace
Le principal atout
Cette conception élimine les contraintes d’espace physique, permettant au préremplissage et au décodage de s’exécuter simultanément dans différents centres de données. Pour garantir un transfert efficace, PrfaaS intègre un mécanisme de planification à deux échelles de temps qui alloue les ressources de manière flexible en fonction des fluctuations du trafic en temps réel, associé à un routage précis pour éviter que les requêtes de texte longues ne soient retardées par une répartition inégale des ressources.
Résultats des tests : optimisation du débit et de la latence
Les données de recherche démontrent que l'architecture PrfaaS offre des performances remarquables dans des applications concrètes :
Le débit du service a augmenté de 54 %, améliorant considérablement le nombre de requêtes traitées par unité de temps.
La latence de réponse a considérablement diminué, accélérant la génération du premier jeton du point de vue de l'utilisateur.
L'utilisation des ressources a été optimisée grâce à la séparation des sous-systèmes de calcul, de réseau et de stockage, ce qui a permis d'éviter les problèmes de congestion observés dans les architectures traditionnelles.
La collaboration entre Moonshot AI et l'université de Tsinghua offre non seulement de nouvelles approches techniques pour l'inférence IA à grande échelle, mais jette également les bases de futurs réseaux informatiques interrégionaux. Ce modèle Prefill-as-a-Service pourrait constituer une étape clé dans le déploiement industriel des grands modèles.








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔












