


 Heim
Moonshot AI und die Tsinghua-Universität stellen die PrfaaS-Architektur vor, um den Engpass bei der Rechenleistung großer Modelle zu überwinden
Neue Technologien überwinden den Leistungsengpass großer Sprachmodelle (LLMs). Kürzlich stellten Forscher von Moonshot AI (Moonshot) und der Tsinghua-Universität eine neuartige Architektur namens Prefill-as-a-Service (PrfaaS) vor. Diese Studie befasst sich mit Hardware-Einschränkungen bei der Bereitstellung großer Modelldienste in Rechenzentren, indem sie die Zuweisung von Rechenressourcen optimiert und dadurch die Effizienz der Inferenz erheblich steigert.
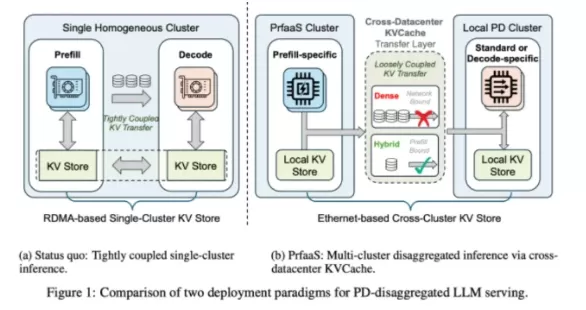
Technischer Durchbruch: Eine „chirurgische“ Trennung von Prefill und Decode
Derzeit umfasst der Inferenzprozess für große Sprachmodelle zwei unterschiedliche Phasen:
Prefill-Phase: Diese Phase ist rechenintensiv, da sie die Eingabeverarbeitung übernimmt und einen Schlüssel-Wert-Cache (KVCache) generiert.
Decode-Phase: Diese Phase ist speicher- und bandbreitenintensiv und generiert die Ausgabe Wort für Wort.
In herkömmlichen Architekturen werden beide Phasen in der Regel innerhalb desselben Rechenzentrums oder sogar desselben Servers abgewickelt. Da sie unterschiedliche Anforderungen an die Hardware-Ressourcen stellen, führt diese „erzwungene Bündelung“ oft zu einem Ungleichgewicht bei der Zuweisung von Rechenleistung und Bandbreite, was zu einer Überlastung des Dienstes führt.
Kerninnovation: Effiziente regionenübergreifende Zusammenarbeit
Das zentrale Highlightvon PrfaaS ist die Realisierung eines entkoppelten Dienstes. Es lagert die rechenintensiven Prefill-Aufgaben an spezialisierte Hochleistungs-Cluster aus. Nach Abschluss der Aufgaben nutzt das System Standard-Ethernet, um den generierten KVCache remote an einen lokalen Dekodierungs-Cluster zu übertragen.
Dieses Design beseitigt physische Platzbeschränkungen und ermöglicht es, dass Vorabfüllung und Dekodierung gleichzeitig über verschiedene Rechenzentren hinweg ablaufen. Um eine effiziente Übertragung zu gewährleisten, integriert PrfaaS einen Scheduling-Mechanismus mit zwei Zeitskalen, der Ressourcen flexibel auf der Grundlage von Echtzeit-Verkehrsschwankungen zuweist, gepaart mit präzisem Routing, um zu verhindern, dass lange Textanfragen durch eine ungleichmäßige Ressourcenverteilung verzögert werden.
Testergebnisse: Optimierung von Durchsatz und Latenz
Forschungsdaten belegen, dass die PrfaaS-Architektur in realen Anwendungen eine bemerkenswerte Leistung erbringt:
Der Dienstdurchsatz stieg um 54 %, wodurch sich die Anzahl der pro Zeiteinheit bearbeiteten Anfragen deutlich verbesserte.
Die Antwortlatenz verringerte sich deutlich, wodurch die Generierung des ersten Tokens aus Sicht des Benutzers schneller erfolgte.
Die Ressourcennutzung wurde durch die Trennung von Rechen-, Netzwerk- und Speichersubsystemenmaximiert, wodurch Überlastungsprobleme vermieden wurden, die bei herkömmlichen Architekturen auftreten.
Die Zusammenarbeit zwischen Moonshot AI und der Tsinghua-Universität bietet nicht nur neue technische Ansätze für groß angelegte KI-Inferenz, sondern legt auch den Grundstein für zukünftige regionenübergreifende Rechennetzwerke. Dieses Prefill-as-a-Service-Modell könnte zu einem wichtigen Meilenstein bei der industriellen Einführung großer Modelle werden.
Verwandter Artikel
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
Empfehlungen zu verwandten Spezialthemen
SEO
 Die besten KI-Tools zur SERP-Analyse für die Suchstrategie
Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
 13 Tools
 xix.ai
Datenanalyse
Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

 Kommentare (1)
![HarryRoberts]()
Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔
Neue Technologien überwinden den Leistungsengpass großer Sprachmodelle (LLMs). Kürzlich stellten Forscher von Moonshot AI (Moonshot) und der Tsinghua-Universität eine neuartige Architektur namens Prefill-as-a-Service (PrfaaS) vor. Diese Studie befasst sich mit Hardware-Einschränkungen bei der Bereitstellung großer Modelldienste in Rechenzentren, indem sie die Zuweisung von Rechenressourcen optimiert und dadurch die Effizienz der Inferenz erheblich steigert.
Technischer Durchbruch: Eine „chirurgische“ Trennung von Prefill und Decode
Derzeit umfasst der Inferenzprozess für große Sprachmodelle zwei unterschiedliche Phasen:
Prefill-Phase: Diese Phase ist rechenintensiv, da sie die Eingabeverarbeitung übernimmt und einen Schlüssel-Wert-Cache (KVCache) generiert.
Decode-Phase: Diese Phase ist speicher- und bandbreitenintensiv und generiert die Ausgabe Wort für Wort.
In herkömmlichen Architekturen werden beide Phasen in der Regel innerhalb desselben Rechenzentrums oder sogar desselben Servers abgewickelt. Da sie unterschiedliche Anforderungen an die Hardware-Ressourcen stellen, führt diese „erzwungene Bündelung“ oft zu einem Ungleichgewicht bei der Zuweisung von Rechenleistung und Bandbreite, was zu einer Überlastung des Dienstes führt.
Kerninnovation: Effiziente regionenübergreifende Zusammenarbeit
Das zentrale Highlight
Dieses Design beseitigt physische Platzbeschränkungen und ermöglicht es, dass Vorabfüllung und Dekodierung gleichzeitig über verschiedene Rechenzentren hinweg ablaufen. Um eine effiziente Übertragung zu gewährleisten, integriert PrfaaS einen Scheduling-Mechanismus mit zwei Zeitskalen, der Ressourcen flexibel auf der Grundlage von Echtzeit-Verkehrsschwankungen zuweist, gepaart mit präzisem Routing, um zu verhindern, dass lange Textanfragen durch eine ungleichmäßige Ressourcenverteilung verzögert werden.
Testergebnisse: Optimierung von Durchsatz und Latenz
Forschungsdaten belegen, dass die PrfaaS-Architektur in realen Anwendungen eine bemerkenswerte Leistung erbringt:
Der Dienstdurchsatz stieg um 54 %, wodurch sich die Anzahl der pro Zeiteinheit bearbeiteten Anfragen deutlich verbesserte.
Die Antwortlatenz verringerte sich deutlich, wodurch die Generierung des ersten Tokens aus Sicht des Benutzers schneller erfolgte.
Die Ressourcennutzung wurde durch die Trennung von Rechen-, Netzwerk- und Speichersubsystemenmaximiert, wodurch Überlastungsprobleme vermieden wurden, die bei herkömmlichen Architekturen auftreten.
Die Zusammenarbeit zwischen Moonshot AI und der Tsinghua-Universität bietet nicht nur neue technische Ansätze für groß angelegte KI-Inferenz, sondern legt auch den Grundstein für zukünftige regionenübergreifende Rechennetzwerke. Dieses Prefill-as-a-Service-Modell könnte zu einem wichtigen Meilenstein bei der industriellen Einführung großer Modelle werden.








 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer

Die besten und am besten bewerteten KI-Tools zur SERP-Analyse für Suchstrategien im Jahr 2026 wurden von XIX.AI anhand strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Ihnen dabei, verborgene Optimierungsmöglichkeiten aufzudecken, die Performance Ihrer Inhalte zu steigern und sich einen Wettbewerbsvorteil in der Suche zu verschaffen. Entdecken Sie noch heute das perfekte Tool, um Ihre Suchstrategie auf ein neues Niveau zu heben. Jetzt entdecken!
13 Tools
xix.ai

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔












