


 Hogar
Moonshot AI y la Universidad de Tsinghua presentan la arquitectura PrfaaS para superar el cuello de botella en la potencia de cálculo de los modelos de gran tamaño
Las nuevas tecnologías están superando el cuello de botella en el rendimiento de los modelos de lenguaje a gran escala (LLM). Recientemente, investigadores de Moonshot AI (Moonshot) y la Universidad de Tsinghua presentaron una novedosa arquitectura denominada Prefill-as-a-Service (PrfaaS). Este estudio aborda las limitaciones de hardware en las implementaciones de servicios de modelos grandes en centros de datos mediante la optimización de la asignación de recursos de computación, lo que aumenta significativamente la eficiencia de la inferencia.
Avance técnico: una separación «quirúrgica» entre el prellenado y la decodificación
Actualmente, el proceso de inferencia de los modelos de lenguaje a gran escala consta de dos fases distintas:
Fase de prellenado: esta fase requiere un uso intensivo de recursos computacionales, ya que se encarga del procesamiento de la entrada y de generar la caché de clave-valor (KVCache).
Fase de decodificación: esta fase requiere un gran ancho de banda de memoria y genera la salida palabra por palabra.
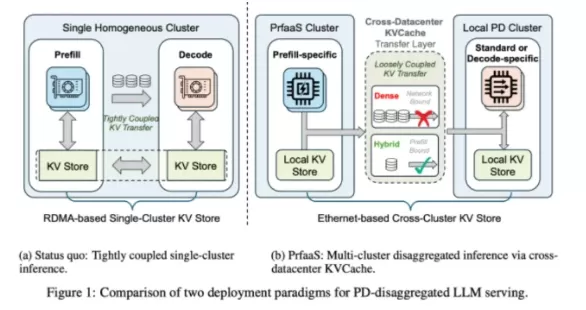
En las arquitecturas tradicionales, ambas fases suelen gestionarse dentro del mismo centro de datos o incluso del mismo servidor. Dado que tienen necesidades de recursos de hardware diferentes, esta «agrupación forzada» suele crear un desequilibrio en la asignación de recursos de computación y ancho de banda, lo que provoca la congestión del servicio.
Innovación principal: colaboración eficiente entre regiones
La característica principalde PrfaaS es lograr un servicio desacoplado. Descarga las tareas de prellenado, que requieren un uso intensivo de recursos computacionales, a clústeres especializados de alta potencia de cálculo. Una vez completada la tarea, el sistema utiliza Ethernet estándar para transferir la KVCache generada de forma remota a un clúster de decodificación local.
Este diseño elimina las limitaciones de espacio físico, lo que permite que el prellenado y la decodificación se ejecuten simultáneamente en diferentes centros de datos. Para garantizar una transferencia eficiente, PrfaaS incorpora un mecanismo de programación de dos escalas temporales que asigna recursos de forma flexible en función de las fluctuaciones del tráfico en tiempo real, junto con un enrutamiento preciso para evitar que las solicitudes de texto largo se retrasen debido a una distribución desigual de los recursos.
Resultados de las pruebas: optimización del rendimiento y la latencia
Los datos de la investigación demuestran que la arquitectura PrfaaS ofrece un rendimiento notable en aplicaciones del mundo real:
El rendimiento del servicio aumentó un 54 %, lo que mejoró significativamente el número de solicitudes gestionadas por unidad de tiempo.
La latencia de respuesta se redujo significativamente, lo que agilizó la generación del primer token desde la perspectiva del usuario.
Se maximizó la utilización de los recursos al separar los subsistemas de computación, red y almacenamiento, evitando los problemas de congestión observados en las arquitecturas tradicionales.
La colaboración entre Moonshot AI y la Universidad de Tsinghua no solo ofrece nuevos enfoques de ingeniería para la inferencia de IA a gran escala, sino que también sienta las bases para futuras redes informáticas interregionales. Este modelo de Prefill-as-a-Service podría convertirse en un hito clave para llevar los modelos de gran tamaño hacia el despliegue industrial.
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (1)
0/500
![HarryRoberts]()
Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔
Las nuevas tecnologías están superando el cuello de botella en el rendimiento de los modelos de lenguaje a gran escala (LLM). Recientemente, investigadores de Moonshot AI (Moonshot) y la Universidad de Tsinghua presentaron una novedosa arquitectura denominada Prefill-as-a-Service (PrfaaS). Este estudio aborda las limitaciones de hardware en las implementaciones de servicios de modelos grandes en centros de datos mediante la optimización de la asignación de recursos de computación, lo que aumenta significativamente la eficiencia de la inferencia.
Avance técnico: una separación «quirúrgica» entre el prellenado y la decodificación
Actualmente, el proceso de inferencia de los modelos de lenguaje a gran escala consta de dos fases distintas:
Fase de prellenado: esta fase requiere un uso intensivo de recursos computacionales, ya que se encarga del procesamiento de la entrada y de generar la caché de clave-valor (KVCache).
Fase de decodificación: esta fase requiere un gran ancho de banda de memoria y genera la salida palabra por palabra.
En las arquitecturas tradicionales, ambas fases suelen gestionarse dentro del mismo centro de datos o incluso del mismo servidor. Dado que tienen necesidades de recursos de hardware diferentes, esta «agrupación forzada» suele crear un desequilibrio en la asignación de recursos de computación y ancho de banda, lo que provoca la congestión del servicio.
Innovación principal: colaboración eficiente entre regiones
La característica principal
Este diseño elimina las limitaciones de espacio físico, lo que permite que el prellenado y la decodificación se ejecuten simultáneamente en diferentes centros de datos. Para garantizar una transferencia eficiente, PrfaaS incorpora un mecanismo de programación de dos escalas temporales que asigna recursos de forma flexible en función de las fluctuaciones del tráfico en tiempo real, junto con un enrutamiento preciso para evitar que las solicitudes de texto largo se retrasen debido a una distribución desigual de los recursos.
Resultados de las pruebas: optimización del rendimiento y la latencia
Los datos de la investigación demuestran que la arquitectura PrfaaS ofrece un rendimiento notable en aplicaciones del mundo real:
El rendimiento del servicio aumentó un 54 %, lo que mejoró significativamente el número de solicitudes gestionadas por unidad de tiempo.
La latencia de respuesta se redujo significativamente, lo que agilizó la generación del primer token desde la perspectiva del usuario.
Se maximizó la utilización de los recursos al separar los subsistemas de computación, red y almacenamiento, evitando los problemas de congestión observados en las arquitecturas tradicionales.
La colaboración entre Moonshot AI y la Universidad de Tsinghua no solo ofrece nuevos enfoques de ingeniería para la inferencia de IA a gran escala, sino que también sienta las bases para futuras redes informáticas interregionales. Este modelo de Prefill-as-a-Service podría convertirse en un hito clave para llevar los modelos de gran tamaño hacia el despliegue industrial.








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔












