


 Maison
Le PDG de Microsoft fustige les laboratoires d'IA au sujet de la « distillation »
![]()
Satya Nadella, PDG de Microsoft, accuse les laboratoires d'IA d'hypocrisie face aux critiques concernant la distillation des modèles, une remarque largement interprétée comme visant Anthropic. Crédit : Getty Images
Satya Nadella, PDG de Microsoft, reproche aux développeurs d'IA de limiter la distillation des modèles tout en exploitant simultanément les données publiques et celles de leurs clients pour entraîner leurs propres systèmes.
Satya Nadella, de Microsoft, a publiquement critiqué certains laboratoires d’IA non nommés du secteur technologique pour leur position contradictoire sur la « distillation » en IA, une technique consistant à entraîner un modèle plus petit à partir des résultats d’un système plus grand et plus puissant.
Dans un message publié sur X, Satya Nadella affirme que les créateurs de modèles qui se plaignent de la distillation font preuve d’hypocrisie quant au processus plus large d’entraînement de l’IA.
Il reconnaît que « la grande innovation qui découle du fait que les fournisseurs de modèles disposent de droits d’utilisation équitables pour entraîner leurs modèles à partir de données publiques est nécessaire », mais trouve « ironique » que le consensus du secteur impose des « conditions restrictives » à la distillation.
Et ce, alors même que ces entreprises se réservent le droit d’exploiter elles-mêmes les données d’utilisation et d’interaction de leurs clients.
« Si l’apprentissage ne va que dans un seul sens, la valeur économique converge vers les propriétaires de l’infrastructure d’apprentissage plutôt que vers les créateurs de la connaissance elle-même », note Nadella.
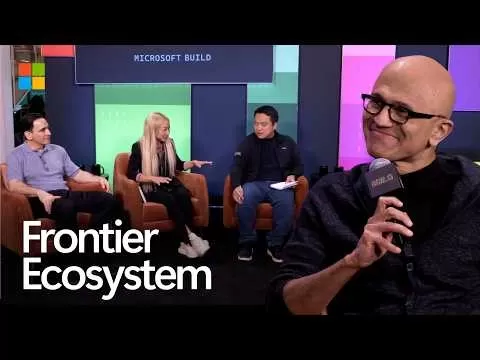
Les attaques d’Anthropic mettent en lumière un conflit croissant sur l’approvisionnement
Anthropic, OpenAI et Google DeepMind s’appuient sur des contenus tiers pour entraîner leurs modèles d’IA. ChatGPT, Claude et Gemini puisent leurs informations dans des textes, des images et des données accessibles au public.
Nombreux sont ceux qui ont soulevé des préoccupations d’ordre éthique et de droits d’auteur concernant cette méthode d’entraînement, ce qui a conduit à des poursuites judiciaires de la part de grands créateurs de contenu.
Par exemple, BBC News a rapporté que la BBC poursuivait Anthropic en justice pour utilisation de données sans consentement.
Bien que Nadella n’ait pas cité Anthropic directement, tout porte à croire que ce message visait clairement cette entreprise spécialisée dans l’IA. Sa critique fait suite à un précédent article d’Anthropic intitulé « Détecter et prévenir les attaques par distillation ».
Dans une lettre adressée en juin au sénateur de Caroline du Sud Tim Scott et à la sénatrice du Massachusetts Elizabeth Warren, Anthropic a affirmé qu’Alibaba avait récemment mené la « plus grande attaque par distillation jamais connue » contre ses données.
Dans cette déclaration, la société affirmait que des concurrents pourraient utiliser la distillation pour acquérir « des capacités puissantes provenant d’autres laboratoires en une fraction du temps et à une fraction du coût qu’il faudrait pour les développer de manière indépendante ». Alibaba n’a pas encore répondu à ces accusations.
Des entreprises telles que la BBC et Reddit ont intenté un procès à Anthropic, l’accusant d’utiliser leurs données pour entraîner son modèle Claude sans leur consentement (Crédit : Anthropic)
L’externalisation des modèles comporte des risques commerciaux majeurs
Dans ce même message publié sur X, Nadella met en garde contre le fait que les entreprises qui s'appuient sur de grands modèles d'IA accordent aux sociétés spécialisées dans l'IA l'accès à leurs données propriétaires.
Il souligne que les entreprises doivent être propriétaires de leur infrastructure d’IA et de leur expertise sectorielle plutôt que de dépendre d’un seul fournisseur de modèles.
Nadella conseille aux entreprises de mener leurs propres évaluations et de mettre en place une « boucle d’apprentissage » afin de s’assurer que leur technologie d’IA évolue et s’améliore au fil du temps.
Les entreprises ont besoin de paramètres de sécurité stricts pour protéger leurs développements propriétaires. Nadella affirme que les entreprises ont besoin d’une véritable « frontière de confiance » pour que leur capital humain et leur capital symbolique puissent fructifier.
Il ajoute que cette frontière ne doit être franchie par personne ni par rien, « pas même les données résiduelles de l'intelligence artificielle, sans consentement ».
De même, Elon Musk a publiquement critiqué les pratiques d’Anthropic en matière d’approvisionnement en données pour l’entraînement de ses modèles d’IA.
Dans un message publié en février sur X, Musk a accusé Anthropic de « voler des données d’entraînement à très grande échelle », prédisant que l’entreprise devrait faire face à des « règlements à hauteur de plusieurs milliards de dollars » pour vol.
« C'est tout simplement un fait », ajoute-t-il.
Article connexe
 Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Ollie mise sur la protection de la vie privée pour remporter la course aux assistants IA
Pour être véritablement utile, un assistant IA doit comprendre en profondeur son utilisateur. Ollie, un assistant personnel conçu pour la vie quotidienne, part du principe que cela ne nécessite pas de
Comment « AI LIVE : Londres » abordera les thèmes de l'IA et de l'automatisation industrielle
Ce sommet réunira des dirigeants de haut niveau venus du monde entier afin d'aborder les défis urgents auxquels sont confrontés les secteurs d'activité à l'échelle mondiale, allant des bouleversements
Recommandations de sujets spéciaux liés
Référencement
 Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
 13 outils
 xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

 commentaires (0)
Satya Nadella, PDG de Microsoft, accuse les laboratoires d'IA d'hypocrisie face aux critiques concernant la distillation des modèles, une remarque largement interprétée comme visant Anthropic. Crédit : Getty Images
Satya Nadella, PDG de Microsoft, reproche aux développeurs d'IA de limiter la distillation des modèles tout en exploitant simultanément les données publiques et celles de leurs clients pour entraîner leurs propres systèmes.
Satya Nadella, de Microsoft, a publiquement critiqué certains laboratoires d’IA non nommés du secteur technologique pour leur position contradictoire sur la « distillation » en IA, une technique consistant à entraîner un modèle plus petit à partir des résultats d’un système plus grand et plus puissant.
Dans un message publié sur X, Satya Nadella affirme que les créateurs de modèles qui se plaignent de la distillation font preuve d’hypocrisie quant au processus plus large d’entraînement de l’IA.
Il reconnaît que « la grande innovation qui découle du fait que les fournisseurs de modèles disposent de droits d’utilisation équitables pour entraîner leurs modèles à partir de données publiques est nécessaire », mais trouve « ironique » que le consensus du secteur impose des « conditions restrictives » à la distillation.
Et ce, alors même que ces entreprises se réservent le droit d’exploiter elles-mêmes les données d’utilisation et d’interaction de leurs clients.
« Si l’apprentissage ne va que dans un seul sens, la valeur économique converge vers les propriétaires de l’infrastructure d’apprentissage plutôt que vers les créateurs de la connaissance elle-même », note Nadella.
Les attaques d’Anthropic mettent en lumière un conflit croissant sur l’approvisionnement
Anthropic, OpenAI et Google DeepMind s’appuient sur des contenus tiers pour entraîner leurs modèles d’IA. ChatGPT, Claude et Gemini puisent leurs informations dans des textes, des images et des données accessibles au public.
Nombreux sont ceux qui ont soulevé des préoccupations d’ordre éthique et de droits d’auteur concernant cette méthode d’entraînement, ce qui a conduit à des poursuites judiciaires de la part de grands créateurs de contenu.
Par exemple, BBC News a rapporté que la BBC poursuivait Anthropic en justice pour utilisation de données sans consentement.
Bien que Nadella n’ait pas cité Anthropic directement, tout porte à croire que ce message visait clairement cette entreprise spécialisée dans l’IA. Sa critique fait suite à un précédent article d’Anthropic intitulé « Détecter et prévenir les attaques par distillation ».
Dans une lettre adressée en juin au sénateur de Caroline du Sud Tim Scott et à la sénatrice du Massachusetts Elizabeth Warren, Anthropic a affirmé qu’Alibaba avait récemment mené la « plus grande attaque par distillation jamais connue » contre ses données.
Dans cette déclaration, la société affirmait que des concurrents pourraient utiliser la distillation pour acquérir « des capacités puissantes provenant d’autres laboratoires en une fraction du temps et à une fraction du coût qu’il faudrait pour les développer de manière indépendante ». Alibaba n’a pas encore répondu à ces accusations.
Des entreprises telles que la BBC et Reddit ont intenté un procès à Anthropic, l’accusant d’utiliser leurs données pour entraîner son modèle Claude sans leur consentement (Crédit : Anthropic)
L’externalisation des modèles comporte des risques commerciaux majeurs
Dans ce même message publié sur X, Nadella met en garde contre le fait que les entreprises qui s'appuient sur de grands modèles d'IA accordent aux sociétés spécialisées dans l'IA l'accès à leurs données propriétaires.
Il souligne que les entreprises doivent être propriétaires de leur infrastructure d’IA et de leur expertise sectorielle plutôt que de dépendre d’un seul fournisseur de modèles.
Nadella conseille aux entreprises de mener leurs propres évaluations et de mettre en place une « boucle d’apprentissage » afin de s’assurer que leur technologie d’IA évolue et s’améliore au fil du temps.
Les entreprises ont besoin de paramètres de sécurité stricts pour protéger leurs développements propriétaires. Nadella affirme que les entreprises ont besoin d’une véritable « frontière de confiance » pour que leur capital humain et leur capital symbolique puissent fructifier.
Il ajoute que cette frontière ne doit être franchie par personne ni par rien, « pas même les données résiduelles de l'intelligence artificielle, sans consentement ».
De même, Elon Musk a publiquement critiqué les pratiques d’Anthropic en matière d’approvisionnement en données pour l’entraînement de ses modèles d’IA.
Dans un message publié en février sur X, Musk a accusé Anthropic de « voler des données d’entraînement à très grande échelle », prédisant que l’entreprise devrait faire face à des « règlements à hauteur de plusieurs milliards de dollars » pour vol.
« C'est tout simplement un fait », ajoute-t-il.







 Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
 Ollie mise sur la protection de la vie privée pour remporter la course aux assistants IA
Pour être véritablement utile, un assistant IA doit comprendre en profondeur son utilisateur. Ollie, un assistant personnel conçu pour la vie quotidienne, part du principe que cela ne nécessite pas de
 Comment « AI LIVE : Londres » abordera les thèmes de l'IA et de l'automatisation industrielle
Ce sommet réunira des dirigeants de haut niveau venus du monde entier afin d'aborder les défis urgents auxquels sont confrontés les secteurs d'activité à l'échelle mondiale, allant des bouleversements

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai












