


 Maison
Quelle est la différence entre association et causalité dans l'analyse statistique ?
Comprendre les relations entre les variables est essentiel dans l'analyse des données. Si les statistiques nous aident à prévoir les résultats, il est essentiel de faire la distinction entre simple association et véritable causalité. Une relation entre deux variables n'implique pas que l'une soit la cause de l'autre. Ce guide explore ces concepts fondamentaux et vous apprend à définir les populations, les échantillons et les paramètres, vous permettant ainsi de prendre des décisions plus fiables et fondées sur des données.
Points clés
Apprenez à faire la différence entre corrélation statistique et causalité.
Définissez la population cible, l'échantillon prélevé et les paramètres clés dans toute étude.
Explorez différentes méthodes d'échantillonnage et évaluez dans quelle mesure elles représentent une population.
Identifiez l'utilité et les limites de l'échantillonnage par commodité et de l'échantillonnage systématique.
Appliquez ces principes statistiques pour améliorer votre interprétation des données et votre prise de décision.
Association ou causalité : dévoiler la vérité statistique
La différence fondamentale : association et causalité
Dans l'analyse des données, l'objectif est souvent de prédire des événements futurs à partir de modèles observés. Parfois, l'objectif est simplement de déterminer si une variable est associée à une autre.
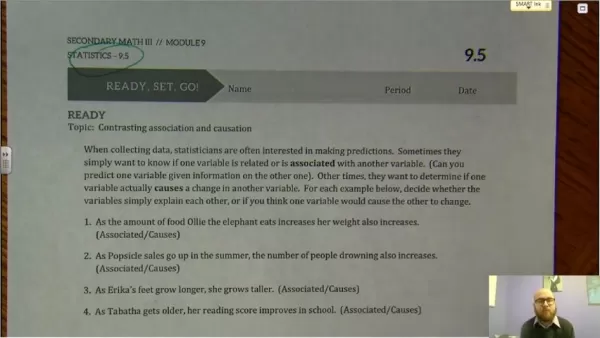
Une association indique un lien prévisible ; connaître la valeur d'une variable vous aide à estimer l'autre. Par exemple, les ventes de crème glacée et les taux de criminalité ont tendance à augmenter pendant les mois d'été. Ils sont corrélés.
Cependant, il serait erroné de supposer qu'il s'agit d'une causalité. La causalité signifie qu'un changement dans une variable déclenche directement un changement dans une autre. Prouver la causalité est beaucoup plus difficile et nécessite des tests rigoureux pour éliminer d'autres facteurs d'influence. L'augmentation des ventes de crème glacée ne cause pas une augmentation de la criminalité ; une troisième variable, comme le temps chaud, influence ces deux tendances.
Il est essentiel de comprendre cette distinction pour prendre des décisions éclairées. Confondre corrélation et causalité peut conduire à des politiques inefficaces et à des conclusions erronées. Une analyse statistique solide vise à clarifier ces relations, en séparant la simple coïncidence de la véritable cause et effet.
Exemples illustrant ces concepts
Examinons ces exemples pratiques pour clarifier la différence entre association et causalité.
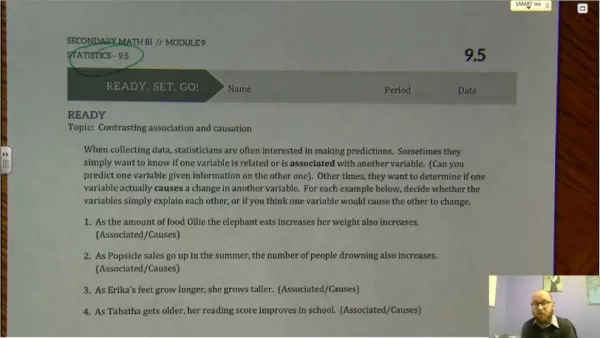
- Ollie l'éléphant : plus Ollie l'éléphant mange, plus son poids augmente. S'agit-il d'une association ou d'une causalité ? Ici, la quantité de nourriture entraîne directement une variation du poids d'Ollie. Il s'agit d'une relation de causalité évidente.
- Ventes de glaces et noyades : les ventes de glaces augmentent en été, tout comme le nombre de noyades. S'agit-il d'une association ou d'une causalité ? Bien que ces variables soient liées, la vente de glaces n'est pas la cause des noyades. Un troisième facteur, à savoir la chaleur estivale et l'augmentation de la fréquentation des piscines, influence les deux. Il s'agit d'une association.
- Les pieds et la taille d'Erika : à mesure que les pieds d'Erika s'allongent, elle grandit. S'agit-il d'une association ou d'une causalité ? La croissance de ses pieds et sa taille sont liées, car Erika connaît un développement physique global, ce qui montre une corrélation. On pourrait arguer d'un lien de causalité, car les cartilages de croissance des pieds et des os longs contribuent à une croissance simultanée.
- La lecture et l'âge de Tabatha : à mesure que Tabatha grandit, ses résultats en lecture à l'école s'améliorent. S'agit-il d'une association ou d'une causalité ? Avec l'âge, Tabatha acquiert davantage de connaissances scolaires et d'expérience, ce qui entraîne directement le développement de ses capacités en lecture. Nous pouvons raisonnablement attribuer cette amélioration à son éducation.
Foire aux questions
Quelle est l'erreur la plus courante dans l'analyse statistique ?
L'erreur la plus fréquente consiste à confondre corrélation et causalité. Le fait d'observer que deux variables changent ensemble ne prouve pas que l'une est la cause de l'autre ; d'autres facteurs cachés peuvent entrer en jeu.
Comment puis-je améliorer la représentativité de mon échantillon ?
Utilisez des techniques d'échantillonnage aléatoire telles que l'échantillonnage aléatoire simple, systématique ou stratifié. Veillez également à ce que la taille de votre échantillon soit suffisamment grande pour refléter la diversité de la population que vous étudiez.
Pourquoi est-il important de définir précisément la population ?
Définir précisément votre population cible garantit que votre échantillonnage est ciblé et permet de collecter des données pertinentes. Par exemple, si vous souhaitez obtenir des informations sur le grand public mais que vous n'interrogez que des étudiants, vos résultats seront biaisés et non représentatifs.
Questions connexes
Quelles sont les considérations éthiques à prendre en compte dans l'échantillonnage et l'analyse des données statistiques ?
L'éthique est fondamentale pour un travail statistique responsable, car elle garantit que la collecte et l'interprétation des données évitent tout préjudice, biais et fausse représentation. La protection de la vie privée des participants est primordiale. Cela implique d'obtenir leur consentement éclairé, d'expliquer clairement l'utilisation des données et de leur accorder le droit de se retirer. L'anonymisation des données et la mise en œuvre de protocoles de sécurité rigoureux sont essentielles, en particulier pour les informations sensibles. La lutte contre les biais est une autre tâche essentielle. Les chercheurs doivent identifier et atténuer de manière proactive les biais à chaque étape, de la collecte des données à leur interprétation, et reconnaître ouvertement les limites de l'étude et les variables confusionnelles. La transparence et l'honnêteté dans la communication des résultats sont non négociables. Les résultats doivent être présentés de manière précise et complète, même lorsqu'ils contredisent les hypothèses initiales, en évitant toute communication sélective ou manipulation susceptible d'induire en erreur. Les données doivent être utilisées de manière responsable dans l'intérêt de la société, et non pour permettre la discrimination ou causer du tort. Cela nécessite de prendre en compte l'impact d'une étude sur différents groupes et de plaider en faveur de politiques équitables. Les chercheurs doivent être responsables de leur travail, respecter les normes professionnelles et accepter l'évaluation par les pairs. Enfin, la divulgation et la gestion des conflits d'intérêts sont essentielles pour maintenir l'objectivité et la confiance du public. En respectant ces normes éthiques, l'analyse statistique devient un outil fiable pour le progrès qui respecte les droits individuels et le bien-être de la communauté.
Article connexe
 Musk envisageait de laisser OpenAI à ses enfants alors qu'Altman témoigne
Ce matin, le PDG d’OpenAI, Sam Altman, a pris la parole pour répondre au procès intenté par l’ancien cofondateur Elon Musk, qui conteste la structure corporative de l’entreprise.Interrogé sur l’allégation de Musk selon laquelle d’autres fondateurs «
Sam Altman suscite un débat sur le ralentissement de l'IA
Écouter surApple PodcastsÉcouter surSpotifyLe PDG d'OpenAI, Sam Altman, a récemment suggéré qu'il était peut-être temps de « rythmer le rythme du développement de l'IA » afin de permettre à la société de « se renforcer autour de certains de ces nouv
Anthropic ouvre les portes à l’agence européenne de cybersécurité alors que le modèle Mythos5 est soumis à un examen de conformité
Les réglementations en matière de conformité de l’intelligence artificielle progressent de manière significative. L’entreprise leader dans le domaine de l’IA, Anthropic, a officiellement accordé à l’autorité européenne de cybersécurité l’accès à son
Recommandations de sujets spéciaux liés
Entreprise
 Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
 9 outils
 xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai
code
Outils d'analyse des pull requests basés sur l'IA pour les équipes GitHub chargées de la refactorisation, de la correction des bogues et de la résolution des failles de sécurité
Les meilleurs outils 2026 d’analyse des pull requests par IA pour les équipes GitHub sont disponibles sur XIX.AI ! Cette sélection triée sur le volet présente des solutions puissantes et révolutionnaires qui optimisent la refactorisation, la correction des bugs et la détection des failles de sécurité dans tous les workflows d’équipe. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements détaillés pour vous aider à trouver l'outil idéal qui boostera considérablement votre productivité. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
12 outils
xix.ai
Synthèse vocale
Les meilleurs outils d'IA de synthèse vocale pour des voix off naturelles
Les meilleurs outils d'IA de synthèse vocale de 2026, les mieux notés pour des voix off naturelles, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des solutions puissantes et révolutionnaires qui offrent des voix d'une clarté cristalline pour tous les cas d'utilisation, étayées par des tests en conditions réelles et des classements mis à jour chaque semaine. Consultez notre comparatif entre les versions gratuites et payantes pour trouver la solution incontournable qui boostera instantanément votre productivité. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

 commentaires (1)
![MarkMartínez]()
這篇文章講得真清楚!以前總是把相關性和因果關係搞混,現在終於明白為什麼統計顯著不等於實際影響了。不過在實際應用中,要證明因果關係真的好難啊,尤其是社會科學研究🧐
Comprendre les relations entre les variables est essentiel dans l'analyse des données. Si les statistiques nous aident à prévoir les résultats, il est essentiel de faire la distinction entre simple association et véritable causalité. Une relation entre deux variables n'implique pas que l'une soit la cause de l'autre. Ce guide explore ces concepts fondamentaux et vous apprend à définir les populations, les échantillons et les paramètres, vous permettant ainsi de prendre des décisions plus fiables et fondées sur des données.
Points clés
Apprenez à faire la différence entre corrélation statistique et causalité.
Définissez la population cible, l'échantillon prélevé et les paramètres clés dans toute étude.
Explorez différentes méthodes d'échantillonnage et évaluez dans quelle mesure elles représentent une population.
Identifiez l'utilité et les limites de l'échantillonnage par commodité et de l'échantillonnage systématique.
Appliquez ces principes statistiques pour améliorer votre interprétation des données et votre prise de décision.
Association ou causalité : dévoiler la vérité statistique
La différence fondamentale : association et causalité
Dans l'analyse des données, l'objectif est souvent de prédire des événements futurs à partir de modèles observés. Parfois, l'objectif est simplement de déterminer si une variable est associée à une autre.
Une association indique un lien prévisible ; connaître la valeur d'une variable vous aide à estimer l'autre. Par exemple, les ventes de crème glacée et les taux de criminalité ont tendance à augmenter pendant les mois d'été. Ils sont corrélés.
Cependant, il serait erroné de supposer qu'il s'agit d'une causalité. La causalité signifie qu'un changement dans une variable déclenche directement un changement dans une autre. Prouver la causalité est beaucoup plus difficile et nécessite des tests rigoureux pour éliminer d'autres facteurs d'influence. L'augmentation des ventes de crème glacée ne cause pas une augmentation de la criminalité ; une troisième variable, comme le temps chaud, influence ces deux tendances.
Il est essentiel de comprendre cette distinction pour prendre des décisions éclairées. Confondre corrélation et causalité peut conduire à des politiques inefficaces et à des conclusions erronées. Une analyse statistique solide vise à clarifier ces relations, en séparant la simple coïncidence de la véritable cause et effet.
Exemples illustrant ces concepts
Examinons ces exemples pratiques pour clarifier la différence entre association et causalité.
- Ollie l'éléphant : plus Ollie l'éléphant mange, plus son poids augmente. S'agit-il d'une association ou d'une causalité ? Ici, la quantité de nourriture entraîne directement une variation du poids d'Ollie. Il s'agit d'une relation de causalité évidente.
- Ventes de glaces et noyades : les ventes de glaces augmentent en été, tout comme le nombre de noyades. S'agit-il d'une association ou d'une causalité ? Bien que ces variables soient liées, la vente de glaces n'est pas la cause des noyades. Un troisième facteur, à savoir la chaleur estivale et l'augmentation de la fréquentation des piscines, influence les deux. Il s'agit d'une association.
- Les pieds et la taille d'Erika : à mesure que les pieds d'Erika s'allongent, elle grandit. S'agit-il d'une association ou d'une causalité ? La croissance de ses pieds et sa taille sont liées, car Erika connaît un développement physique global, ce qui montre une corrélation. On pourrait arguer d'un lien de causalité, car les cartilages de croissance des pieds et des os longs contribuent à une croissance simultanée.
- La lecture et l'âge de Tabatha : à mesure que Tabatha grandit, ses résultats en lecture à l'école s'améliorent. S'agit-il d'une association ou d'une causalité ? Avec l'âge, Tabatha acquiert davantage de connaissances scolaires et d'expérience, ce qui entraîne directement le développement de ses capacités en lecture. Nous pouvons raisonnablement attribuer cette amélioration à son éducation.
Foire aux questions
Quelle est l'erreur la plus courante dans l'analyse statistique ?
L'erreur la plus fréquente consiste à confondre corrélation et causalité. Le fait d'observer que deux variables changent ensemble ne prouve pas que l'une est la cause de l'autre ; d'autres facteurs cachés peuvent entrer en jeu.
Comment puis-je améliorer la représentativité de mon échantillon ?
Utilisez des techniques d'échantillonnage aléatoire telles que l'échantillonnage aléatoire simple, systématique ou stratifié. Veillez également à ce que la taille de votre échantillon soit suffisamment grande pour refléter la diversité de la population que vous étudiez.
Pourquoi est-il important de définir précisément la population ?
Définir précisément votre population cible garantit que votre échantillonnage est ciblé et permet de collecter des données pertinentes. Par exemple, si vous souhaitez obtenir des informations sur le grand public mais que vous n'interrogez que des étudiants, vos résultats seront biaisés et non représentatifs.
Questions connexes
Quelles sont les considérations éthiques à prendre en compte dans l'échantillonnage et l'analyse des données statistiques ?
L'éthique est fondamentale pour un travail statistique responsable, car elle garantit que la collecte et l'interprétation des données évitent tout préjudice, biais et fausse représentation. La protection de la vie privée des participants est primordiale. Cela implique d'obtenir leur consentement éclairé, d'expliquer clairement l'utilisation des données et de leur accorder le droit de se retirer. L'anonymisation des données et la mise en œuvre de protocoles de sécurité rigoureux sont essentielles, en particulier pour les informations sensibles. La lutte contre les biais est une autre tâche essentielle. Les chercheurs doivent identifier et atténuer de manière proactive les biais à chaque étape, de la collecte des données à leur interprétation, et reconnaître ouvertement les limites de l'étude et les variables confusionnelles. La transparence et l'honnêteté dans la communication des résultats sont non négociables. Les résultats doivent être présentés de manière précise et complète, même lorsqu'ils contredisent les hypothèses initiales, en évitant toute communication sélective ou manipulation susceptible d'induire en erreur. Les données doivent être utilisées de manière responsable dans l'intérêt de la société, et non pour permettre la discrimination ou causer du tort. Cela nécessite de prendre en compte l'impact d'une étude sur différents groupes et de plaider en faveur de politiques équitables. Les chercheurs doivent être responsables de leur travail, respecter les normes professionnelles et accepter l'évaluation par les pairs. Enfin, la divulgation et la gestion des conflits d'intérêts sont essentielles pour maintenir l'objectivité et la confiance du public. En respectant ces normes éthiques, l'analyse statistique devient un outil fiable pour le progrès qui respecte les droits individuels et le bien-être de la communauté.








 Musk envisageait de laisser OpenAI à ses enfants alors qu'Altman témoigne
Ce matin, le PDG d’OpenAI, Sam Altman, a pris la parole pour répondre au procès intenté par l’ancien cofondateur Elon Musk, qui conteste la structure corporative de l’entreprise.Interrogé sur l’allégation de Musk selon laquelle d’autres fondateurs «
 Sam Altman suscite un débat sur le ralentissement de l'IA
Écouter surApple PodcastsÉcouter surSpotifyLe PDG d'OpenAI, Sam Altman, a récemment suggéré qu'il était peut-être temps de « rythmer le rythme du développement de l'IA » afin de permettre à la société de « se renforcer autour de certains de ces nouv
 Anthropic ouvre les portes à l’agence européenne de cybersécurité alors que le modèle Mythos5 est soumis à un examen de conformité
Les réglementations en matière de conformité de l’intelligence artificielle progressent de manière significative. L’entreprise leader dans le domaine de l’IA, Anthropic, a officiellement accordé à l’autorité européenne de cybersécurité l’accès à son

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

Les meilleurs outils 2026 d’analyse des pull requests par IA pour les équipes GitHub sont disponibles sur XIX.AI ! Cette sélection triée sur le volet présente des solutions puissantes et révolutionnaires qui optimisent la refactorisation, la correction des bugs et la détection des failles de sécurité dans tous les workflows d’équipe. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements détaillés pour vous aider à trouver l'outil idéal qui boostera considérablement votre productivité. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
12 outils
xix.ai

Les meilleurs outils d'IA de synthèse vocale de 2026, les mieux notés pour des voix off naturelles, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des solutions puissantes et révolutionnaires qui offrent des voix d'une clarté cristalline pour tous les cas d'utilisation, étayées par des tests en conditions réelles et des classements mis à jour chaque semaine. Consultez notre comparatif entre les versions gratuites et payantes pour trouver la solution incontournable qui boostera instantanément votre productivité. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

這篇文章講得真清楚!以前總是把相關性和因果關係搞混,現在終於明白為什麼統計顯著不等於實際影響了。不過在實際應用中,要證明因果關係真的好難啊,尤其是社會科學研究🧐












