

 Maison
Sortie de la version préliminaire du modèle LFM2.5 DSpark : vitesse d'inférence multipliée par 3,18
Liquid AI et Hugging Face ont officiellement publié les points de contrôle préliminaires du modèle DSpark pour la série LFM2.5, qui comprend les modèles LFM2.5-1.2B-Instruct, LFM2.5-2.6B et LFM2.5-8B-A1B. Cette innovation introduit une nouvelle voie de décodage spéculatif qui augmente considérablement le débit d’inférence tout en préservant la qualité des résultats.
Gains de performances clés et applications concrètes
Des tests en conditions réelles démontrent l’impressionnante accélération offerte par DSpark. Sur les GPU, le débit est multiplié par 3,18, tandis que les appareils en périphérie enregistrent des améliorations pouvant atteindre un facteur de 2,87.
Dans le cadre de l’inférence des agents en périphérie, LFM2.5-2.6B réduit la latence des appels de fonction de 57 % en moyenne. Testé sur un MacBook Pro M4 Max, il atteint des vitesses allant jusqu’à 139 tokens par seconde, abaissant ainsi la barrière au déploiement d’agents locaux et offrant une expérience utilisateur qui rivalise avec celle des modèles cloud propriétaires.
Comprendre l’architecture et le mécanisme de DSpark
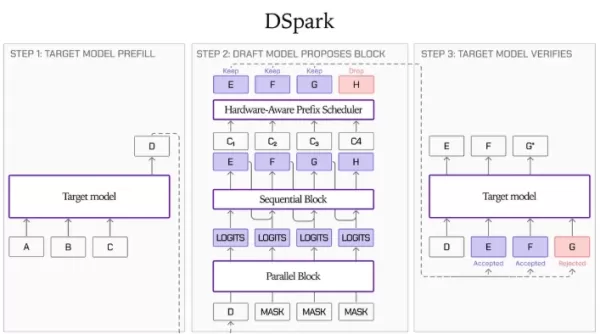
L’inférence LLM traditionnelle est freinée par la bande passante mémoire, car la majeure partie du temps est consacrée au transfert des poids de la DRAM vers la SRAM. Le décodage spéculatif résout ce problème en utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés en un seul passage avant par le modèle cible, ce qui répartit efficacement les coûts de chargement des poids.
DSpark intègre les méthodes existantes à travers trois composants principaux :
Réseau dorsal parallèle: à l’instar de DFlash, il génère des états cachés pour tous les tokens provisoires en un seul passage avant, en fonction des caractéristiques contextuelles du modèle cible.Tête séquentielle (tête de Markov): En simulant des chaînes de Markov entre des tokens adjacents, elle renforce les dépendances et améliore le taux d’acceptation pour les positions suivantes.Validateur de planification par confiance: il prédit la probabilité de survie de chaque token, en écartant automatiquement les suffixes à faible confiance lorsque les coûts de validation dépassent les économies réalisées.Pour l’entraînement, le modèle de base utilise un ensemble de données varié comprenant des SFT, des conversations, du code et des appels de fonction. Après des études d’ablation rigoureuses, la version initiale présente une architecture basée uniquement sur l’attention, composée de 5 couches et 9 blocs, avec environ 300 millions de paramètres.
Assurance qualité et intégration dans l’écosystème
En raison du décodage spéculatif, le décodage glouton n’accepte que les tokens provisoires qui correspondent parfaitement à la distribution du modèle cible. Les tokens rejetés sont remplacés par la sortie du modèle cible, garantissant ainsi que la séquence générée correspond à la structure de décodage glouton de référence, sans perte de précision dans les tests de performance.
Lors de son lancement, DSpark a atteint la compatibilité avec les principaux frameworks d’inférence :
SGLang: prend en charge l’exécution sur des accélérateurs via des configurations d’intégration et de démarrage dédiées.llama.cpp: offre une prise en charge officielle de la compilation, permettant aux utilisateurs de charger les poids GGUF et les fichiers de modèle préliminaires correspondants via la ligne de commande.
Article connexe
 Comment Unitree façonne l'avenir de la robotique humanoïde
La nouvelle créature d’Unitree dotée d’une IA incarnée et d’une technologie LiDAR 4D ultra-large pour une navigation avancée dans le monde réel. Crédit : UnitreeWang Xingxing, PDG d'Unitree, vise des
Pourquoi Abnormal AI s'est associé à OpenAI pour le lancement de Daybreak
Michael Aiello, responsable des produits de cybersécurité chez OpenAI | Crédit : Michael Aiello/LinkedInAbnormal AI rejoint le programme Daybreak d’OpenAI. Selon Mike Aiello, ce partenariat permettra
L'agent IA « Elements Claw » achève le développement d'un matériau supraconducteur
Alors que l’intelligence artificielle repousse les limites de l’exploration scientifique, une étape importante vient d’être franchie. Le 3 juillet, l’Académie DAMO d’Alibaba, en partenariat avec l’Uni
Recommandations de sujets spéciaux liés
Santé et bien-être
 Les meilleurs outils d'accompagnement du sommeil basés sur l'IA pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes de vie
Les meilleurs outils de coaching du sommeil basés sur l'IA de 2026 pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour offrir des conseils précis. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, et découvrirez comment ces solutions incontournables contribuent à améliorer la qualité du sommeil, à accélérer la récupération après un décalage horaire et à adopter des habitudes plus saines. Explorez dès maintenant cette sélection pour trouver l'outil qui vous convient le mieux !
 7 outils
 xix.ai
code
Outils de débogage ChatGPT pour les erreurs Python, les journaux API et le tri des traces de pile
2026 derniers meilleurs outils de débogage ChatGPT pour les erreurs Python, les journaux API et le tri des traces de pile sont disponibles sur XIX.AI. Cette liste sélectionnée de solutions les mieux notées propose une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à trouver l'outil le plus puissant capable d'augmenter significativement votre productivité et de vous aider à résoudre plus rapidement des problèmes techniques complexes. Explorez dès maintenant pour découvrir votre solution idéale !
9 outils
xix.ai
Synthèse vocale
Outils de voix off IA pour des vidéos de démonstration de produits
Les meilleurs outils de voix off IA les plus récents et les mieux notés pour les vidéos de démonstration de produits sont disponibles sur XIX.AI en 2026 ! Cette liste soigneusement sélectionnée propose des options puissantes et révolutionnaires qui vous aident à créer rapidement du contenu audio de qualité professionnelle, améliorant considérablement l’efficacité de vos démonstrations. Nous réalisons des tests concrets et proposons une comparaison entre versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine, afin de vous aider à trouver la solution idéale. Explorez dès maintenant pour débloquer votre avantage IA !
10 outils
xix.ai
Entreprise
Outils de plan d'affaires basés sur l'IA pour la validation des start-ups
Les meilleurs outils de 2026 pour élaborer un business plan basé sur l'IA et valider votre start-up ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour fournir des résultats précis. Vous y trouverez un comparatif entre les versions gratuites et payantes, des classements détaillés et des analyses claires pour vous aider à choisir la solution idéale et à augmenter les chances de réussite de votre start-up. Découvrez-les dès maintenant pour exploiter pleinement votre avantage en matière d’IA !
9 outils
xix.ai
chatbot
Applications de chat IA pour le jeu de rôle et la pratique de la conversation
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle et la Pratique de la Conversation ! XIX.AI sélectionne une liste hautement évaluée d’outils puissants à absolument essayer, qui ont subi des tests rigoureux dans des conditions réelles pour offrir des résultats exceptionnels. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements complets, ainsi que des analyses sur la manière dont ces applications peuvent améliorer efficacement vos compétences linguistiques et votre confiance en communication. Explorez dès maintenant pour découvrir l’outil parfait adapté à vos besoins de pratique !
10 outils
xix.ai
conception
Les meilleurs outils de création de maquettes fonctionnelles basés sur l'IA pour les équipes produit
Les meilleurs outils de wireframing basés sur l'IA les mieux notés de 2026 pour les équipes produit ! Cette sélection présente des solutions puissantes et révolutionnaires qui améliorent considérablement la productivité, validées par des tests concrets et un classement rigoureux. Elle comprend une comparaison détaillée entre les versions gratuites et payantes pour vous aider à trouver celle qui vous convient le mieux. XIX.AI vous propose des conseils d'experts pour vous guider dans votre choix. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour le développement de vos produits !
8 outils
xix.ai

 commentaires (0)
Liquid AI et Hugging Face ont officiellement publié les points de contrôle préliminaires du modèle DSpark pour la série LFM2.5, qui comprend les modèles LFM2.5-1.2B-Instruct, LFM2.5-2.6B et LFM2.5-8B-A1B. Cette innovation introduit une nouvelle voie de décodage spéculatif qui augmente considérablement le débit d’inférence tout en préservant la qualité des résultats.
Gains de performances clés et applications concrètes
Des tests en conditions réelles démontrent l’impressionnante accélération offerte par DSpark. Sur les GPU, le débit est multiplié par 3,18, tandis que les appareils en périphérie enregistrent des améliorations pouvant atteindre un facteur de 2,87.
Dans le cadre de l’inférence des agents en périphérie, LFM2.5-2.6B réduit la latence des appels de fonction de 57 % en moyenne. Testé sur un MacBook Pro M4 Max, il atteint des vitesses allant jusqu’à 139 tokens par seconde, abaissant ainsi la barrière au déploiement d’agents locaux et offrant une expérience utilisateur qui rivalise avec celle des modèles cloud propriétaires.
Comprendre l’architecture et le mécanisme de DSpark
L’inférence LLM traditionnelle est freinée par la bande passante mémoire, car la majeure partie du temps est consacrée au transfert des poids de la DRAM vers la SRAM. Le décodage spéculatif résout ce problème en utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés en un seul passage avant par le modèle cible, ce qui répartit efficacement les coûts de chargement des poids.
DSpark intègre les méthodes existantes à travers trois composants principaux :
Réseau dorsal parallèle: à l’instar de DFlash, il génère des états cachés pour tous les tokens provisoires en un seul passage avant, en fonction des caractéristiques contextuelles du modèle cible.Tête séquentielle (tête de Markov): En simulant des chaînes de Markov entre des tokens adjacents, elle renforce les dépendances et améliore le taux d’acceptation pour les positions suivantes.Validateur de planification par confiance: il prédit la probabilité de survie de chaque token, en écartant automatiquement les suffixes à faible confiance lorsque les coûts de validation dépassent les économies réalisées.Pour l’entraînement, le modèle de base utilise un ensemble de données varié comprenant des SFT, des conversations, du code et des appels de fonction. Après des études d’ablation rigoureuses, la version initiale présente une architecture basée uniquement sur l’attention, composée de 5 couches et 9 blocs, avec environ 300 millions de paramètres.
Assurance qualité et intégration dans l’écosystème
En raison du décodage spéculatif, le décodage glouton n’accepte que les tokens provisoires qui correspondent parfaitement à la distribution du modèle cible. Les tokens rejetés sont remplacés par la sortie du modèle cible, garantissant ainsi que la séquence générée correspond à la structure de décodage glouton de référence, sans perte de précision dans les tests de performance.
Lors de son lancement, DSpark a atteint la compatibilité avec les principaux frameworks d’inférence :
SGLang: prend en charge l’exécution sur des accélérateurs via des configurations d’intégration et de démarrage dédiées.llama.cpp: offre une prise en charge officielle de la compilation, permettant aux utilisateurs de charger les poids GGUF et les fichiers de modèle préliminaires correspondants via la ligne de commande.


 Comment Unitree façonne l'avenir de la robotique humanoïde
La nouvelle créature d’Unitree dotée d’une IA incarnée et d’une technologie LiDAR 4D ultra-large pour une navigation avancée dans le monde réel. Crédit : UnitreeWang Xingxing, PDG d'Unitree, vise des
 Pourquoi Abnormal AI s'est associé à OpenAI pour le lancement de Daybreak
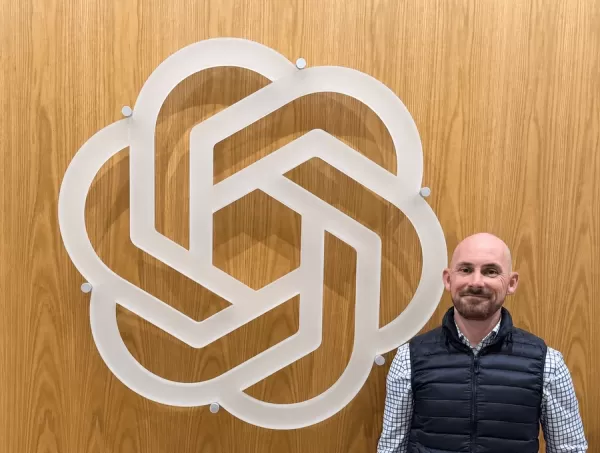
Michael Aiello, responsable des produits de cybersécurité chez OpenAI | Crédit : Michael Aiello/LinkedInAbnormal AI rejoint le programme Daybreak d’OpenAI. Selon Mike Aiello, ce partenariat permettra
 L'agent IA « Elements Claw » achève le développement d'un matériau supraconducteur
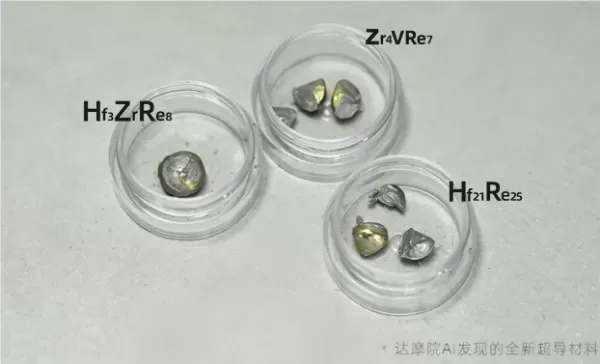
Alors que l’intelligence artificielle repousse les limites de l’exploration scientifique, une étape importante vient d’être franchie. Le 3 juillet, l’Académie DAMO d’Alibaba, en partenariat avec l’Uni

Les meilleurs outils de coaching du sommeil basés sur l'IA de 2026 pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour offrir des conseils précis. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, et découvrirez comment ces solutions incontournables contribuent à améliorer la qualité du sommeil, à accélérer la récupération après un décalage horaire et à adopter des habitudes plus saines. Explorez dès maintenant cette sélection pour trouver l'outil qui vous convient le mieux !
7 outils
xix.ai
2026 derniers meilleurs outils de débogage ChatGPT pour les erreurs Python, les journaux API et le tri des traces de pile sont disponibles sur XIX.AI. Cette liste sélectionnée de solutions les mieux notées propose une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à trouver l'outil le plus puissant capable d'augmenter significativement votre productivité et de vous aider à résoudre plus rapidement des problèmes techniques complexes. Explorez dès maintenant pour découvrir votre solution idéale !
9 outils
xix.ai
Les meilleurs outils de voix off IA les plus récents et les mieux notés pour les vidéos de démonstration de produits sont disponibles sur XIX.AI en 2026 ! Cette liste soigneusement sélectionnée propose des options puissantes et révolutionnaires qui vous aident à créer rapidement du contenu audio de qualité professionnelle, améliorant considérablement l’efficacité de vos démonstrations. Nous réalisons des tests concrets et proposons une comparaison entre versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine, afin de vous aider à trouver la solution idéale. Explorez dès maintenant pour débloquer votre avantage IA !
10 outils
xix.ai

Les meilleurs outils de 2026 pour élaborer un business plan basé sur l'IA et valider votre start-up ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour fournir des résultats précis. Vous y trouverez un comparatif entre les versions gratuites et payantes, des classements détaillés et des analyses claires pour vous aider à choisir la solution idéale et à augmenter les chances de réussite de votre start-up. Découvrez-les dès maintenant pour exploiter pleinement votre avantage en matière d’IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle et la Pratique de la Conversation ! XIX.AI sélectionne une liste hautement évaluée d’outils puissants à absolument essayer, qui ont subi des tests rigoureux dans des conditions réelles pour offrir des résultats exceptionnels. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements complets, ainsi que des analyses sur la manière dont ces applications peuvent améliorer efficacement vos compétences linguistiques et votre confiance en communication. Explorez dès maintenant pour découvrir l’outil parfait adapté à vos besoins de pratique !
10 outils
xix.ai

Les meilleurs outils de wireframing basés sur l'IA les mieux notés de 2026 pour les équipes produit ! Cette sélection présente des solutions puissantes et révolutionnaires qui améliorent considérablement la productivité, validées par des tests concrets et un classement rigoureux. Elle comprend une comparaison détaillée entre les versions gratuites et payantes pour vous aider à trouver celle qui vous convient le mieux. XIX.AI vous propose des conseils d'experts pour vous guider dans votre choix. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour le développement de vos produits !
8 outils
xix.ai












