

 Heim
LFM2.5 DSpark-Entwurf veröffentlicht: 3,18-fache Steigerung der Inferenzgeschwindigkeit
Liquid AI und Hugging Face haben offiziell die DSpark-Entwurf-Modell-Checkpoints für die LFM2.5-Serie veröffentlicht, darunter LFM2.5-1.2B-Instruct, LFM2.5-2.6B und LFM2.5-8B-A1B. Diese Innovation führt einen neuartigen spekulativen Dekodierungspfad ein, der den Inferenzdurchsatz erheblich steigert und gleichzeitig die Ausgabequalität gewährleistet.
Wichtige Leistungssteigerungen und praktische Anwendungen
Praxistests belegen die beeindruckende Beschleunigung durch DSpark. Auf GPUs steigt der Durchsatz um das bis zu 3,18-Fache, während Edge-Geräte Verbesserungen von bis zu 2,87-fach verzeichnen.
Bei der Inferenz auf Edge-Agenten reduziert LFM2.5-2.6B die Latenz bei Funktionsaufrufen um durchschnittlich 57 %. Getestet auf einem MacBook Pro M4 Max erreicht es Geschwindigkeiten von bis zu 139 Token pro Sekunde, was die Hürde für den Einsatz lokaler Agenten senkt und ein Nutzererlebnis bietet, das mit proprietären Cloud-Modellen mithalten kann.
Die Architektur und Funktionsweise von DSpark verstehen
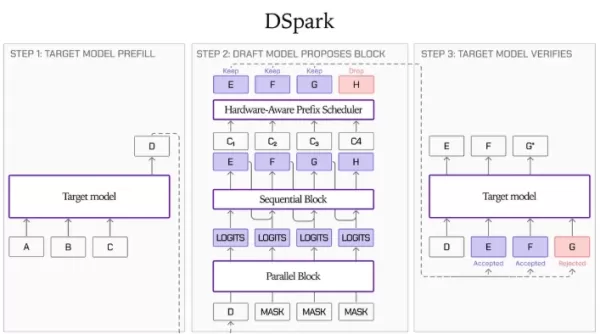
Die herkömmliche LLM-Inferenz wird durch die Speicherbandbreite gebremst, da der größte Teil der Zeit für das Streamen von Gewichten vom DRAM in den SRAM aufgewendet wird. Spekulatives Decodieren löst dieses Problem durch die Verwendung eines leichtgewichtigen Entwurfsmodells zur Generierung von Token-Kandidaten, die anschließend in einem einzigen Vorwärtsdurchlauf durch das Zielmodell validiert werden, wodurch die Kosten für das Laden der Gewichte effektiv verteilt werden.
DSpark integriert bestehende Methoden über drei Kernkomponenten:
Paralleles Backbone-Netzwerk: Ähnlich wie bei DFlash generiert es in einem Vorwärtsdurchlauf versteckte Zustände für alle Entwurfstoken auf der Grundlage der Kontextmerkmale des Zielmodells.Sequentieller Kopf (Markov-Kopf): Durch die Simulation von Markov-Ketten zwischen benachbarten Tokens verstärkt er Abhängigkeiten und verbessert die Akzeptanzrate für nachfolgende Positionen.Confidence Scheduling Validator: Er prognostiziert die Überlebenswahrscheinlichkeit jedes Tokens und verwirft automatisch Suffixe mit geringer Konfidenz, wenn die Validierungskosten die Einsparungen übersteigen.Für das Training nutzt das Entwurfsmodell eine vielfältige Mischung aus Datensätzen, darunter SFT, Chat, Code und Funktionsaufrufe. Nach strengen Ablationsstudien verfügt die erste Version über eine reine Attention-Architektur mit 5 Schichten und 9 Blöcken, wobei die Anzahl der Parameter bei etwa 300 Millionen liegt.
Qualitätssicherung und Integration in das Ökosystem
Aufgrund der spekulativen Dekodierung akzeptiert die „greedy“-Dekodierung nur Entwurfs-Token, die perfekt mit der Verteilung des Zielmodells übereinstimmen. Abgelehnte Token werden durch die Ausgabe des Zielmodells ersetzt, wodurch sichergestellt wird, dass die generierte Sequenz der Basisstruktur der „greedy“-Dekodierung entspricht, ohne dass es in Benchmarks zu Genauigkeitsverlusten kommt.
Bei der Veröffentlichung erreichte DSpark Kompatibilität mit gängigen Inferenz-Frameworks:
SGLang: Unterstützt die Ausführung auf Beschleunigern über spezielle Integrations- und Startkonfigurationen.llama.cpp: Bietet offizielle Build-Unterstützung, sodass Nutzer entsprechende GGUF-Gewichte und Draft-Modelldateien über die Befehlszeile laden können.
Verwandter Artikel
 Wie Unitree die Zukunft der humanoiden Robotik gestaltet
Unitrees neue „Creature“ mit verkörperter KI und ultrabreitem 4D-LiDAR-System für fortschrittliche Navigation in der realen Welt. Bildquelle: UnitreeWang Xingxing, CEO von Unitree, strebt Durchbrüche
Warum Abnormal AI bei „Daybreak“ eine Partnerschaft mit OpenAI eingegangen ist
Michael Aiello, Produktleiter für Cybersicherheit bei OpenAI | Bildnachweis: Michael Aiello/LinkedInAbnormal AI tritt dem „Daybreak“-Programm von OpenAI bei; laut Mike Aiello wird die Partnerschaft di
AI Agent Elements Claw schließt die Entwicklung eines supraleitenden Materials ab
Da künstliche Intelligenz die Grenzen der wissenschaftlichen Forschung immer weiter verschiebt, wurde nun ein bedeutender Meilenstein erreicht. Am 3. Juli stellte die Alibaba DAMO Academy in Zusammena
Empfehlungen zu verwandten Spezialthemen
Gesundheit Wellness
 Die besten KI-basierten Schlafcoaching-Tools für Schichtarbeiter, zur Erholung nach Jetlag und für bessere Routinen
Die besten KI-Tools für Schlafcoaching im Jahr 2026: Für Schichtarbeiter, zur Bewältigung von Jetlag und für bessere Routinen! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechend sind und in der Praxis getestet wurden, um präzise Anleitungen zu liefern. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten und erfahren, wie diese unverzichtbaren Lösungen dazu beitragen, die Schlafqualität zu verbessern, die Erholung vom Jetlag zu beschleunigen und gesündere Routinen zu etablieren. Entdecken Sie jetzt das perfekte Tool für sich!
 7 Tools
 xix.ai
Code
ChatGPT-Debuggingtools für Python-Fehler, API-Protokolle und Stack-Trace-Triage
2026 Neueste Best ChatGPT-Debugging-Tools für Python-Fehler, API-Logs und Stack-Trace-Triage finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Lösungen bietet einen kostenlosen vs. kostenpflichtigen Vergleich, Praxistests und detaillierte Rankings, um Ihnen zu helfen, das leistungsfähigste Tool zu finden, das Ihre Produktivität erheblich steigern und Ihnen helfen kann, komplexe technische Probleme schneller zu lösen. Entdecken Sie jetzt Ihre perfekte Lösung!
9 Tools
xix.ai
Text-zu-Sprache
KI-Stimmtools für Produkt-Demonstrationsvideos
2026 Neueste Besten Top-bewerteten KI-Stimmtools für Produkt-Demonstration-Videos sind jetzt auf XIX.AI verfügbar! Diese kuratierte Liste bietet leistungsstarke, bahnbrechende Optionen, die Ihnen helfen, professionelles Audiocontent schnell zu erstellen und Ihre Demonstrations-Effizienz erheblich zu steigern. Wir führen praxisnahe Tests durch und bieten einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die perfekte Lösung zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
10 Tools
xix.ai
Geschäft
KI-Tools für Geschäftspläne zur Validierung von Start-ups
Die besten KI-Tools für Geschäftspläne zur Startup-Validierung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die in der Praxis getestet wurden und präzise Ergebnisse liefern. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und leicht verständliche Einblicke, die Ihnen helfen, die perfekte Lösung zu finden und die Erfolgsquote Ihres Start-ups zu steigern. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
KI-Chat-Apps für Rollenspiel und Konversationspraxis
2026 Neueste und beste KI-Chat-Apps für Rollenspiele und Konversationspraxis! XIX.AI erstellt eine hochbewertete Liste leistungsstarker, unbedingt auszuprobierender Tools, die strenge Praxistests durchlaufen, um außergewöhnliche Ergebnisse zu liefern. Sie finden detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie Einblicke darin, wie diese Apps Ihre Sprachkenntnisse und Ihr Kommunikationsvertrauen effektiv steigern können. Entdecken Sie jetzt Ihr perfektes Übungstool!
10 Tools
xix.ai
Design
Die besten KI-Tools zur Erstellung von Wireframes für Produktteams
Die besten und am besten bewerteten KI-Wireframe-Tools für Produktteams im Jahr 2026! Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität durch Praxistests und strenge Bewertungen deutlich steigern. Sie enthält einen detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden. XIX.AI liefert Experteneinblicke, die Ihnen bei Ihrer Entscheidung helfen. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie den KI-Vorteil bei der Produktentwicklung!
8 Tools
xix.ai

 Kommentare (0)
Liquid AI und Hugging Face haben offiziell die DSpark-Entwurf-Modell-Checkpoints für die LFM2.5-Serie veröffentlicht, darunter LFM2.5-1.2B-Instruct, LFM2.5-2.6B und LFM2.5-8B-A1B. Diese Innovation führt einen neuartigen spekulativen Dekodierungspfad ein, der den Inferenzdurchsatz erheblich steigert und gleichzeitig die Ausgabequalität gewährleistet.
Wichtige Leistungssteigerungen und praktische Anwendungen
Praxistests belegen die beeindruckende Beschleunigung durch DSpark. Auf GPUs steigt der Durchsatz um das bis zu 3,18-Fache, während Edge-Geräte Verbesserungen von bis zu 2,87-fach verzeichnen.
Bei der Inferenz auf Edge-Agenten reduziert LFM2.5-2.6B die Latenz bei Funktionsaufrufen um durchschnittlich 57 %. Getestet auf einem MacBook Pro M4 Max erreicht es Geschwindigkeiten von bis zu 139 Token pro Sekunde, was die Hürde für den Einsatz lokaler Agenten senkt und ein Nutzererlebnis bietet, das mit proprietären Cloud-Modellen mithalten kann.
Die Architektur und Funktionsweise von DSpark verstehen
Die herkömmliche LLM-Inferenz wird durch die Speicherbandbreite gebremst, da der größte Teil der Zeit für das Streamen von Gewichten vom DRAM in den SRAM aufgewendet wird. Spekulatives Decodieren löst dieses Problem durch die Verwendung eines leichtgewichtigen Entwurfsmodells zur Generierung von Token-Kandidaten, die anschließend in einem einzigen Vorwärtsdurchlauf durch das Zielmodell validiert werden, wodurch die Kosten für das Laden der Gewichte effektiv verteilt werden.
DSpark integriert bestehende Methoden über drei Kernkomponenten:
Paralleles Backbone-Netzwerk: Ähnlich wie bei DFlash generiert es in einem Vorwärtsdurchlauf versteckte Zustände für alle Entwurfstoken auf der Grundlage der Kontextmerkmale des Zielmodells.Sequentieller Kopf (Markov-Kopf): Durch die Simulation von Markov-Ketten zwischen benachbarten Tokens verstärkt er Abhängigkeiten und verbessert die Akzeptanzrate für nachfolgende Positionen.Confidence Scheduling Validator: Er prognostiziert die Überlebenswahrscheinlichkeit jedes Tokens und verwirft automatisch Suffixe mit geringer Konfidenz, wenn die Validierungskosten die Einsparungen übersteigen.Für das Training nutzt das Entwurfsmodell eine vielfältige Mischung aus Datensätzen, darunter SFT, Chat, Code und Funktionsaufrufe. Nach strengen Ablationsstudien verfügt die erste Version über eine reine Attention-Architektur mit 5 Schichten und 9 Blöcken, wobei die Anzahl der Parameter bei etwa 300 Millionen liegt.
Qualitätssicherung und Integration in das Ökosystem
Aufgrund der spekulativen Dekodierung akzeptiert die „greedy“-Dekodierung nur Entwurfs-Token, die perfekt mit der Verteilung des Zielmodells übereinstimmen. Abgelehnte Token werden durch die Ausgabe des Zielmodells ersetzt, wodurch sichergestellt wird, dass die generierte Sequenz der Basisstruktur der „greedy“-Dekodierung entspricht, ohne dass es in Benchmarks zu Genauigkeitsverlusten kommt.
Bei der Veröffentlichung erreichte DSpark Kompatibilität mit gängigen Inferenz-Frameworks:
SGLang: Unterstützt die Ausführung auf Beschleunigern über spezielle Integrations- und Startkonfigurationen.llama.cpp: Bietet offizielle Build-Unterstützung, sodass Nutzer entsprechende GGUF-Gewichte und Draft-Modelldateien über die Befehlszeile laden können.


 Wie Unitree die Zukunft der humanoiden Robotik gestaltet
Unitrees neue „Creature“ mit verkörperter KI und ultrabreitem 4D-LiDAR-System für fortschrittliche Navigation in der realen Welt. Bildquelle: UnitreeWang Xingxing, CEO von Unitree, strebt Durchbrüche
 Warum Abnormal AI bei „Daybreak“ eine Partnerschaft mit OpenAI eingegangen ist
Michael Aiello, Produktleiter für Cybersicherheit bei OpenAI | Bildnachweis: Michael Aiello/LinkedInAbnormal AI tritt dem „Daybreak“-Programm von OpenAI bei; laut Mike Aiello wird die Partnerschaft di
 AI Agent Elements Claw schließt die Entwicklung eines supraleitenden Materials ab
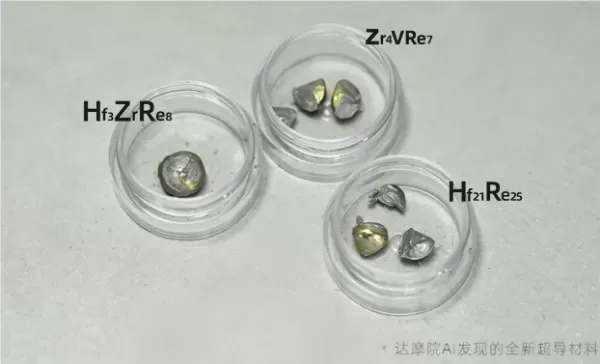
Da künstliche Intelligenz die Grenzen der wissenschaftlichen Forschung immer weiter verschiebt, wurde nun ein bedeutender Meilenstein erreicht. Am 3. Juli stellte die Alibaba DAMO Academy in Zusammena

Die besten KI-Tools für Schlafcoaching im Jahr 2026: Für Schichtarbeiter, zur Bewältigung von Jetlag und für bessere Routinen! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechend sind und in der Praxis getestet wurden, um präzise Anleitungen zu liefern. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten und erfahren, wie diese unverzichtbaren Lösungen dazu beitragen, die Schlafqualität zu verbessern, die Erholung vom Jetlag zu beschleunigen und gesündere Routinen zu etablieren. Entdecken Sie jetzt das perfekte Tool für sich!
7 Tools
xix.ai
2026 Neueste Best ChatGPT-Debugging-Tools für Python-Fehler, API-Logs und Stack-Trace-Triage finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Lösungen bietet einen kostenlosen vs. kostenpflichtigen Vergleich, Praxistests und detaillierte Rankings, um Ihnen zu helfen, das leistungsfähigste Tool zu finden, das Ihre Produktivität erheblich steigern und Ihnen helfen kann, komplexe technische Probleme schneller zu lösen. Entdecken Sie jetzt Ihre perfekte Lösung!
9 Tools
xix.ai
2026 Neueste Besten Top-bewerteten KI-Stimmtools für Produkt-Demonstration-Videos sind jetzt auf XIX.AI verfügbar! Diese kuratierte Liste bietet leistungsstarke, bahnbrechende Optionen, die Ihnen helfen, professionelles Audiocontent schnell zu erstellen und Ihre Demonstrations-Effizienz erheblich zu steigern. Wir führen praxisnahe Tests durch und bieten einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die perfekte Lösung zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
10 Tools
xix.ai

Die besten KI-Tools für Geschäftspläne zur Startup-Validierung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die in der Praxis getestet wurden und präzise Ergebnisse liefern. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und leicht verständliche Einblicke, die Ihnen helfen, die perfekte Lösung zu finden und die Erfolgsquote Ihres Start-ups zu steigern. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste und beste KI-Chat-Apps für Rollenspiele und Konversationspraxis! XIX.AI erstellt eine hochbewertete Liste leistungsstarker, unbedingt auszuprobierender Tools, die strenge Praxistests durchlaufen, um außergewöhnliche Ergebnisse zu liefern. Sie finden detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie Einblicke darin, wie diese Apps Ihre Sprachkenntnisse und Ihr Kommunikationsvertrauen effektiv steigern können. Entdecken Sie jetzt Ihr perfektes Übungstool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Wireframe-Tools für Produktteams im Jahr 2026! Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität durch Praxistests und strenge Bewertungen deutlich steigern. Sie enthält einen detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden. XIX.AI liefert Experteneinblicke, die Ihnen bei Ihrer Entscheidung helfen. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie den KI-Vorteil bei der Produktentwicklung!
8 Tools
xix.ai












