

 Maison
Groq dévoile sa technologie centrale, adopte un modèle cloud et lève 4,4 milliards de yuans pour étendre ses capacités de calcul
L’année dernière, Groq, une startup de puces IA, a licencié sa technologie d’inférence LPU propriétaire à NVIDIA pour 2 milliards de dollars, avec l’intégration de certains membres de l’équipe au sein de NVIDIA. Cette transaction a soulevé des questions quant à l’avenir de Groq, mais en l’espace de six mois, l’entreprise a répondu en pivotant vers un fournisseur de services cloud d’inférence IA, levant une nouvelle tranche de financement de 650 millions de dollars (environ 4,4 milliards de yuans).
La confiance repose sur l’« unicité »
La confiance de Groq est ancrée dans un avantage distinct : une équipe d’ingénierie mondiale disposant d’une expérience pratique des opérations LPU à grande échelle. Le LPU (Language Processing Unit), une puce d’inférence spécialisée développée par Groq, excelle dans le traitement des tâches d’inférence de grands modèles avec une latence exceptionnellement faible, gagnant la confiance des développeurs grâce à sa vitesse de génération remarquable.
Bien que la technologie ait été licenciée à NVIDIA, l’équipe et l’expertise restent intactes. Groq considère cette « mémoire musculaire » comme son avantage concurrentiel principal face aux autres fournisseurs de cloud. Actuellement, Groq exploite 13 centres de données dans quatre régions – Amérique du Nord, Europe, Moyen-Orient et Asie-Pacifique – servant plus de 5 millions de développeurs et des milliers d’entreprises natives de l’IA, avec une consommation hebdomadaire de tokens atteignant des billions.
Se concentrer sur 2027, parier sur 200 MW de puissance de calcul
Ce financement servira principalement à étendre l’infrastructure d’inférence IA. Groq prévoit de déployer les dernières technologies d’inférence et les systèmes NVIDIA LPX, visant à augmenter la capacité de calcul à 200 mégawatts d’ici la fin de 2027, soutenant ainsi des opérations d’inférence à plus grande échelle.
Passée d’une entreprise de conception de puces à un fournisseur de services cloud d’inférence IA, la transformation de Groq est plus qu’une simple restructuration commerciale. Sur un marché dominé par NVIDIA, le fait de licencier sa technologie au concurrent le plus fort tout en étendant rapidement son propre réseau de services cloud via sa plateforme, cette stratégie de « retrait pour avancer » pourrait émerger comme une nouvelle sagesse de survie pour les startups IA.
Article connexe
 Claude Opus 5.2 Gris Nuit est lancé avec une réponse plus rapide, résolvant le problème de paresse
Opus 5.2 a été lancé discrètement ce matin, incitant de nombreux développeurs à remarquer que le modèle mis à jour, Claude Opus 5.2, a entamé un déploiement limité au sein de Claude Code.Hier soir, les utilisateurs de X ont observé que l’appel d’Opu
Fireworks AI dévoile FireRouter avec Opus : réduit les coûts d’encodage de 57 % avec une baisse minimale de la précision
Fireworks AI a présenté FireRouter avec Opus, le premier système de routage conscient du cache de l’industrie, conçu spécifiquement pour la série Claude Opus. Désormais accessible via une extrémité de serveur sans serveur, ce modèle de routage indépe
NVIDIA dévoile le modèle d’intelligence audio unifié Nemotron-Labs-Audex-30B-A3B
Alors que les grands modèles multimodaux évoluent rapidement, les capacités de traitement audio sont souvent compromises : de nombreux modèles améliorent la compréhension audio au détriment de la logique textuelle. Pour remédier à cette situation, le
Recommandations de sujets spéciaux liés
chatbot
 Outils d'acheminement des conversations par chat en direct basés sur l'IA pour les files d'attente dans le commerce électronique, les acheteurs VIP et les demandes de retour
Les meilleurs outils de routage de chat en direct basés sur l'IA de 2026, les mieux notés, pour la gestion des files d'attente dans le e-commerce, les acheteurs VIP et les demandes de retour. Cette sélection présente des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité, comme l'ont démontré des tests en conditions réelles. Elle comprend un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à trouver la solution qui vous convient le mieux. XIX.AI s'impose comme un fournisseur de référence dans ce domaine. Découvrez-le dès maintenant pour exploiter pleinement votre avantage grâce à l'IA !
 9 outils
 xix.ai
en écrivant
Les meilleurs outils d'édition basés sur l'IA pour les rédacteurs non anglophones : améliorez le ton, la grammaire et la fluidité de vos textes
Les meilleurs outils de correction par IA de 2026, les mieux notés par les rédacteurs non anglophones, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests en conditions réelles afin de garantir leur précision. Vous y trouverez un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés, pour vous aider à choisir la solution incontournable qui améliorera parfaitement le style, la grammaire et la fluidité de vos textes. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Développement de logiciels
Les meilleurs outils de triage des bogues basés sur l'IA pour les équipes d'ingénierie
Les meilleurs outils de triage des bugs basés sur l'IA les mieux notés de 2026 pour les équipes d'ingénieurs ! XIX.AI a sélectionné une gamme puissante et révolutionnaire d'outils incontournables, qui ont été soumis à des tests rigoureux en conditions réelles afin de garantir une analyse précise des problèmes et une résolution efficace. Consultez un comparatif entre les versions gratuites et payantes, ainsi qu’un classement détaillé, pour vous aider à trouver la solution idéale qui améliorera considérablement la productivité de votre équipe. Découvrez-les dès maintenant pour tirer pleinement parti de l’IA !
9 outils
xix.ai
Édition d'images
Les meilleurs outils d'amélioration de portraits basés sur l'IA : optimisez l'éclairage, le teint et la netteté
Les meilleurs outils d’amélioration de portraits par IA de 2026, sélectionnés pour offrir une qualité d’image optimale. Ces outils puissants permettent d’obtenir des résultats exceptionnels en optimisant sans effort l’éclairage, le teint et la netteté, ce qui les rend parfaits pour les créateurs qui ont besoin d’améliorer rapidement leurs photos. XIX.AI propose une comparaison entre les versions gratuites et payantes, ainsi que des tests en conditions réelles et un classement mis à jour chaque semaine. Découvrez dès aujourd’hui l’outil idéal pour exploiter pleinement le potentiel de l’IA. Explorez-les dès maintenant !
7 outils
xix.ai
en écrivant
Outils de documentation technique basés sur l'IA pour les guides d'API, les notes de mise à jour et les documents d'intégration
2026 : les meilleurs outils de documentation technique basés sur l'IA, les mieux notés, pour les guides d'API, les notes de mise à jour et les documents d'intégration. Cette sélection présente des solutions puissantes et révolutionnaires qui rationalisent la création de contenu, améliorent l'efficacité de la rédaction et permettent de gagner du temps à toutes les étapes d'un projet. XIX.AI propose des classements mis à jour chaque semaine, ainsi que des comparaisons entre les versions gratuites et payantes issues de tests en conditions réelles. Découvrez dès maintenant l’outil qui vous convient le mieux et tirez pleinement parti de l’IA.
10 outils
xix.ai
conception
Outils de création de maquettes fonctionnelles pour les tableaux de bord d'IA destinés aux équipes produit B2B
Les meilleurs outils de 2026 pour la création de maquettes de tableaux de bord IA destinés aux équipes produit B2B ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont été soumis à des tests rigoureux en conditions réelles afin de garantir des résultats exceptionnels. Vous y trouverez des analyses comparatives détaillées entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine indiquant quelles options offrent le meilleur rapport qualité-prix pour rationaliser les workflows de conception de produits et booster la productivité globale. Les choix incontournables sont clairement mis en avant pour vous aider à tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
11 outils
xix.ai

 commentaires (0)
L’année dernière, Groq, une startup de puces IA, a licencié sa technologie d’inférence LPU propriétaire à NVIDIA pour 2 milliards de dollars, avec l’intégration de certains membres de l’équipe au sein de NVIDIA. Cette transaction a soulevé des questions quant à l’avenir de Groq, mais en l’espace de six mois, l’entreprise a répondu en pivotant vers un fournisseur de services cloud d’inférence IA, levant une nouvelle tranche de financement de 650 millions de dollars (environ 4,4 milliards de yuans).
La confiance repose sur l’« unicité »
La confiance de Groq est ancrée dans un avantage distinct : une équipe d’ingénierie mondiale disposant d’une expérience pratique des opérations LPU à grande échelle. Le LPU (Language Processing Unit), une puce d’inférence spécialisée développée par Groq, excelle dans le traitement des tâches d’inférence de grands modèles avec une latence exceptionnellement faible, gagnant la confiance des développeurs grâce à sa vitesse de génération remarquable.
Bien que la technologie ait été licenciée à NVIDIA, l’équipe et l’expertise restent intactes. Groq considère cette « mémoire musculaire » comme son avantage concurrentiel principal face aux autres fournisseurs de cloud. Actuellement, Groq exploite 13 centres de données dans quatre régions – Amérique du Nord, Europe, Moyen-Orient et Asie-Pacifique – servant plus de 5 millions de développeurs et des milliers d’entreprises natives de l’IA, avec une consommation hebdomadaire de tokens atteignant des billions.
Se concentrer sur 2027, parier sur 200 MW de puissance de calcul
Ce financement servira principalement à étendre l’infrastructure d’inférence IA. Groq prévoit de déployer les dernières technologies d’inférence et les systèmes NVIDIA LPX, visant à augmenter la capacité de calcul à 200 mégawatts d’ici la fin de 2027, soutenant ainsi des opérations d’inférence à plus grande échelle.
Passée d’une entreprise de conception de puces à un fournisseur de services cloud d’inférence IA, la transformation de Groq est plus qu’une simple restructuration commerciale. Sur un marché dominé par NVIDIA, le fait de licencier sa technologie au concurrent le plus fort tout en étendant rapidement son propre réseau de services cloud via sa plateforme, cette stratégie de « retrait pour avancer » pourrait émerger comme une nouvelle sagesse de survie pour les startups IA.


 Claude Opus 5.2 Gris Nuit est lancé avec une réponse plus rapide, résolvant le problème de paresse
Opus 5.2 a été lancé discrètement ce matin, incitant de nombreux développeurs à remarquer que le modèle mis à jour, Claude Opus 5.2, a entamé un déploiement limité au sein de Claude Code.Hier soir, les utilisateurs de X ont observé que l’appel d’Opu
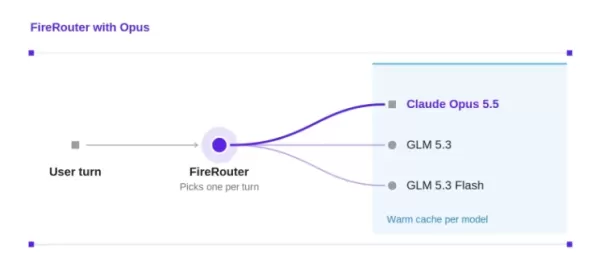 Fireworks AI dévoile FireRouter avec Opus : réduit les coûts d’encodage de 57 % avec une baisse minimale de la précision
Fireworks AI a présenté FireRouter avec Opus, le premier système de routage conscient du cache de l’industrie, conçu spécifiquement pour la série Claude Opus. Désormais accessible via une extrémité de serveur sans serveur, ce modèle de routage indépe
 NVIDIA dévoile le modèle d’intelligence audio unifié Nemotron-Labs-Audex-30B-A3B
Alors que les grands modèles multimodaux évoluent rapidement, les capacités de traitement audio sont souvent compromises : de nombreux modèles améliorent la compréhension audio au détriment de la logique textuelle. Pour remédier à cette situation, le
Les meilleurs outils de routage de chat en direct basés sur l'IA de 2026, les mieux notés, pour la gestion des files d'attente dans le e-commerce, les acheteurs VIP et les demandes de retour. Cette sélection présente des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité, comme l'ont démontré des tests en conditions réelles. Elle comprend un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à trouver la solution qui vous convient le mieux. XIX.AI s'impose comme un fournisseur de référence dans ce domaine. Découvrez-le dès maintenant pour exploiter pleinement votre avantage grâce à l'IA !
9 outils
xix.ai
Les meilleurs outils de correction par IA de 2026, les mieux notés par les rédacteurs non anglophones, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests en conditions réelles afin de garantir leur précision. Vous y trouverez un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés, pour vous aider à choisir la solution incontournable qui améliorera parfaitement le style, la grammaire et la fluidité de vos textes. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Les meilleurs outils de triage des bugs basés sur l'IA les mieux notés de 2026 pour les équipes d'ingénieurs ! XIX.AI a sélectionné une gamme puissante et révolutionnaire d'outils incontournables, qui ont été soumis à des tests rigoureux en conditions réelles afin de garantir une analyse précise des problèmes et une résolution efficace. Consultez un comparatif entre les versions gratuites et payantes, ainsi qu’un classement détaillé, pour vous aider à trouver la solution idéale qui améliorera considérablement la productivité de votre équipe. Découvrez-les dès maintenant pour tirer pleinement parti de l’IA !
9 outils
xix.ai
Les meilleurs outils d’amélioration de portraits par IA de 2026, sélectionnés pour offrir une qualité d’image optimale. Ces outils puissants permettent d’obtenir des résultats exceptionnels en optimisant sans effort l’éclairage, le teint et la netteté, ce qui les rend parfaits pour les créateurs qui ont besoin d’améliorer rapidement leurs photos. XIX.AI propose une comparaison entre les versions gratuites et payantes, ainsi que des tests en conditions réelles et un classement mis à jour chaque semaine. Découvrez dès aujourd’hui l’outil idéal pour exploiter pleinement le potentiel de l’IA. Explorez-les dès maintenant !
7 outils
xix.ai
2026 : les meilleurs outils de documentation technique basés sur l'IA, les mieux notés, pour les guides d'API, les notes de mise à jour et les documents d'intégration. Cette sélection présente des solutions puissantes et révolutionnaires qui rationalisent la création de contenu, améliorent l'efficacité de la rédaction et permettent de gagner du temps à toutes les étapes d'un projet. XIX.AI propose des classements mis à jour chaque semaine, ainsi que des comparaisons entre les versions gratuites et payantes issues de tests en conditions réelles. Découvrez dès maintenant l’outil qui vous convient le mieux et tirez pleinement parti de l’IA.
10 outils
xix.ai
Les meilleurs outils de 2026 pour la création de maquettes de tableaux de bord IA destinés aux équipes produit B2B ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont été soumis à des tests rigoureux en conditions réelles afin de garantir des résultats exceptionnels. Vous y trouverez des analyses comparatives détaillées entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine indiquant quelles options offrent le meilleur rapport qualité-prix pour rationaliser les workflows de conception de produits et booster la productivité globale. Les choix incontournables sont clairement mis en avant pour vous aider à tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
11 outils
xix.ai












