

 Heim
Groq stellt Kerntechnologie vor, wechselt zum Cloud-Modell und sammelt 4,4 Milliarden Yuan für den Ausbau der Rechenkapazität ein
Letztes Jahr hat Groq, ein KI-Chip-Startup, seine proprietäre LPU-Inferenztechnologie für 2 Milliarden US-Dollar an NVIDIA lizenziert, wobei ausgewählte Teammitglieder zu NVIDIA wechselten. Diese Transaktion warf Fragen bezüglich der Zukunft von Groq auf, doch innerhalb von sechs Monaten reagierte das Unternehmen, indem es sich zu einem Cloud-Dienstleister für KI-Inferenz neu ausrichtete und eine Finanzierungsrunde in Höhe von 650 Millionen US-Dollar (ca. 4,4 Milliarden Yuan) sicherte.
Das Vertrauen basiert auf „Einzigartigkeit“
Groqs Selbstbewusstsein wurzelt in einem klaren Vorteil: einem globalen Ingenieurteam mit praktischer Erfahrung im Betrieb großer LPU-Systeme. Die LPU (Language Processing Unit), ein von Groq entwickelter spezialisierter Inferenzchip, zeichnet sich durch außergewöhnlich niedrige Latenzzeiten bei der Verarbeitung großer Modell-Inferenzaufgaben aus und gewinnt das Vertrauen der Entwickler durch ihre bemerkenswerte Generierungsgeschwindigkeit.
Obwohl die Technologie an NVIDIA lizenziert wurde, bleiben das Team und das Fachwissen intakt. Groq betrachtet dieses „Muskelgedächtnis“ als seinen Kernwettbewerbsvorteil gegenüber anderen Cloud-Anbietern. Derzeit betreibt Groq 13 Rechenzentren in vier Regionen – Nordamerika, Europa, dem Nahen Osten und Asien-Pazifik – und bedient über 5 Millionen Entwickler sowie Tausende KI-nativer Unternehmen, wobei der wöchentliche Token-Verbrauch die Billionengrenze erreicht.
Fokus auf 2027, Wette auf 200 MW Rechenleistung
Diese Finanzierung wird hauptsächlich den Ausbau der KI-Inferenzinfrastruktur vorantreiben. Groq plant, die neueste Inferenztechnologie und NVIDIA-LPX-Systeme einzusetzen, um die Rechenkapazität bis Ende 2027 auf 200 Megawatt zu steigern und so größere Inferenzoperationen zu unterstützen.
Vom Chip-Designunternehmen zum Cloud-Dienstleister für KI-Inferenz – Groqs Transformation ist mehr als eine einfache Neustrukturierung des Geschäftsmodells. In einem Markt, der von NVIDIA dominiert wird, stellt die Lizenzierung der Technologie an den stärksten Konkurrenten bei gleichzeitiger rascher Ausweitung des eigenen Cloud-Dienstleistungs-Fußabdrucks über die Plattform eine Strategie dar, die als neue Überlebensweisheit für KI-Startups an Bedeutung gewinnt.
Verwandter Artikel
 Claude Opus 5.2 in Nachtgrau erscheint mit schnellerer Antwortzeit und behebt das Problem der Trägheit
Opus 5.2 wurde heute Morgen stillschweigend eingeführt, was viele Entwickler dazu veranlasste, festzustellen, dass das aktualisierte Modell, Claude Opus 5.2, eine begrenzte Rollout-Phase innerhalb von Claude Code begonnen hat.Gestern Abend stellten
Fireworks AI stellt FireRouter mit Opus vor: Reduziert die Encodierungskosten um 57 % bei minimaler Genauigkeitsverlust
Fireworks AI hat FireRouter mit Opus eingeführt, das erste cache-bewusste Routing-System der Branche, das speziell für die Claude-Opus-Serie entwickelt wurde. Jetzt über einen serverlosen Endpunkt verfügbar, durchlief dieses unabhängige Routing-Model
NVIDIA stellt das einheitliche Audio-Intelligenzmodell Nemotron-Labs-Audex-30B-A3B vor
Während multimodale große Modelle rasch voranschreiten, werden die Fähigkeiten zur Audiobearbeitung häufig beeinträchtigt – viele Modelle verbessern das Audioverständnis auf Kosten der Textlogik. Um dies zu adressieren, haben NVIDIA-Forscher Nemotron
Empfehlungen zu verwandten Spezialthemen
Chatbot
 KI-basierte Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Kunden und Rückgabeanfragen
2026: Die neuesten, besten und am besten bewerteten KI-Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Käufer und Rückgabeanfragen. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in Praxistests die Produktivität drastisch gesteigert haben. Sie umfasst einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden. XIX.AI sticht als vertrauenswürdiger Anbieter in diesem Bereich hervor. Entdecken Sie das Angebot jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Schreiben
Die besten KI-Tools zur Textbearbeitung für ESL-Autoren: Tonfall, Grammatik und Lesefluss verbessern
Die besten und am besten bewerteten KI-Korrekturtools für ESL-Autoren des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die in der Praxis getestet wurden, um ihre Genauigkeit zu gewährleisten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihren Schreibstil, Ihre Grammatik und den Lesefluss perfekt zu verbessern. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Softwareentwicklung
Die besten KI-Tools zur Fehlerklassifizierung für Entwicklerteams
Die besten und am besten bewerteten KI-Tools zur Fehlertriage für Entwicklerteams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese Tools durchlaufen strenge Praxistests, um eine genaue Fehleranalyse und eine effiziente Fehlerbehebung zu gewährleisten. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, mit der Sie die Produktivität Ihres Teams deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
9 Tools
xix.ai
Bildbearbeitung
Die besten KI-Porträtoptimierer: Beleuchtung, Hautton und Schärfe verbessern
2026: Die neuesten, besten und am besten bewerteten KI-Porträtoptimierer, ausgewählt für ultimative Bildqualität. Diese leistungsstarken Tools liefern bahnbrechende Ergebnisse, indem sie Beleuchtung, Hautton und Schärfe mühelos verbessern – perfekt für Kreative, die Fotos schnell optimieren müssen. XIX.AI bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Ranglisten. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
7 Tools
xix.ai
Schreiben
KI-basierte Tools zur Erstellung technischer Dokumentationen für API-Handbücher, Versionshinweise und Einführungsunterlagen
2026: Die neuesten, besten und am besten bewerteten KI-Tools für technische Dokumentation – für API-Anleitungen, Versionshinweise und Onboarding-Dokumente. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Erstellung von Inhalten optimieren, die Effizienz beim Verfassen von Texten steigern und in allen Projektphasen Zeit sparen. XIX.AI bietet wöchentlich aktualisierte Rankings sowie Vergleichsergebnisse zwischen kostenlosen und kostenpflichtigen Angeboten, die auf Praxistests basieren. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil.
10 Tools
xix.ai
Design
Tools zur Erstellung von Wireframes für KI-Dashboards für B2B-Produktteams
Die besten KI-Tools für das Wireframing von Dashboards für B2B-Produktteams im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die strengen Praxistests unterzogen wurden und außergewöhnliche Ergebnisse liefern. Sie finden detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, die aufzeigen, welche Optionen den größten Nutzen für die Optimierung von Produktdesign-Workflows und die Steigerung der Gesamtproduktivität bieten. Besonders empfehlenswerte Optionen sind deutlich hervorgehoben, damit Sie Ihren KI-Vorteil voll ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
Letztes Jahr hat Groq, ein KI-Chip-Startup, seine proprietäre LPU-Inferenztechnologie für 2 Milliarden US-Dollar an NVIDIA lizenziert, wobei ausgewählte Teammitglieder zu NVIDIA wechselten. Diese Transaktion warf Fragen bezüglich der Zukunft von Groq auf, doch innerhalb von sechs Monaten reagierte das Unternehmen, indem es sich zu einem Cloud-Dienstleister für KI-Inferenz neu ausrichtete und eine Finanzierungsrunde in Höhe von 650 Millionen US-Dollar (ca. 4,4 Milliarden Yuan) sicherte.
Das Vertrauen basiert auf „Einzigartigkeit“
Groqs Selbstbewusstsein wurzelt in einem klaren Vorteil: einem globalen Ingenieurteam mit praktischer Erfahrung im Betrieb großer LPU-Systeme. Die LPU (Language Processing Unit), ein von Groq entwickelter spezialisierter Inferenzchip, zeichnet sich durch außergewöhnlich niedrige Latenzzeiten bei der Verarbeitung großer Modell-Inferenzaufgaben aus und gewinnt das Vertrauen der Entwickler durch ihre bemerkenswerte Generierungsgeschwindigkeit.
Obwohl die Technologie an NVIDIA lizenziert wurde, bleiben das Team und das Fachwissen intakt. Groq betrachtet dieses „Muskelgedächtnis“ als seinen Kernwettbewerbsvorteil gegenüber anderen Cloud-Anbietern. Derzeit betreibt Groq 13 Rechenzentren in vier Regionen – Nordamerika, Europa, dem Nahen Osten und Asien-Pazifik – und bedient über 5 Millionen Entwickler sowie Tausende KI-nativer Unternehmen, wobei der wöchentliche Token-Verbrauch die Billionengrenze erreicht.
Fokus auf 2027, Wette auf 200 MW Rechenleistung
Diese Finanzierung wird hauptsächlich den Ausbau der KI-Inferenzinfrastruktur vorantreiben. Groq plant, die neueste Inferenztechnologie und NVIDIA-LPX-Systeme einzusetzen, um die Rechenkapazität bis Ende 2027 auf 200 Megawatt zu steigern und so größere Inferenzoperationen zu unterstützen.
Vom Chip-Designunternehmen zum Cloud-Dienstleister für KI-Inferenz – Groqs Transformation ist mehr als eine einfache Neustrukturierung des Geschäftsmodells. In einem Markt, der von NVIDIA dominiert wird, stellt die Lizenzierung der Technologie an den stärksten Konkurrenten bei gleichzeitiger rascher Ausweitung des eigenen Cloud-Dienstleistungs-Fußabdrucks über die Plattform eine Strategie dar, die als neue Überlebensweisheit für KI-Startups an Bedeutung gewinnt.


 Claude Opus 5.2 in Nachtgrau erscheint mit schnellerer Antwortzeit und behebt das Problem der Trägheit
Opus 5.2 wurde heute Morgen stillschweigend eingeführt, was viele Entwickler dazu veranlasste, festzustellen, dass das aktualisierte Modell, Claude Opus 5.2, eine begrenzte Rollout-Phase innerhalb von Claude Code begonnen hat.Gestern Abend stellten
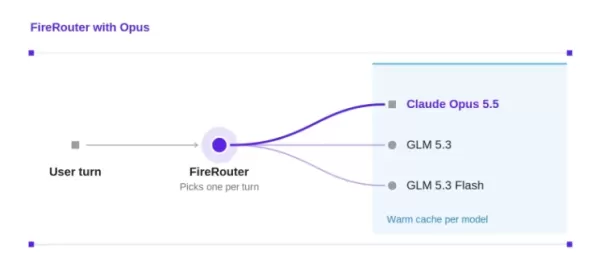 Fireworks AI stellt FireRouter mit Opus vor: Reduziert die Encodierungskosten um 57 % bei minimaler Genauigkeitsverlust
Fireworks AI hat FireRouter mit Opus eingeführt, das erste cache-bewusste Routing-System der Branche, das speziell für die Claude-Opus-Serie entwickelt wurde. Jetzt über einen serverlosen Endpunkt verfügbar, durchlief dieses unabhängige Routing-Model
 NVIDIA stellt das einheitliche Audio-Intelligenzmodell Nemotron-Labs-Audex-30B-A3B vor
Während multimodale große Modelle rasch voranschreiten, werden die Fähigkeiten zur Audiobearbeitung häufig beeinträchtigt – viele Modelle verbessern das Audioverständnis auf Kosten der Textlogik. Um dies zu adressieren, haben NVIDIA-Forscher Nemotron
2026: Die neuesten, besten und am besten bewerteten KI-Live-Chat-Routing-Tools für E-Commerce-Warteschlangen, VIP-Käufer und Rückgabeanfragen. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in Praxistests die Produktivität drastisch gesteigert haben. Sie umfasst einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden. XIX.AI sticht als vertrauenswürdiger Anbieter in diesem Bereich hervor. Entdecken Sie das Angebot jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Korrekturtools für ESL-Autoren des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die in der Praxis getestet wurden, um ihre Genauigkeit zu gewährleisten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihren Schreibstil, Ihre Grammatik und den Lesefluss perfekt zu verbessern. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools zur Fehlertriage für Entwicklerteams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese Tools durchlaufen strenge Praxistests, um eine genaue Fehleranalyse und eine effiziente Fehlerbehebung zu gewährleisten. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, mit der Sie die Produktivität Ihres Teams deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
9 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Porträtoptimierer, ausgewählt für ultimative Bildqualität. Diese leistungsstarken Tools liefern bahnbrechende Ergebnisse, indem sie Beleuchtung, Hautton und Schärfe mühelos verbessern – perfekt für Kreative, die Fotos schnell optimieren müssen. XIX.AI bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Ranglisten. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
7 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Tools für technische Dokumentation – für API-Anleitungen, Versionshinweise und Onboarding-Dokumente. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Erstellung von Inhalten optimieren, die Effizienz beim Verfassen von Texten steigern und in allen Projektphasen Zeit sparen. XIX.AI bietet wöchentlich aktualisierte Rankings sowie Vergleichsergebnisse zwischen kostenlosen und kostenpflichtigen Angeboten, die auf Praxistests basieren. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil.
10 Tools
xix.ai
Die besten KI-Tools für das Wireframing von Dashboards für B2B-Produktteams im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die strengen Praxistests unterzogen wurden und außergewöhnliche Ergebnisse liefern. Sie finden detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, die aufzeigen, welche Optionen den größten Nutzen für die Optimierung von Produktdesign-Workflows und die Steigerung der Gesamtproduktivität bieten. Besonders empfehlenswerte Optionen sind deutlich hervorgehoben, damit Sie Ihren KI-Vorteil voll ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












