

 Hogar
Groq presenta su tecnología principal, cambia al modelo en la nube y recauda 4.400 millones de yuanes para ampliar la capacidad de cómputo
El año pasado, Groq, una startup de chips de IA, licenció su tecnología de inferencia LPU propietaria a NVIDIA por 2.000 millones de dólares, con miembros seleccionados del equipo que se unieron a NVIDIA. Este acuerdo planteó dudas sobre el futuro de Groq, pero en seis meses, la empresa respondió pivotando hacia un proveedor de servicios de nube de inferencia de IA, asegurando una ronda de financiación de 650 millones de dólares (aproximadamente 4.400 millones de yuanes).
La confianza proviene de la "unicidad"
La confianza de Groq se basa en una ventaja distintiva: un equipo de ingeniería global con experiencia práctica en operaciones de LPU a gran escala. El LPU (Unidad de Procesamiento de Lenguaje), un chip de inferencia especializado desarrollado por Groq, destaca en el manejo de tareas de inferencia de modelos grandes con una latencia excepcionalmente baja, ganando la confianza de los desarrolladores gracias a su notable velocidad de generación.
Aunque la tecnología fue licenciada a NVIDIA, el equipo y la experiencia permanecen intactos. Groq considera esta "memoria muscular" su ventaja competitiva principal frente a otros proveedores de nube. Actualmente, Groq opera 13 centros de datos en cuatro regiones: Norteamérica, Europa, Oriente Medio y Asia-Pacífico, atendiendo a más de 5 millones de desarrolladores y miles de empresas nativas de IA, con un consumo semanal de tokens que alcanza billones.
Centrándose en 2027, apostando por 200 MW de capacidad de cómputo
Esta financiación se utilizará principalmente para expandir la infraestructura de inferencia de IA. Groq planea implementar la última tecnología de inferencia y los sistemas NVIDIA LPX, con el objetivo de aumentar la capacidad de cómputo a 200 megavatios para finales de 2027, apoyando operaciones de inferencia a mayor escala.
De ser una empresa de diseño de chips a un proveedor de servicios de nube de inferencia de IA, la transformación de Groq es más que una simple reestructuración empresarial. En un mercado dominado por NVIDIA, licenciar tecnología al competidor más fuerte mientras se expande rápidamente su propia presencia en servicios de nube a través de su plataforma, esta estrategia de "retirarse para avanzar" podría estar emergiendo como nueva sabiduría de supervivencia para las startups de IA.
Artículo relacionado
 Claude Opus 5.2 Gris Nocturno se lanza con respuesta más rápida, solucionando el problema de la pereza
Opus 5.2 se lanzó discretamente esta mañana, lo que llevó a muchos desarrolladores a notar que el modelo actualizado, Claude Opus 5.2, ha comenzado un lanzamiento limitado dentro de Claude Code.Anoche, los usuarios de X observaron que invocar Opus 5
Fireworks AI presenta FireRouter con Opus: reduce los costes de codificación en un 57% con una caída mínima de la precisión
Fireworks AI ha presentado FireRouter con Opus, el primer sistema de enrutamiento consciente del caché del sector, diseñado específicamente para la serie Claude Opus. Ahora disponible a través de un punto final sin servidor, este modelo de enrutamien
NVIDIA presenta el modelo de inteligencia de audio unificado Nemotron-Labs-Audex-30B-A3B
A medida que los modelos grandes multimodales evolucionan rápidamente, las capacidades de procesamiento de audio se ven frecuentemente comprometidas; muchos modelos mejoran la comprensión del audio a expensas de la lógica textual. Para abordar esto,
Recomendaciones de temas especiales relacionados
chatbot
 Herramientas de enrutamiento de chat en vivo con IA para colas de comercio electrónico, compradores VIP y solicitudes de devolución
Las mejores herramientas de enrutamiento de chat en vivo con IA de 2026, mejor valoradas para colas de comercio electrónico, compradores VIP y solicitudes de devolución. Esta lista seleccionada presenta potentes soluciones revolucionarias que aumentan drásticamente la productividad, según pruebas realizadas en condiciones reales. Incluye una comparación entre opciones gratuitas y de pago, junto con clasificaciones detalladas para ayudarte a encontrar la opción perfecta. XIX.AI destaca como un proveedor de confianza en este ámbito. ¡Descúbrelo ahora y aprovecha tu ventaja con la IA!
 9 herramientas
 xix.ai
escribiendo
Las mejores herramientas de edición con IA para escritores de inglés como segunda lengua: mejora el tono, la gramática y la fluidez
¡Las mejores herramientas de edición con IA mejor valoradas de 2026 para escritores de inglés como segunda lengua ya están aquí, en XIX.AI! Esta lista seleccionada incluye potentes herramientas revolucionarias que se someten a pruebas en el mundo real para garantizar su precisión. Encontrarás una comparación entre las versiones gratuitas y de pago, junto con clasificaciones detalladas, que te ayudarán a elegir la solución imprescindible que mejorará a la perfección el tono, la gramática y la fluidez de tu escritura. ¡Explora ahora mismo y descubre tu ventaja con la IA!
9 herramientas
xix.ai
Desarrollo de software
Las mejores herramientas de clasificación de errores basadas en IA para equipos de ingeniería
¡Las mejores herramientas de clasificación de errores con IA mejor valoradas de 2026 para equipos de ingeniería! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a rigurosas pruebas en condiciones reales para ofrecer un análisis preciso de los problemas y una resolución eficaz. Consigue una comparación entre las opciones gratuitas y las de pago, junto con clasificaciones detalladas, que te ayudarán a encontrar la solución perfecta para aumentar significativamente la productividad de tu equipo. ¡Explora ahora mismo y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai
Edición de imágenes
Los mejores programas de mejora de retratos con IA: mejora la iluminación, el tono de piel y la nitidez
Los mejores y más valorados programas de mejora de retratos con IA de 2026, seleccionados para ofrecer la máxima calidad de imagen. Estas potentes herramientas ofrecen resultados revolucionarios al mejorar la iluminación, el tono de piel y la nitidez sin esfuerzo, lo que las hace perfectas para los creadores que necesitan retocar fotos rápidamente. XIX.AI ofrece una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Descubre hoy mismo la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
7 herramientas
xix.ai
escribiendo
Herramientas de documentación técnica basadas en IA para guías de API, notas de lanzamiento y documentación de incorporación
Las mejores herramientas de documentación técnica con IA de 2026, mejor valoradas para guías de API, notas de lanzamiento y documentos de incorporación. Esta lista seleccionada incluye potentes soluciones revolucionarias que agilizan la creación de contenidos, aumentan la eficiencia en la redacción y ahorran tiempo en todas las fases del proyecto. XIX.AI ofrece clasificaciones actualizadas semanalmente, junto con resultados comparativos entre opciones gratuitas y de pago basados en pruebas reales. Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA.
10 herramientas
xix.ai
diseño
Herramientas de creación de maquetas de paneles de control de IA para equipos de producto B2B
¡Las mejores herramientas de 2026 para la creación de maquetas de paneles de control con IA para equipos de producto B2B! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás información detallada que compara las versiones gratuitas con las de pago, así como clasificaciones actualizadas semanalmente que muestran qué opciones ofrecen mayor valor para optimizar los flujos de trabajo de diseño de productos y potenciar la productividad general. Las opciones imprescindibles aparecen claramente destacadas para ayudarte a sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (0)
0/500
El año pasado, Groq, una startup de chips de IA, licenció su tecnología de inferencia LPU propietaria a NVIDIA por 2.000 millones de dólares, con miembros seleccionados del equipo que se unieron a NVIDIA. Este acuerdo planteó dudas sobre el futuro de Groq, pero en seis meses, la empresa respondió pivotando hacia un proveedor de servicios de nube de inferencia de IA, asegurando una ronda de financiación de 650 millones de dólares (aproximadamente 4.400 millones de yuanes).
La confianza proviene de la "unicidad"
La confianza de Groq se basa en una ventaja distintiva: un equipo de ingeniería global con experiencia práctica en operaciones de LPU a gran escala. El LPU (Unidad de Procesamiento de Lenguaje), un chip de inferencia especializado desarrollado por Groq, destaca en el manejo de tareas de inferencia de modelos grandes con una latencia excepcionalmente baja, ganando la confianza de los desarrolladores gracias a su notable velocidad de generación.
Aunque la tecnología fue licenciada a NVIDIA, el equipo y la experiencia permanecen intactos. Groq considera esta "memoria muscular" su ventaja competitiva principal frente a otros proveedores de nube. Actualmente, Groq opera 13 centros de datos en cuatro regiones: Norteamérica, Europa, Oriente Medio y Asia-Pacífico, atendiendo a más de 5 millones de desarrolladores y miles de empresas nativas de IA, con un consumo semanal de tokens que alcanza billones.
Centrándose en 2027, apostando por 200 MW de capacidad de cómputo
Esta financiación se utilizará principalmente para expandir la infraestructura de inferencia de IA. Groq planea implementar la última tecnología de inferencia y los sistemas NVIDIA LPX, con el objetivo de aumentar la capacidad de cómputo a 200 megavatios para finales de 2027, apoyando operaciones de inferencia a mayor escala.
De ser una empresa de diseño de chips a un proveedor de servicios de nube de inferencia de IA, la transformación de Groq es más que una simple reestructuración empresarial. En un mercado dominado por NVIDIA, licenciar tecnología al competidor más fuerte mientras se expande rápidamente su propia presencia en servicios de nube a través de su plataforma, esta estrategia de "retirarse para avanzar" podría estar emergiendo como nueva sabiduría de supervivencia para las startups de IA.


 Claude Opus 5.2 Gris Nocturno se lanza con respuesta más rápida, solucionando el problema de la pereza
Opus 5.2 se lanzó discretamente esta mañana, lo que llevó a muchos desarrolladores a notar que el modelo actualizado, Claude Opus 5.2, ha comenzado un lanzamiento limitado dentro de Claude Code.Anoche, los usuarios de X observaron que invocar Opus 5
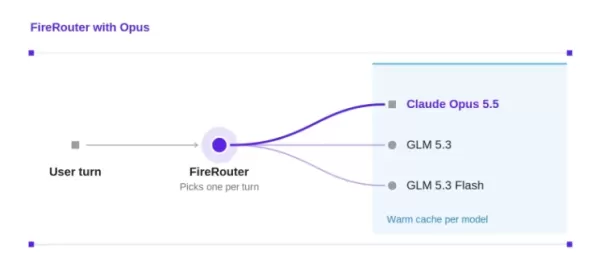 Fireworks AI presenta FireRouter con Opus: reduce los costes de codificación en un 57% con una caída mínima de la precisión
Fireworks AI ha presentado FireRouter con Opus, el primer sistema de enrutamiento consciente del caché del sector, diseñado específicamente para la serie Claude Opus. Ahora disponible a través de un punto final sin servidor, este modelo de enrutamien
 NVIDIA presenta el modelo de inteligencia de audio unificado Nemotron-Labs-Audex-30B-A3B
A medida que los modelos grandes multimodales evolucionan rápidamente, las capacidades de procesamiento de audio se ven frecuentemente comprometidas; muchos modelos mejoran la comprensión del audio a expensas de la lógica textual. Para abordar esto,
Las mejores herramientas de enrutamiento de chat en vivo con IA de 2026, mejor valoradas para colas de comercio electrónico, compradores VIP y solicitudes de devolución. Esta lista seleccionada presenta potentes soluciones revolucionarias que aumentan drásticamente la productividad, según pruebas realizadas en condiciones reales. Incluye una comparación entre opciones gratuitas y de pago, junto con clasificaciones detalladas para ayudarte a encontrar la opción perfecta. XIX.AI destaca como un proveedor de confianza en este ámbito. ¡Descúbrelo ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
¡Las mejores herramientas de edición con IA mejor valoradas de 2026 para escritores de inglés como segunda lengua ya están aquí, en XIX.AI! Esta lista seleccionada incluye potentes herramientas revolucionarias que se someten a pruebas en el mundo real para garantizar su precisión. Encontrarás una comparación entre las versiones gratuitas y de pago, junto con clasificaciones detalladas, que te ayudarán a elegir la solución imprescindible que mejorará a la perfección el tono, la gramática y la fluidez de tu escritura. ¡Explora ahora mismo y descubre tu ventaja con la IA!
9 herramientas
xix.ai
¡Las mejores herramientas de clasificación de errores con IA mejor valoradas de 2026 para equipos de ingeniería! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a rigurosas pruebas en condiciones reales para ofrecer un análisis preciso de los problemas y una resolución eficaz. Consigue una comparación entre las opciones gratuitas y las de pago, junto con clasificaciones detalladas, que te ayudarán a encontrar la solución perfecta para aumentar significativamente la productividad de tu equipo. ¡Explora ahora mismo y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai
Los mejores y más valorados programas de mejora de retratos con IA de 2026, seleccionados para ofrecer la máxima calidad de imagen. Estas potentes herramientas ofrecen resultados revolucionarios al mejorar la iluminación, el tono de piel y la nitidez sin esfuerzo, lo que las hace perfectas para los creadores que necesitan retocar fotos rápidamente. XIX.AI ofrece una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Descubre hoy mismo la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
7 herramientas
xix.ai
Las mejores herramientas de documentación técnica con IA de 2026, mejor valoradas para guías de API, notas de lanzamiento y documentos de incorporación. Esta lista seleccionada incluye potentes soluciones revolucionarias que agilizan la creación de contenidos, aumentan la eficiencia en la redacción y ahorran tiempo en todas las fases del proyecto. XIX.AI ofrece clasificaciones actualizadas semanalmente, junto con resultados comparativos entre opciones gratuitas y de pago basados en pruebas reales. Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA.
10 herramientas
xix.ai
¡Las mejores herramientas de 2026 para la creación de maquetas de paneles de control con IA para equipos de producto B2B! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás información detallada que compara las versiones gratuitas con las de pago, así como clasificaciones actualizadas semanalmente que muestran qué opciones ofrecen mayor valor para optimizar los flujos de trabajo de diseño de productos y potenciar la productividad general. Las opciones imprescindibles aparecen claramente destacadas para ayudarte a sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai












