


 Maison
Le nouveau test AGI s'avère difficile, les souches majorité des modèles d'IA
La Fondation Arc Prize, co-fondée par le célèbre chercheur en IA François Chollet, a récemment dévoilé un nouveau benchmark appelé ARC-AGI-2 dans un article de blog. Ce test vise à repousser les limites de l'intelligence générale de l'IA, et jusqu'à présent, il s'avère être un défi de taille pour la plupart des modèles d'IA.
Selon le classement d'Arc Prize, même les modèles d'IA avancés en "raisonnement" comme o1-pro d'OpenAI et R1 de DeepSeek ne parviennent qu'à obtenir des scores entre 1 % et 1,3 %. Pendant ce temps, les modèles puissants non axés sur le raisonnement, tels que GPT-4.5, Claude 3.7 Sonnet et Gemini 2.0 Flash, se situent autour de la barre des 1 %.
Les tests ARC-AGI mettent les systèmes d'IA à l'épreuve avec des problèmes de type casse-tête, les obligeant à identifier des motifs visuels dans des grilles de carrés de différentes couleurs et à générer la grille "réponse" correcte. Ces problèmes sont conçus pour tester la capacité d'une IA à s'adapter à de nouveaux défis inédits.
Pour établir une référence humaine, la Fondation Arc Prize a fait passer le test ARC-AGI-2 à plus de 400 personnes. En moyenne, ces "panels" d'humains ont atteint un taux de réussite de 60 %, surpassant largement les modèles d'IA.
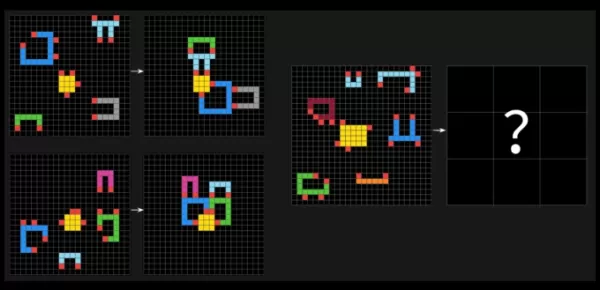
Un exemple de question d'ARC-AGI-2. Crédits image : Arc Prize François Chollet a déclaré sur X qu'ARC-AGI-2 est une mesure plus précise de l'intelligence réelle d'un modèle d'IA par rapport à son prédécesseur, ARC-AGI-1. Les tests de la Fondation Arc Prize sont conçus pour évaluer si une IA peut apprendre efficacement de nouvelles compétences au-delà de ses données d'entraînement.Chollet a souligné qu'ARC-AGI-2 empêche les modèles d'IA de s'appuyer sur une puissance de calcul "brute" pour résoudre les problèmes, un défaut qu'il a reconnu dans le premier test. Pour y remédier, ARC-AGI-2 introduit une métrique d'efficacité et exige que les modèles interprètent les motifs à la volée plutôt que de s'appuyer sur la mémorisation.
Dans un article de blog, le co-fondateur de la Fondation Arc Prize, Greg Kamradt, a insisté sur le fait que l'intelligence ne se limite pas à résoudre des problèmes ou à obtenir des scores élevés. "L'efficacité avec laquelle ces capacités sont acquises et déployées est un composant crucial et déterminant", a-t-il écrit. "La question centrale posée n'est pas seulement : 'L'IA peut-elle acquérir la compétence pour résoudre une tâche ?', mais aussi : 'À quelle efficacité ou à quel coût ?'"
ARC-AGI-1 est resté invaincu pendant environ cinq ans jusqu'en décembre 2024, lorsque le modèle de raisonnement avancé d'OpenAI, o3, a surpassé tous les autres modèles d'IA et égalé les performances humaines. Cependant, le succès d'o3 sur ARC-AGI-1 a eu un coût significatif. La version du modèle o3 d'OpenAI, o3 (low), qui a obtenu un impressionnant 75,7 % sur ARC-AGI-1, n'a atteint qu'un maigre 4 % sur ARC-AGI-2, en utilisant 200 $ de puissance de calcul par tâche.

Comparaison des performances des modèles d'IA de pointe sur ARC-AGI-1 et ARC-AGI-2. Crédits image : Arc Prize L'introduction d'ARC-AGI-2 intervient à un moment où de nombreux acteurs de l'industrie technologique réclament de nouveaux benchmarks non saturés pour mesurer les progrès de l'IA. Thomas Wolf, co-fondateur de Hugging Face, a récemment déclaré à TechCrunch que l'industrie de l'IA manque de tests suffisants pour mesurer des traits clés de l'intelligence générale artificielle, tels que la créativité.Parallèlement au nouveau benchmark, la Fondation Arc Prize a annoncé le concours Arc Prize 2025, défiant les développeurs d'atteindre une précision de 85 % sur le test ARC-AGI-2 tout en dépensant seulement 0,42 $ par tâche.
Article connexe
 Le RSI devient le nouvel AGI, tout aussi difficile à définir
Le terme « récursivité » est devenu le dernier mot à la mode dans le domaine de l’intelligence artificielle. Deux start-ups distinctes l’ont adopté comme nom, et de nombreuses autres font désormais ré
OpenAI présente les grandes lignes d'une économie de l'IA fondée sur des fonds de richesse publique, une taxe sur les robots et la semaine de quatre jours
Alors que les gouvernements peinent à gérer l’impact économique des machines superintelligentes, OpenAI a publié une série de propositions politiques décrivant comment la richesse et le travail pourra
Le cofondateur de Databricks annonce l'avènement de l'IA générale après avoir remporté le prix ACM
Matei Zaharia, cofondateur et directeur technique de Databricks, a failli passer à côté de l'e-mail lui annonçant qu'il avait remporté le prix ACM 2026 en informatique. « Ce fut vraiment une surprise
Recommandations de sujets spéciaux liés
Référencement
 Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
 13 outils
 xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

 commentaires (40)
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
La Fondation Arc Prize, co-fondée par le célèbre chercheur en IA François Chollet, a récemment dévoilé un nouveau benchmark appelé ARC-AGI-2 dans un article de blog. Ce test vise à repousser les limites de l'intelligence générale de l'IA, et jusqu'à présent, il s'avère être un défi de taille pour la plupart des modèles d'IA.
Selon le classement d'Arc Prize, même les modèles d'IA avancés en "raisonnement" comme o1-pro d'OpenAI et R1 de DeepSeek ne parviennent qu'à obtenir des scores entre 1 % et 1,3 %. Pendant ce temps, les modèles puissants non axés sur le raisonnement, tels que GPT-4.5, Claude 3.7 Sonnet et Gemini 2.0 Flash, se situent autour de la barre des 1 %.
Les tests ARC-AGI mettent les systèmes d'IA à l'épreuve avec des problèmes de type casse-tête, les obligeant à identifier des motifs visuels dans des grilles de carrés de différentes couleurs et à générer la grille "réponse" correcte. Ces problèmes sont conçus pour tester la capacité d'une IA à s'adapter à de nouveaux défis inédits.
Pour établir une référence humaine, la Fondation Arc Prize a fait passer le test ARC-AGI-2 à plus de 400 personnes. En moyenne, ces "panels" d'humains ont atteint un taux de réussite de 60 %, surpassant largement les modèles d'IA.
Chollet a souligné qu'ARC-AGI-2 empêche les modèles d'IA de s'appuyer sur une puissance de calcul "brute" pour résoudre les problèmes, un défaut qu'il a reconnu dans le premier test. Pour y remédier, ARC-AGI-2 introduit une métrique d'efficacité et exige que les modèles interprètent les motifs à la volée plutôt que de s'appuyer sur la mémorisation.
Dans un article de blog, le co-fondateur de la Fondation Arc Prize, Greg Kamradt, a insisté sur le fait que l'intelligence ne se limite pas à résoudre des problèmes ou à obtenir des scores élevés. "L'efficacité avec laquelle ces capacités sont acquises et déployées est un composant crucial et déterminant", a-t-il écrit. "La question centrale posée n'est pas seulement : 'L'IA peut-elle acquérir la compétence pour résoudre une tâche ?', mais aussi : 'À quelle efficacité ou à quel coût ?'"
ARC-AGI-1 est resté invaincu pendant environ cinq ans jusqu'en décembre 2024, lorsque le modèle de raisonnement avancé d'OpenAI, o3, a surpassé tous les autres modèles d'IA et égalé les performances humaines. Cependant, le succès d'o3 sur ARC-AGI-1 a eu un coût significatif. La version du modèle o3 d'OpenAI, o3 (low), qui a obtenu un impressionnant 75,7 % sur ARC-AGI-1, n'a atteint qu'un maigre 4 % sur ARC-AGI-2, en utilisant 200 $ de puissance de calcul par tâche.
Parallèlement au nouveau benchmark, la Fondation Arc Prize a annoncé le concours Arc Prize 2025, défiant les développeurs d'atteindre une précision de 85 % sur le test ARC-AGI-2 tout en dépensant seulement 0,42 $ par tâche.








 Le RSI devient le nouvel AGI, tout aussi difficile à définir
Le terme « récursivité » est devenu le dernier mot à la mode dans le domaine de l’intelligence artificielle. Deux start-ups distinctes l’ont adopté comme nom, et de nombreuses autres font désormais ré
 OpenAI présente les grandes lignes d'une économie de l'IA fondée sur des fonds de richesse publique, une taxe sur les robots et la semaine de quatre jours
Alors que les gouvernements peinent à gérer l’impact économique des machines superintelligentes, OpenAI a publié une série de propositions politiques décrivant comment la richesse et le travail pourra
 Le cofondateur de Databricks annonce l'avènement de l'IA générale après avoir remporté le prix ACM
Matei Zaharia, cofondateur et directeur technique de Databricks, a failli passer à côté de l'e-mail lui annonçant qu'il avait remporté le prix ACM 2026 en informatique. « Ce fut vraiment une surprise

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












