


 Hogar
Meitun LongCat lanza LoHoSearch mientras BrowseComp cae por debajo del 30%
Las capacidades de los agentes de búsqueda han sido definidas en gran medida por BrowseComp durante el último año. Sin embargo, este benchmark está perdiendo relevancia: impulsó el rendimiento de los modelos del 30% al 90% en solo diez meses, y su valor disminuye rápidamente. El 17 de julio, LongCat de Meituan lanzó una evaluación más rigurosa, LoHoSearch, diseñada para reavivar el progreso significativo en el desarrollo de agentes de búsqueda.
Los desafíos de LoHoSearch no están elaborados manualmente, sino generados automáticamente a partir de un grafo de conocimiento de Wikipedia que contiene 7,62 millones de entidades. Dado que son generados por máquinas, estas tareas alcanzan niveles de espacio de búsqueda y complejidad estructural que los anotadores humanos nunca podrían replicar de manera consistente. En resumen, mientras que los benchmarks anteriores estaban limitados por techos diseñados por humanos, LoHoSearch delega la generación de preguntas al grafo de conocimiento, eliminando efectivamente ese límite superior.
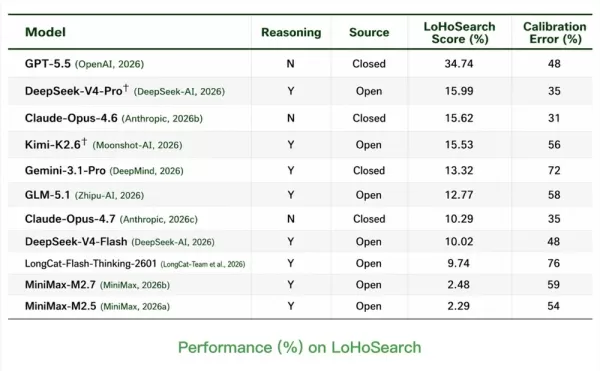
Los resultados son contundentes. Entre 11 modelos líderes, la puntuación más alta alcanzó solo el 34,74%, con los siguientes tres obteniendo puntuaciones entre el 15% y el 16%. En contraste, estos mismos modelos logran aproximadamente el 90% en BrowseComp. Esta brecha resalta las verdaderas limitaciones de los agentes de búsqueda actuales. Cabe destacar que las estrategias de contexto ofrecen rendimientos decrecientes: la mejor estrategia de contexto en LoHoSearch mejoró las puntuaciones solo en 6,8 puntos porcentuales, en comparación con 14 puntos porcentuales en BrowseComp. Esto sugiere que confiar en ingeniería de prompts y contexto para cerrar las brechas de capacidad es en gran medida ineficaz bajo este nuevo benchmark.
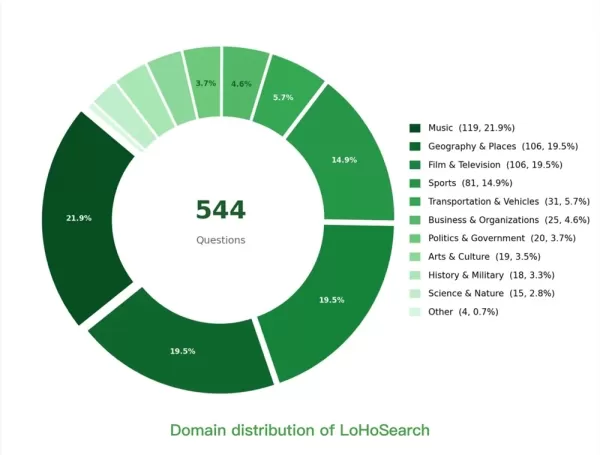
LoHoSearch comprende 544 preguntas que abarcan 11 dominios, estructuradas en formatos de árbol y grafo, y ha sido de código abierto. A medida que los benchmarks más antiguos se estancan, los verdaderos desafíos para los agentes de búsqueda apenas comienzan, y LoHoSearch podría pronto convertirse en un estándar de evaluación esencial.
Artículo relacionado
 Conjunto de chips Kunlun de Baidu para cotización pública en Hong Kong con objetivo de valoración de 50.000 millones de dólares
El 29 de junio, los mercados de capitales se vieron sacudidos por noticias de gran calado: la filial de Baidu dedicada a los chips de inteligencia artificial, Kunlun Tech, está acelerando su oferta pública inicial (IPO) en Hong Kong, con una valoraci
Instinct lanza un agente de IA en chats grupales, incluidos aquellos con no usuarios
Instinct, el agente de IA que ahora se valora en 10.000 millones de dólares tras su última ronda de financiación, se expande a los chats grupales. La startup anunció el lunes que los usuarios pueden añadir el agente a conversaciones con amigos, ofrec
MiniMax presenta el modelo multimodal H3, reduciendo los costos de generación audiovisual 2K de 15 segundos a menos de un tercio del estándar de la industria
MiniMax ha presentado oficialmente MiniMax H3, un modelo de generación multimodal de propósito general diseñado para unificar la comprensión y la creación de texto, imágenes, video y audio. Al superar la división histórica entre tareas y modalidades
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Las capacidades de los agentes de búsqueda han sido definidas en gran medida por BrowseComp durante el último año. Sin embargo, este benchmark está perdiendo relevancia: impulsó el rendimiento de los modelos del 30% al 90% en solo diez meses, y su valor disminuye rápidamente. El 17 de julio, LongCat de Meituan lanzó una evaluación más rigurosa, LoHoSearch, diseñada para reavivar el progreso significativo en el desarrollo de agentes de búsqueda.
Los desafíos de LoHoSearch no están elaborados manualmente, sino generados automáticamente a partir de un grafo de conocimiento de Wikipedia que contiene 7,62 millones de entidades. Dado que son generados por máquinas, estas tareas alcanzan niveles de espacio de búsqueda y complejidad estructural que los anotadores humanos nunca podrían replicar de manera consistente. En resumen, mientras que los benchmarks anteriores estaban limitados por techos diseñados por humanos, LoHoSearch delega la generación de preguntas al grafo de conocimiento, eliminando efectivamente ese límite superior.
Los resultados son contundentes. Entre 11 modelos líderes, la puntuación más alta alcanzó solo el 34,74%, con los siguientes tres obteniendo puntuaciones entre el 15% y el 16%. En contraste, estos mismos modelos logran aproximadamente el 90% en BrowseComp. Esta brecha resalta las verdaderas limitaciones de los agentes de búsqueda actuales. Cabe destacar que las estrategias de contexto ofrecen rendimientos decrecientes: la mejor estrategia de contexto en LoHoSearch mejoró las puntuaciones solo en 6,8 puntos porcentuales, en comparación con 14 puntos porcentuales en BrowseComp. Esto sugiere que confiar en ingeniería de prompts y contexto para cerrar las brechas de capacidad es en gran medida ineficaz bajo este nuevo benchmark.
LoHoSearch comprende 544 preguntas que abarcan 11 dominios, estructuradas en formatos de árbol y grafo, y ha sido de código abierto. A medida que los benchmarks más antiguos se estancan, los verdaderos desafíos para los agentes de búsqueda apenas comienzan, y LoHoSearch podría pronto convertirse en un estándar de evaluación esencial.








 Conjunto de chips Kunlun de Baidu para cotización pública en Hong Kong con objetivo de valoración de 50.000 millones de dólares
El 29 de junio, los mercados de capitales se vieron sacudidos por noticias de gran calado: la filial de Baidu dedicada a los chips de inteligencia artificial, Kunlun Tech, está acelerando su oferta pública inicial (IPO) en Hong Kong, con una valoraci
 Instinct lanza un agente de IA en chats grupales, incluidos aquellos con no usuarios
Instinct, el agente de IA que ahora se valora en 10.000 millones de dólares tras su última ronda de financiación, se expande a los chats grupales. La startup anunció el lunes que los usuarios pueden añadir el agente a conversaciones con amigos, ofrec
 MiniMax presenta el modelo multimodal H3, reduciendo los costos de generación audiovisual 2K de 15 segundos a menos de un tercio del estándar de la industria
MiniMax ha presentado oficialmente MiniMax H3, un modelo de generación multimodal de propósito general diseñado para unificar la comprensión y la creación de texto, imágenes, video y audio. Al superar la división histórica entre tareas y modalidades

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












