


 Hogar
Google presenta el Gemini 3.1 Flash-Lite: el rendimiento se dispara, pero el precio se triplica
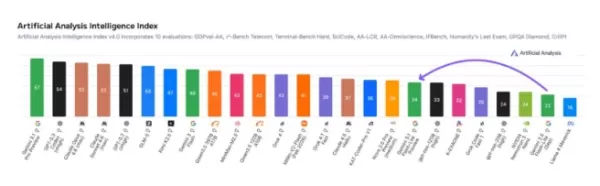
Google DeepMind ha lanzado oficialmente la versión preliminar de Gemini 3.1 Flash-Lite, presentando así el modelo más rápido y rentable de la serie Gemini 3. Partiendo de la base de Gemini 2.5 Flash-Lite, esta versión alcanza velocidades superiores a los 360 tokens por segundo con un tiempo de respuesta medio de 5,1 segundos, al tiempo que ofrece una mejora sustancial en cuanto a inteligencia. Según el Índice de Inteligencia de Análisis Artificial, la puntuación del modelo ha aumentado en 12 puntos hasta alcanzar los 34, y ha demostrado una fuerte preferencia por parte de los usuarios en la clasificación de Arena.ai, con un rating Elo de 1432.
En áreas clave como las capacidades multimodales y el razonamiento científico, Gemini 3.1 Flash-Lite destaca, obteniendo una puntuación del 86,9 % en la prueba GPQA Diamond y alcanzando una precisión del 76,8 % en el benchmark MMMU-Pro. Su rendimiento supera al de pesos pesados como Claude Opus 4.6 y Kimi K2.5. Cabe destacar que el modelo permite a los desarrolladores ajustar la «profundidad» del razonamiento, lo que facilita una adaptación flexible a distintos escenarios, desde simples tareas de traducción hasta el desarrollo de interfaces de usuario complejas.
Sin embargo, estas mejoras en rendimiento y velocidad conllevan ajustes de coste notables. El precio por un millón de tokens de entrada de Gemini 3.1 Flash-Lite ha aumentado a 0,25 dólares, mientras que el precio de salida ha pasado de 0,40 a 1,50 dólares, casi triplicando los costes anteriores.
Esta estrategia de precios pone de relieve las presiones de costes a las que se enfrentan los proveedores de modelos a la hora de equilibrar una inferencia rápida con una lógica de alta precisión. Ahora que el modelo está disponible para su prueba en Google AI Studio y Vertex AI, el mercado de los modelos ligeros está pasando de una simple «competencia de precios bajos» a una nueva era de «accesibilidad a la lógica de alto rendimiento».
Artículo relacionado
 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Slackbot se convierte en un agente de IA
Slackbot, el asistente automatizado integrado en la plataforma de mensajería corporativa Slack de Salesforce, está evolucionando hacia un agente de inteligencia artificial. El CTO de Salesforce, Parker Harris, prevé que alcance un estatus viral compa
Recomendaciones de temas especiales relacionados
Educación y aprendizaje
 Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
 10 herramientas
 xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai
Educación y aprendizaje
Plataformas de construcción de cuestionarios con IA para profesores, tutores y programas de aprendizaje basados en cohortes
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai

 comentario (0)
0/500
Google DeepMind ha lanzado oficialmente la versión preliminar de Gemini 3.1 Flash-Lite, presentando así el modelo más rápido y rentable de la serie Gemini 3. Partiendo de la base de Gemini 2.5 Flash-Lite, esta versión alcanza velocidades superiores a los 360 tokens por segundo con un tiempo de respuesta medio de 5,1 segundos, al tiempo que ofrece una mejora sustancial en cuanto a inteligencia. Según el Índice de Inteligencia de Análisis Artificial, la puntuación del modelo ha aumentado en 12 puntos hasta alcanzar los 34, y ha demostrado una fuerte preferencia por parte de los usuarios en la clasificación de Arena.ai, con un rating Elo de 1432.
En áreas clave como las capacidades multimodales y el razonamiento científico, Gemini 3.1 Flash-Lite destaca, obteniendo una puntuación del 86,9 % en la prueba GPQA Diamond y alcanzando una precisión del 76,8 % en el benchmark MMMU-Pro. Su rendimiento supera al de pesos pesados como Claude Opus 4.6 y Kimi K2.5. Cabe destacar que el modelo permite a los desarrolladores ajustar la «profundidad» del razonamiento, lo que facilita una adaptación flexible a distintos escenarios, desde simples tareas de traducción hasta el desarrollo de interfaces de usuario complejas.
Sin embargo, estas mejoras en rendimiento y velocidad conllevan ajustes de coste notables. El precio por un millón de tokens de entrada de Gemini 3.1 Flash-Lite ha aumentado a 0,25 dólares, mientras que el precio de salida ha pasado de 0,40 a 1,50 dólares, casi triplicando los costes anteriores.
Esta estrategia de precios pone de relieve las presiones de costes a las que se enfrentan los proveedores de modelos a la hora de equilibrar una inferencia rápida con una lógica de alta precisión. Ahora que el modelo está disponible para su prueba en Google AI Studio y Vertex AI, el mercado de los modelos ligeros está pasando de una simple «competencia de precios bajos» a una nueva era de «accesibilidad a la lógica de alto rendimiento».







 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
 Slackbot se convierte en un agente de IA
Slackbot, el asistente automatizado integrado en la plataforma de mensajería corporativa Slack de Salesforce, está evolucionando hacia un agente de inteligencia artificial. El CTO de Salesforce, Parker Harris, prevé que alcance un estatus viral compa

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai












