


 Hogar
Desafíos de la Anotación con IA: El Mito del Etiquetado Automatizado
La investigación en aprendizaje automático a menudo asume que la IA puede mejorar las anotaciones de conjuntos de datos, especialmente las descripciones de imágenes para modelos de visión-lenguaje (VLMs), para reducir costos y la carga de supervisión humana.
Esto recuerda al meme de principios de los 2000 "descarga más RAM", que se burlaba de la idea de que el software podía solucionar los límites del hardware.
Sin embargo, la calidad de la anotación a menudo se pasa por alto, opacada por el entusiasmo por los nuevos modelos de IA, a pesar de su papel crítico en los procesos de aprendizaje automático.
La capacidad de la IA para identificar y replicar patrones depende de anotaciones humanas de alta calidad y consistentes: etiquetas y descripciones creadas por personas que toman decisiones subjetivas en entornos imperfectos.
Los sistemas que intentan imitar el comportamiento de los anotadores para reemplazar a los humanos y escalar el etiquetado preciso enfrentan dificultades con datos no incluidos en los ejemplos proporcionados por humanos. La similitud no equivale a equivalencia, y la consistencia entre dominios sigue siendo esquiva en la visión por computadora.
En última instancia, el juicio humano define los datos que dan forma a los sistemas de IA.
Soluciones RAG
Hasta hace poco, los errores en las anotaciones de conjuntos de datos se toleraban como compensaciones menores, dado los resultados imperfectos pero comercializables de la IA generativa.
Un estudio de Singapur de 2025 encontró que las alucinaciones —la IA generando resultados falsos— son inherentes al diseño de estos sistemas.
Los agentes basados en RAG, que verifican hechos mediante búsquedas en internet, están ganando tracción en aplicaciones de investigación y comerciales, pero aumentan los costos de recursos y los retrasos en las consultas. La nueva información aplicada a modelos entrenados carece de la profundidad de las conexiones nativas del modelo.
Las anotaciones defectuosas socavan el rendimiento del modelo, y mejorar su calidad, aunque imperfecta debido a la subjetividad humana, es crítico.
Perspectivas de RePOPE
Un estudio alemán expone fallos en conjuntos de datos antiguos, enfocándose en la precisión de las descripciones de imágenes en puntos de referencia como MSCOCO. Revela cómo los errores en las etiquetas distorsionan las evaluaciones de alucinaciones en modelos de visión-lenguaje.
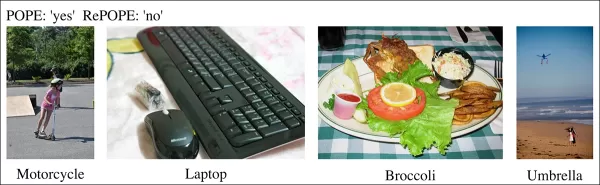
Ejemplos de un estudio reciente que muestra una identificación incorrecta de objetos en las descripciones del conjunto de datos MSCOCO. Las revisiones manuales al punto de referencia POPE destacan las trampas de reducir costos en la curación de anotaciones. Fuente: https://arxiv.org/pdf/2504.15707
Considera una IA evaluando una imagen de una escena callejera en busca de una bicicleta. Si el modelo dice sí pero el conjunto de datos afirma no, se marca como incorrecto. Sin embargo, si una bicicleta está visiblemente presente pero no se anotó, el modelo es correcto y el conjunto de datos está defectuoso. Tales errores sesgan la precisión del modelo y las métricas de alucinación.
Las anotaciones incorrectas o vagas pueden hacer que modelos precisos parezcan propensos a errores o que modelos defectuosos parezcan fiables, complicando el diagnóstico de alucinaciones y la clasificación de modelos.
El estudio revisita el punto de referencia de Evaluación de Sondeo de Objetos basado en Encuestas (POPE), que prueba la capacidad de los modelos de visión-lenguaje para identificar objetos en imágenes usando etiquetas de MSCOCO.
POPE replantea la alucinación como una tarea de clasificación sí/no, preguntando a los modelos si objetos específicos aparecen en las imágenes, usando prompts como “¿Hay un en la imagen?”
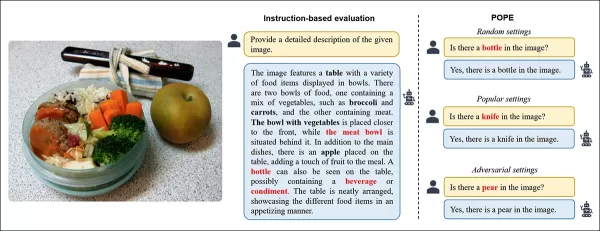
Ejemplos de alucinación de objetos en modelos de visión-lenguaje. Las etiquetas en negrita marcan objetos en las anotaciones originales; las etiquetas rojas destacan objetos alucinados por el modelo. El ejemplo de la izquierda usa una evaluación tradicional, mientras que los tres de la derecha provienen de variantes de POPE. Fuente: https://aclanthology.org/2023.emnlp-main.20.pdf
Los objetos de verdad (respuesta: Sí) se emparejan con objetos inexistentes (respuesta: No), seleccionados aleatoriamente, frecuentemente o basados en co-ocurrencia. Esto permite una evaluación de alucinaciones estable e independiente de prompts sin un análisis complejo de descripciones.
El estudio, RePOPE: Impacto de los Errores de Anotación en el Punto de Referencia POPE, revisa las etiquetas de MSCOCO y encuentra muchos errores o ambigüedades.
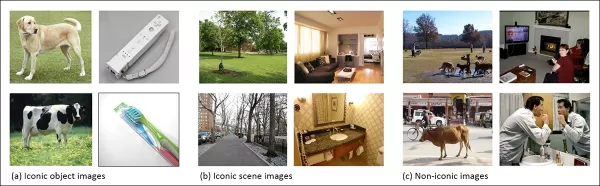
Imágenes del conjunto de datos MSCOCO de 2014. Fuente: https://arxiv.org/pdf/1405.0312
Estos errores alteran las clasificaciones de modelos, con algunos de los mejores desempeños cayendo al evaluarse contra etiquetas corregidas.
Las pruebas en modelos de visión-lenguaje de peso abierto usando el POPE original y el RePOPE reetiquetado muestran cambios significativos en las clasificaciones, especialmente en las puntuaciones F1, con varios modelos cayendo en rendimiento.
El estudio argumenta que los errores de anotación ocultan la verdadera alucinación del modelo, presentando a RePOPE como una herramienta de evaluación más precisa.
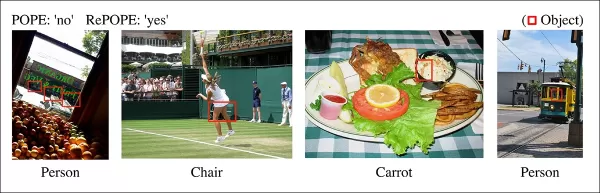
Ejemplos del estudio que muestran descripciones de POPE que omiten objetos sutiles, como una persona cerca de la cabina de un tranvía o una silla oscurecida por un tenista.
Metodología y Pruebas
Los investigadores reetiquetaron las anotaciones de MSCOCO con dos revisores humanos por instancia. Los casos ambiguos, como los descritos a continuación, fueron excluidos de las pruebas.
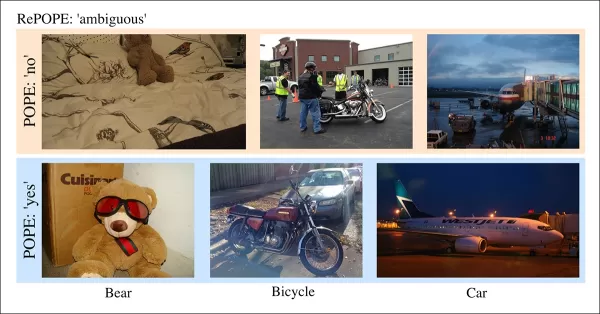
Casos ambiguos en POPE con etiquetas poco claras, como osos de peluche como osos o motocicletas como bicicletas, excluidos de RePOPE debido a clasificaciones subjetivas e inconsistencias de MSCOCO.
El artículo señala:
“Los anotadores originales pasaron por alto personas en el fondo o detrás de cristales, sillas oscurecidas por un tenista, o una zanahoria tenue en una ensalada de col.”
“Las etiquetas inconsistentes de MSCOCO, como clasificar un oso de peluche como oso o una motocicleta como bicicleta, provienen de definiciones de objetos variables, marcando tales casos como ambiguos.”
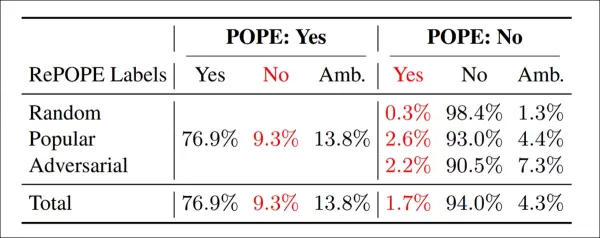
Resultados de la re-anotación: En las variantes de POPE, el 9.3% de las etiquetas ‘Sí’ fueron incorrectas, el 13.8% ambiguas; el 1.7% de las etiquetas ‘No’ estaban mal etiquetadas, el 4.3% ambiguas.
El equipo probó modelos de peso abierto, incluyendo InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B y PaliGemma2, en POPE y RePOPE.
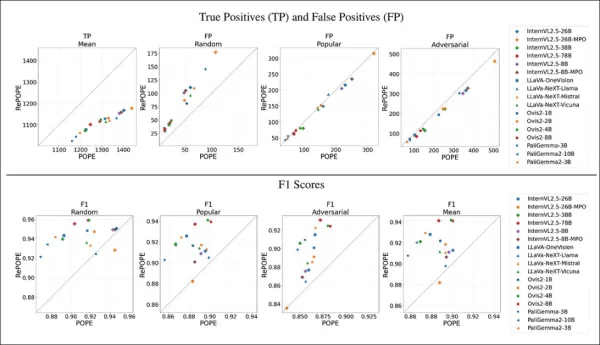
Los resultados muestran que los errores de etiquetas originales causaron una caída en los verdaderos positivos. Los falsos positivos se duplicaron en el subconjunto aleatorio, se mantuvieron estables en el subconjunto popular y disminuyeron ligeramente en el subconjunto adversario. El reetiquetado cambió las clasificaciones F1, con modelos como Ovis2-4B y -8B subiendo a la cima.
Los gráficos muestran que los verdaderos positivos cayeron en todos los modelos, ya que las respuestas correctas a menudo se basaban en etiquetas defectuosas, mientras que los falsos positivos variaron.
En el subconjunto aleatorio de POPE, los falsos positivos casi se duplicaron, revelando objetos presentes pero omitidos en las anotaciones originales. En el subconjunto adversario, los falsos positivos disminuyeron, ya que los objetos ausentes a menudo no estaban etiquetados pero presentes.
La precisión y el recuerdo se vieron afectados, pero las clasificaciones de modelos permanecieron estables. Las puntuaciones F1, la métrica clave de POPE, cambiaron significativamente, con los mejores modelos como InternVL2.5-8B cayendo y Ovis2-4B y -8B subiendo.
Las puntuaciones de precisión fueron menos fiables debido a ejemplos positivos y negativos desiguales en el conjunto de datos corregido.
El estudio enfatiza la necesidad de anotaciones de alta calidad y comparte etiquetas corregidas en GitHub, señalando que RePOPE por sí solo no aborda completamente la saturación de puntos de referencia, ya que los modelos aún obtienen más del 90% en verdaderos positivos y negativos. Se recomiendan puntos de referencia adicionales como DASH-B.
Conclusión
Este estudio, factible debido al pequeño conjunto de datos, destaca los desafíos de escalar a conjuntos de datos de hiperescala, donde aislar datos representativos es difícil y puede sesgar los resultados.
Incluso si es factible, los métodos actuales apuntan a la necesidad de una anotación humana mejor y más extensa.
‘Mejor’ y ‘más’ plantean desafíos distintos. Las plataformas de bajo costo como Amazon Mechanical Turk arriesgan anotaciones de mala calidad, mientras que la subcontratación a diferentes regiones puede no alinearse con el caso de uso previsto del modelo.
Esto sigue siendo un problema central y no resuelto en la economía del aprendizaje automático.
Publicado por primera vez el miércoles, 23 de abril de 2025
Artículo relacionado
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (2)
0/500
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
La investigación en aprendizaje automático a menudo asume que la IA puede mejorar las anotaciones de conjuntos de datos, especialmente las descripciones de imágenes para modelos de visión-lenguaje (VLMs), para reducir costos y la carga de supervisión humana.
Esto recuerda al meme de principios de los 2000 "descarga más RAM", que se burlaba de la idea de que el software podía solucionar los límites del hardware.
Sin embargo, la calidad de la anotación a menudo se pasa por alto, opacada por el entusiasmo por los nuevos modelos de IA, a pesar de su papel crítico en los procesos de aprendizaje automático.
La capacidad de la IA para identificar y replicar patrones depende de anotaciones humanas de alta calidad y consistentes: etiquetas y descripciones creadas por personas que toman decisiones subjetivas en entornos imperfectos.
Los sistemas que intentan imitar el comportamiento de los anotadores para reemplazar a los humanos y escalar el etiquetado preciso enfrentan dificultades con datos no incluidos en los ejemplos proporcionados por humanos. La similitud no equivale a equivalencia, y la consistencia entre dominios sigue siendo esquiva en la visión por computadora.
En última instancia, el juicio humano define los datos que dan forma a los sistemas de IA.
Soluciones RAG
Hasta hace poco, los errores en las anotaciones de conjuntos de datos se toleraban como compensaciones menores, dado los resultados imperfectos pero comercializables de la IA generativa.
Un estudio de Singapur de 2025 encontró que las alucinaciones —la IA generando resultados falsos— son inherentes al diseño de estos sistemas.
Los agentes basados en RAG, que verifican hechos mediante búsquedas en internet, están ganando tracción en aplicaciones de investigación y comerciales, pero aumentan los costos de recursos y los retrasos en las consultas. La nueva información aplicada a modelos entrenados carece de la profundidad de las conexiones nativas del modelo.
Las anotaciones defectuosas socavan el rendimiento del modelo, y mejorar su calidad, aunque imperfecta debido a la subjetividad humana, es crítico.
Perspectivas de RePOPE
Un estudio alemán expone fallos en conjuntos de datos antiguos, enfocándose en la precisión de las descripciones de imágenes en puntos de referencia como MSCOCO. Revela cómo los errores en las etiquetas distorsionan las evaluaciones de alucinaciones en modelos de visión-lenguaje.
Ejemplos de un estudio reciente que muestra una identificación incorrecta de objetos en las descripciones del conjunto de datos MSCOCO. Las revisiones manuales al punto de referencia POPE destacan las trampas de reducir costos en la curación de anotaciones. Fuente: https://arxiv.org/pdf/2504.15707
Considera una IA evaluando una imagen de una escena callejera en busca de una bicicleta. Si el modelo dice sí pero el conjunto de datos afirma no, se marca como incorrecto. Sin embargo, si una bicicleta está visiblemente presente pero no se anotó, el modelo es correcto y el conjunto de datos está defectuoso. Tales errores sesgan la precisión del modelo y las métricas de alucinación.
Las anotaciones incorrectas o vagas pueden hacer que modelos precisos parezcan propensos a errores o que modelos defectuosos parezcan fiables, complicando el diagnóstico de alucinaciones y la clasificación de modelos.
El estudio revisita el punto de referencia de Evaluación de Sondeo de Objetos basado en Encuestas (POPE), que prueba la capacidad de los modelos de visión-lenguaje para identificar objetos en imágenes usando etiquetas de MSCOCO.
POPE replantea la alucinación como una tarea de clasificación sí/no, preguntando a los modelos si objetos específicos aparecen en las imágenes, usando prompts como “¿Hay un
Ejemplos de alucinación de objetos en modelos de visión-lenguaje. Las etiquetas en negrita marcan objetos en las anotaciones originales; las etiquetas rojas destacan objetos alucinados por el modelo. El ejemplo de la izquierda usa una evaluación tradicional, mientras que los tres de la derecha provienen de variantes de POPE. Fuente: https://aclanthology.org/2023.emnlp-main.20.pdf
Los objetos de verdad (respuesta: Sí) se emparejan con objetos inexistentes (respuesta: No), seleccionados aleatoriamente, frecuentemente o basados en co-ocurrencia. Esto permite una evaluación de alucinaciones estable e independiente de prompts sin un análisis complejo de descripciones.
El estudio, RePOPE: Impacto de los Errores de Anotación en el Punto de Referencia POPE, revisa las etiquetas de MSCOCO y encuentra muchos errores o ambigüedades.
Imágenes del conjunto de datos MSCOCO de 2014. Fuente: https://arxiv.org/pdf/1405.0312
Estos errores alteran las clasificaciones de modelos, con algunos de los mejores desempeños cayendo al evaluarse contra etiquetas corregidas.
Las pruebas en modelos de visión-lenguaje de peso abierto usando el POPE original y el RePOPE reetiquetado muestran cambios significativos en las clasificaciones, especialmente en las puntuaciones F1, con varios modelos cayendo en rendimiento.
El estudio argumenta que los errores de anotación ocultan la verdadera alucinación del modelo, presentando a RePOPE como una herramienta de evaluación más precisa.
Ejemplos del estudio que muestran descripciones de POPE que omiten objetos sutiles, como una persona cerca de la cabina de un tranvía o una silla oscurecida por un tenista.
Metodología y Pruebas
Los investigadores reetiquetaron las anotaciones de MSCOCO con dos revisores humanos por instancia. Los casos ambiguos, como los descritos a continuación, fueron excluidos de las pruebas.
Casos ambiguos en POPE con etiquetas poco claras, como osos de peluche como osos o motocicletas como bicicletas, excluidos de RePOPE debido a clasificaciones subjetivas e inconsistencias de MSCOCO.
El artículo señala:
“Los anotadores originales pasaron por alto personas en el fondo o detrás de cristales, sillas oscurecidas por un tenista, o una zanahoria tenue en una ensalada de col.”
“Las etiquetas inconsistentes de MSCOCO, como clasificar un oso de peluche como oso o una motocicleta como bicicleta, provienen de definiciones de objetos variables, marcando tales casos como ambiguos.”
Resultados de la re-anotación: En las variantes de POPE, el 9.3% de las etiquetas ‘Sí’ fueron incorrectas, el 13.8% ambiguas; el 1.7% de las etiquetas ‘No’ estaban mal etiquetadas, el 4.3% ambiguas.
El equipo probó modelos de peso abierto, incluyendo InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B y PaliGemma2, en POPE y RePOPE.
Los resultados muestran que los errores de etiquetas originales causaron una caída en los verdaderos positivos. Los falsos positivos se duplicaron en el subconjunto aleatorio, se mantuvieron estables en el subconjunto popular y disminuyeron ligeramente en el subconjunto adversario. El reetiquetado cambió las clasificaciones F1, con modelos como Ovis2-4B y -8B subiendo a la cima.
Los gráficos muestran que los verdaderos positivos cayeron en todos los modelos, ya que las respuestas correctas a menudo se basaban en etiquetas defectuosas, mientras que los falsos positivos variaron.
En el subconjunto aleatorio de POPE, los falsos positivos casi se duplicaron, revelando objetos presentes pero omitidos en las anotaciones originales. En el subconjunto adversario, los falsos positivos disminuyeron, ya que los objetos ausentes a menudo no estaban etiquetados pero presentes.
La precisión y el recuerdo se vieron afectados, pero las clasificaciones de modelos permanecieron estables. Las puntuaciones F1, la métrica clave de POPE, cambiaron significativamente, con los mejores modelos como InternVL2.5-8B cayendo y Ovis2-4B y -8B subiendo.
Las puntuaciones de precisión fueron menos fiables debido a ejemplos positivos y negativos desiguales en el conjunto de datos corregido.
El estudio enfatiza la necesidad de anotaciones de alta calidad y comparte etiquetas corregidas en GitHub, señalando que RePOPE por sí solo no aborda completamente la saturación de puntos de referencia, ya que los modelos aún obtienen más del 90% en verdaderos positivos y negativos. Se recomiendan puntos de referencia adicionales como DASH-B.
Conclusión
Este estudio, factible debido al pequeño conjunto de datos, destaca los desafíos de escalar a conjuntos de datos de hiperescala, donde aislar datos representativos es difícil y puede sesgar los resultados.
Incluso si es factible, los métodos actuales apuntan a la necesidad de una anotación humana mejor y más extensa.
‘Mejor’ y ‘más’ plantean desafíos distintos. Las plataformas de bajo costo como Amazon Mechanical Turk arriesgan anotaciones de mala calidad, mientras que la subcontratación a diferentes regiones puede no alinearse con el caso de uso previsto del modelo.
Esto sigue siendo un problema central y no resuelto en la economía del aprendizaje automático.
Publicado por primera vez el miércoles, 23 de abril de 2025








 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












