


 Дом
Вызовы аннотации AI: Миф об автоматической разметке
Исследования машинного обучения часто предполагают, что ИИ может улучшить аннотации наборов данных, особенно подписи к изображениям для моделей визуально-языкового взаимодействия (VLMs), чтобы снизить затраты и уменьшить необходимость человеческого контроля.
Это напоминает мем начала 2000-х годов «скачай больше оперативной памяти», высмеивающий идею, что программное обеспечение может устранить аппаратные ограничения.
Однако качество аннотаций часто игнорируется, затмеваемое ажиотажем вокруг новых моделей ИИ, несмотря на их критическую роль в процессах машинного обучения.
Способность ИИ определять и воспроизводить шаблоны зависит от высококачественных, последовательных человеческих аннотаций — меток и описаний, созданных людьми, принимающими субъективные решения в неидеальных условиях.
Системы, стремящиеся имитировать поведение аннотаторов для замены людей и масштабирования точной разметки, сталкиваются с трудностями при работе с данными, не включенными в примеры, предоставленные людьми. Сходство не равно эквивалентности, а согласованность между доменами остается недостижимой в компьютерном зрении.
В конечном итоге человеческие суждения определяют данные, которые формируют системы ИИ.
Решения RAG
До недавнего времени ошибки в аннотациях наборов данных считались незначительными компромиссами, учитывая несовершенные, но коммерчески успешные результаты генеративного ИИ.
Исследование 2025 года в Сингапуре показало, что галлюцинации — ИИ, генерирующий ложные результаты, — присущи конструкции этих систем.
Агенты на основе RAG, проверяющие факты через поиск в интернете, набирают популярность в исследованиях и коммерческих приложениях, но увеличивают затраты на ресурсы и задержки запросов. Новая информация, применяемая к обученным моделям, не имеет глубины связей, присущих нативным моделям.
Ошибочные аннотации подрывают производительность моделей, и улучшение их качества, хотя и несовершенное из-за человеческой субъективности, имеет решающее значение.
Инсайты RePOPE
Немецкое исследование выявляет недостатки старых наборов данных, акцентируя внимание на точности подписей к изображениям в бенчмарках, таких как MSCOCO. Оно показывает, как ошибки в метках искажают оценки галлюцинаций в моделях визуально-языкового взаимодействия.
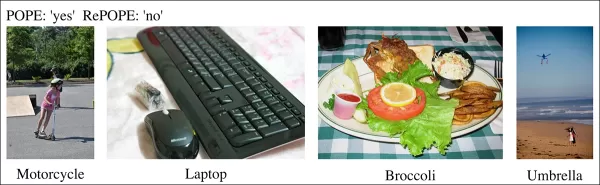
Примеры из недавнего исследования, показывающие неверную идентификацию объектов в подписях набора данных MSCOCO. Ручная доработка бенчмарка POPE подчеркивает недостатки экономии на курировании аннотаций. Источник: https://arxiv.org/pdf/2504.15707
Рассмотрим ИИ, оценивающий изображение уличной сцены на наличие велосипеда. Если модель говорит да, а набор данных утверждает нет, это считается ошибкой. Но если велосипед явно присутствует, но пропущен в аннотации, модель права, а набор данных ошибочен. Такие ошибки искажают точность модели и метрики галлюцинаций.
Неверные или расплывчатые аннотации могут сделать точные модели кажущимися ошибочными, а ошибочные — надежными, усложняя диагностику галлюцинаций и ранжирование моделей.
Исследование пересматривает бенчмарк Polling-based Object Probing Evaluation (POPE), который тестирует способность моделей визуально-языкового взаимодействия идентифицировать объекты на изображениях с использованием меток MSCOCO.
POPE переформулирует галлюцинацию как задачу классификации да/нет, спрашивая модели, присутствует ли конкретный объект на изображении, используя подсказки вроде «Есть ли на изображении?»
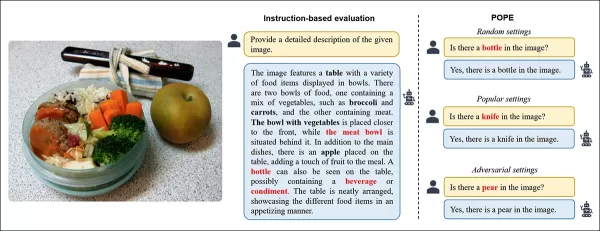
Примеры галлюцинаций объектов в моделях визуально-языкового взаимодействия. Жирные метки обозначают объекты в исходных аннотациях; красные метки выделяют объекты, галлюцинированные моделями. Левый пример использует традиционную оценку, а три справа — из вариантов POPE. Источник: https://aclanthology.org/2023.emnlp-main.20.pdf
Объекты, присутствующие в действительности (ответ: Да), сопоставляются с несуществующими объектами (ответ: Нет), выбранными случайно, часто или на основе совместного появления. Это обеспечивает стабильную оценку галлюцинаций, независимую от подсказок, без сложного анализа подписей.
Исследование, RePOPE: Влияние ошибок аннотации на бенчмарк POPE, перепроверяет метки MSCOCO и выявляет множество ошибок или двусмысленностей.
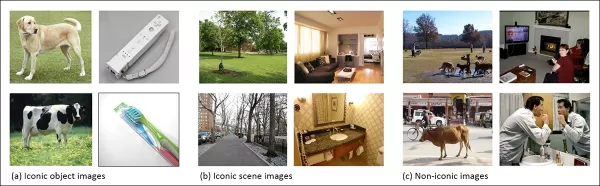
Изображения из набора данных MSCOCO 2014 года. Источник: https://arxiv.org/pdf/1405.0312
Эти ошибки изменяют рейтинги моделей, причем некоторые лидеры падают при оценке с исправленными метками.
Тесты на моделях с открытым весом с использованием исходного POPE и перемаркированного RePOPE показывают значительные сдвиги в рейтингах, особенно в F1-показателях, с падением производительности нескольких моделей.
Исследование утверждает, что ошибки аннотации скрывают истинные галлюцинации моделей, представляя RePOPE как более точный инструмент оценки.
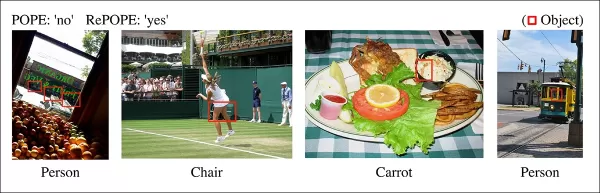
Примеры из исследования, показывающие, что подписи POPE упускают тонкие объекты, такие как человек рядом с кабиной трамвая или стул, скрытый теннисистом.
Методология и тестирование
Исследователи перемаркировали аннотации MSCOCO с двумя человеческими рецензентами на каждый случай. Двусмысленные случаи, как указано ниже, были исключены из тестирования.
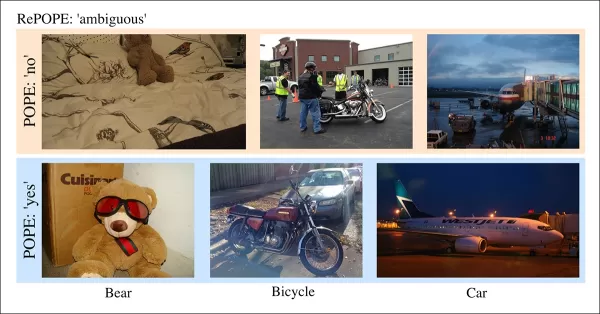
Двусмысленные случаи в POPE с нечеткими метками, например, плюшевый мишка как медведь или мотоцикл как велосипед, исключены из RePOPE из-за субъективных классификаций и несоответствий MSCOCO.
В статье отмечается:
«Исходные аннотаторы упустили людей на заднем плане или за стеклом, стулья, скрытые теннисистом, или едва заметную морковь в салате.»
«Непоследовательные метки MSCOCO, такие как классификация плюшевого мишки как медведя или мотоцикла как велосипеда, связаны с различиями в определениях объектов, что делает такие случаи двусмысленными.»
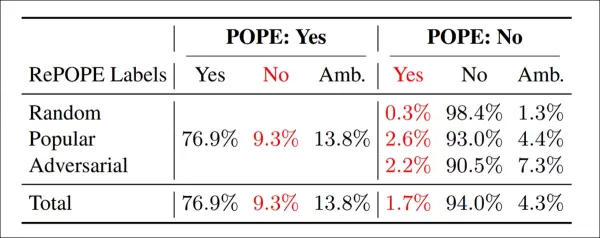
Результаты перемаркировки: в вариантах POPE 9,3% меток «Да» были неверными, 13,8% — двусмысленными; 1,7% меток «Нет» были ошибочными, 4,3% — двусмысленными.
Команда протестировала модели с открытым весом, включая InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B и PaliGemma2, на POPE и RePOPE.
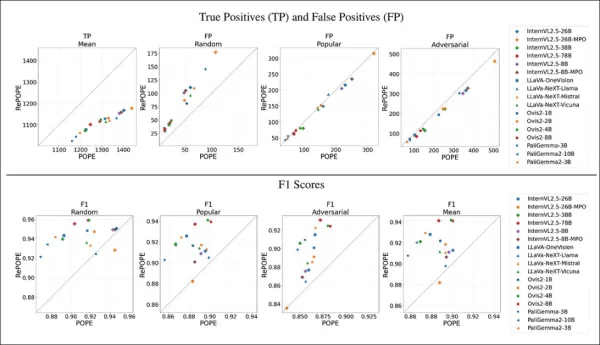
Результаты показывают, что ошибки исходных меток вызвали снижение истинных позитивов. Ложные позитивы удвоились в случайном подмножестве, остались стабильными в популярном и слегка снизились в антагонистическом. Перемаркировка изменила рейтинги F1, с моделями, такими как Ovis2-4B и -8B, поднявшимися на вершину.
Графики показывают снижение истинных позитивов у моделей, так как правильные ответы часто основывались на ошибочных метках, в то время как ложные позитивы варьировались.
В случайном подмножестве POPE ложные позитивы почти удвоились, выявляя объекты, присутствующие, но пропущенные в исходных аннотациях. В антагонистическом подмножестве ложные позитивы снизились, так как отсутствующие объекты часто не были помечены, но присутствовали.
Точность и полнота пострадали, но рейтинги моделей остались стабильными. Показатели F1, ключевые для POPE, значительно изменились, с падением топ-моделей, таких как InternVL2.5-8B, и ростом Ovis2-4B и -8B.
Показатели точности были менее надежными из-за неравномерного количества позитивных и негативных примеров в исправленном наборе данных.
Исследование подчеркивает необходимость высококачественных аннотаций и публикует исправленные метки на GitHub, отмечая, что RePOPE сам по себе не решает проблему насыщения бенчмарков, так как модели по-прежнему набирают более 90% по истинным позитивным и негативным результатам. Рекомендуются дополнительные бенчмарки, такие как DASH-B.
Заключение
Это исследование, возможное благодаря небольшому набору данных, подчеркивает трудности масштабирования на гипермасштабные наборы данных, где выделение репрезентативных данных сложно и может искажать результаты.
Даже если это возможно, текущие методы указывают на необходимость более качественной и обширной человеческой аннотации.
«Лучше» и «больше» создают разные проблемы. Недорогие платформы, такие как Amazon Mechanical Turk, рискуют дать низкокачественные аннотации, а аутсорсинг в разные регионы может не соответствовать предполагаемому использованию модели.
Это остается ключевой, нерешенной проблемой в экономике машинного обучения.
Впервые опубликовано в среду, 23 апреля 2025 года
Связанная статья
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (2)
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
Исследования машинного обучения часто предполагают, что ИИ может улучшить аннотации наборов данных, особенно подписи к изображениям для моделей визуально-языкового взаимодействия (VLMs), чтобы снизить затраты и уменьшить необходимость человеческого контроля.
Это напоминает мем начала 2000-х годов «скачай больше оперативной памяти», высмеивающий идею, что программное обеспечение может устранить аппаратные ограничения.
Однако качество аннотаций часто игнорируется, затмеваемое ажиотажем вокруг новых моделей ИИ, несмотря на их критическую роль в процессах машинного обучения.
Способность ИИ определять и воспроизводить шаблоны зависит от высококачественных, последовательных человеческих аннотаций — меток и описаний, созданных людьми, принимающими субъективные решения в неидеальных условиях.
Системы, стремящиеся имитировать поведение аннотаторов для замены людей и масштабирования точной разметки, сталкиваются с трудностями при работе с данными, не включенными в примеры, предоставленные людьми. Сходство не равно эквивалентности, а согласованность между доменами остается недостижимой в компьютерном зрении.
В конечном итоге человеческие суждения определяют данные, которые формируют системы ИИ.
Решения RAG
До недавнего времени ошибки в аннотациях наборов данных считались незначительными компромиссами, учитывая несовершенные, но коммерчески успешные результаты генеративного ИИ.
Исследование 2025 года в Сингапуре показало, что галлюцинации — ИИ, генерирующий ложные результаты, — присущи конструкции этих систем.
Агенты на основе RAG, проверяющие факты через поиск в интернете, набирают популярность в исследованиях и коммерческих приложениях, но увеличивают затраты на ресурсы и задержки запросов. Новая информация, применяемая к обученным моделям, не имеет глубины связей, присущих нативным моделям.
Ошибочные аннотации подрывают производительность моделей, и улучшение их качества, хотя и несовершенное из-за человеческой субъективности, имеет решающее значение.
Инсайты RePOPE
Немецкое исследование выявляет недостатки старых наборов данных, акцентируя внимание на точности подписей к изображениям в бенчмарках, таких как MSCOCO. Оно показывает, как ошибки в метках искажают оценки галлюцинаций в моделях визуально-языкового взаимодействия.
Примеры из недавнего исследования, показывающие неверную идентификацию объектов в подписях набора данных MSCOCO. Ручная доработка бенчмарка POPE подчеркивает недостатки экономии на курировании аннотаций. Источник: https://arxiv.org/pdf/2504.15707
Рассмотрим ИИ, оценивающий изображение уличной сцены на наличие велосипеда. Если модель говорит да, а набор данных утверждает нет, это считается ошибкой. Но если велосипед явно присутствует, но пропущен в аннотации, модель права, а набор данных ошибочен. Такие ошибки искажают точность модели и метрики галлюцинаций.
Неверные или расплывчатые аннотации могут сделать точные модели кажущимися ошибочными, а ошибочные — надежными, усложняя диагностику галлюцинаций и ранжирование моделей.
Исследование пересматривает бенчмарк Polling-based Object Probing Evaluation (POPE), который тестирует способность моделей визуально-языкового взаимодействия идентифицировать объекты на изображениях с использованием меток MSCOCO.
POPE переформулирует галлюцинацию как задачу классификации да/нет, спрашивая модели, присутствует ли конкретный объект на изображении, используя подсказки вроде «Есть ли на изображении?»
Примеры галлюцинаций объектов в моделях визуально-языкового взаимодействия. Жирные метки обозначают объекты в исходных аннотациях; красные метки выделяют объекты, галлюцинированные моделями. Левый пример использует традиционную оценку, а три справа — из вариантов POPE. Источник: https://aclanthology.org/2023.emnlp-main.20.pdf
Объекты, присутствующие в действительности (ответ: Да), сопоставляются с несуществующими объектами (ответ: Нет), выбранными случайно, часто или на основе совместного появления. Это обеспечивает стабильную оценку галлюцинаций, независимую от подсказок, без сложного анализа подписей.
Исследование, RePOPE: Влияние ошибок аннотации на бенчмарк POPE, перепроверяет метки MSCOCO и выявляет множество ошибок или двусмысленностей.
Изображения из набора данных MSCOCO 2014 года. Источник: https://arxiv.org/pdf/1405.0312
Эти ошибки изменяют рейтинги моделей, причем некоторые лидеры падают при оценке с исправленными метками.
Тесты на моделях с открытым весом с использованием исходного POPE и перемаркированного RePOPE показывают значительные сдвиги в рейтингах, особенно в F1-показателях, с падением производительности нескольких моделей.
Исследование утверждает, что ошибки аннотации скрывают истинные галлюцинации моделей, представляя RePOPE как более точный инструмент оценки.
Примеры из исследования, показывающие, что подписи POPE упускают тонкие объекты, такие как человек рядом с кабиной трамвая или стул, скрытый теннисистом.
Методология и тестирование
Исследователи перемаркировали аннотации MSCOCO с двумя человеческими рецензентами на каждый случай. Двусмысленные случаи, как указано ниже, были исключены из тестирования.
Двусмысленные случаи в POPE с нечеткими метками, например, плюшевый мишка как медведь или мотоцикл как велосипед, исключены из RePOPE из-за субъективных классификаций и несоответствий MSCOCO.
В статье отмечается:
«Исходные аннотаторы упустили людей на заднем плане или за стеклом, стулья, скрытые теннисистом, или едва заметную морковь в салате.»
«Непоследовательные метки MSCOCO, такие как классификация плюшевого мишки как медведя или мотоцикла как велосипеда, связаны с различиями в определениях объектов, что делает такие случаи двусмысленными.»
Результаты перемаркировки: в вариантах POPE 9,3% меток «Да» были неверными, 13,8% — двусмысленными; 1,7% меток «Нет» были ошибочными, 4,3% — двусмысленными.
Команда протестировала модели с открытым весом, включая InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B и PaliGemma2, на POPE и RePOPE.
Результаты показывают, что ошибки исходных меток вызвали снижение истинных позитивов. Ложные позитивы удвоились в случайном подмножестве, остались стабильными в популярном и слегка снизились в антагонистическом. Перемаркировка изменила рейтинги F1, с моделями, такими как Ovis2-4B и -8B, поднявшимися на вершину.
Графики показывают снижение истинных позитивов у моделей, так как правильные ответы часто основывались на ошибочных метках, в то время как ложные позитивы варьировались.
В случайном подмножестве POPE ложные позитивы почти удвоились, выявляя объекты, присутствующие, но пропущенные в исходных аннотациях. В антагонистическом подмножестве ложные позитивы снизились, так как отсутствующие объекты часто не были помечены, но присутствовали.
Точность и полнота пострадали, но рейтинги моделей остались стабильными. Показатели F1, ключевые для POPE, значительно изменились, с падением топ-моделей, таких как InternVL2.5-8B, и ростом Ovis2-4B и -8B.
Показатели точности были менее надежными из-за неравномерного количества позитивных и негативных примеров в исправленном наборе данных.
Исследование подчеркивает необходимость высококачественных аннотаций и публикует исправленные метки на GitHub, отмечая, что RePOPE сам по себе не решает проблему насыщения бенчмарков, так как модели по-прежнему набирают более 90% по истинным позитивным и негативным результатам. Рекомендуются дополнительные бенчмарки, такие как DASH-B.
Заключение
Это исследование, возможное благодаря небольшому набору данных, подчеркивает трудности масштабирования на гипермасштабные наборы данных, где выделение репрезентативных данных сложно и может искажать результаты.
Даже если это возможно, текущие методы указывают на необходимость более качественной и обширной человеческой аннотации.
«Лучше» и «больше» создают разные проблемы. Недорогие платформы, такие как Amazon Mechanical Turk, рискуют дать низкокачественные аннотации, а аутсорсинг в разные регионы может не соответствовать предполагаемому использованию модели.
Это остается ключевой, нерешенной проблемой в экономике машинного обучения.
Впервые опубликовано в среду, 23 апреля 2025 года








 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
 Как исправить Core Web Vitals для улучшения позиций в поисковой выдаче
Оптимизация написания комментариев в отчетных карточках с помощью ИИ-инструментовВведениеИИ-инструменты для генерации комментариев в отчетных карточкахMagic SchoolAlmanac AIChat GPTИспользование Magic School для генерации комментариев в отчетны

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












