


 집
AI 주석 도전: 자동 라벨링의 신화
기계 학습 연구에서는 AI가 데이터셋 주석, 특히 시각-언어 모델(VLM)을 위한 이미지 캡션을 개선하여 비용을 절감하고 인간 감독 부담을 줄일 수 있다고 가정합니다.
이는 2000년대 초반 'RAM 더 다운로드' 밈을 떠올리게 하며, 소프트웨어가 하드웨어 한계를 해결할 수 있다는 아이디어를 비웃습니다.
그러나 주석 품질은 종종 간과되며, 새로운 AI 모델에 대한 소음에 묻혀 기계 학습 파이프라인에서 중요한 역할을 합니다.
AI가 패턴을 식별하고 복제하는 능력은 고품질의 일관된 인간 주석—사람들이 불완전한 환경에서 주관적인 판단으로 만든 라벨과 설명—에 달려 있습니다.
인간을 대체하고 정확한 라벨링을 확장하기 위해 주석자 행동을 모방하려는 시스템은 인간이 제공한 예시에 포함되지 않은 데이터에 직면하면 어려움을 겪습니다. 유사성은 동일성을 의미하지 않으며, 컴퓨터 비전에서 도메인 간 일관성은 여전히 어렵습니다.
궁극적으로 인간의 판단은 AI 시스템을 형성하는 데이터를 정의합니다.
RAG 솔루션
최근까지 데이터셋 주석의 오류는 생성 AI의 불완전하지만 시장성 있는 출력으로 인해 사소한 타협으로 용인되었습니다.
2025년 싱가포르 연구는 환각—AI가 잘못된 출력을 생성하는 것—이 이러한 시스템 설계에 내재되어 있음을 발견했습니다.
인터넷 검색을 통해 사실을 검증하는 RAG 기반 에이전트는 연구 및 상업 응용에서 주목받고 있지만, 자원 비용과 쿼리 지연을 증가시킵니다. 훈련된 모델에 적용된 새로운 정보는 네이티브 모델 연결의 깊이를 가지지 않습니다.
잘못된 주석은 모델 성능을 저해하며, 인간의 주관성으로 인해 불완전하지만 주석 품질을 개선하는 것이 중요합니다.
RePOPE 통찰
독일 연구는 오래된 데이터셋의 결함을 드러내며, MSCOCO와 같은 벤치마크에서 이미지 캡션 정확도에 초점을 맞췄습니다. 이는 라벨 오류가 시각-언어 모델의 환각 평가를 왜곡함을 보여줍니다.
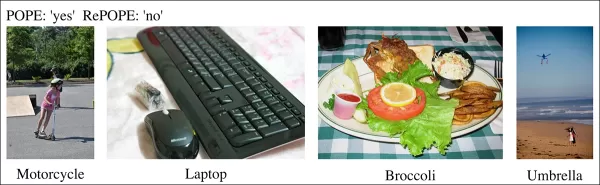
최근 연구에서 MSCOCO 데이터셋 캡션의 잘못된 객체 식별을 보여주는 예시. POPE 벤치마크의 수동 수정은 주석 큐레이션 비용 절감의 함정을 강조합니다. 출처: https://arxiv.org/pdf/2504.15707
AI가 자전거가 있는 거리 장면 이미지를 평가한다고 가정해 봅시다. 모델이 예라고 답했지만 데이터셋이 아니오라고 주장하면 잘못된 것으로 표시됩니다. 그러나 자전거가 명확히 존재하지만 주석에서 누락되었다면, 모델은 맞고 데이터셋은 잘못된 것입니다. 이러한 오류는 모델 정확도와 환각 메트릭을 왜곡합니다.
부정확하거나 모호한 주석은 정확한 모델을 오류가 있는 것처럼 보이게 하거나, 잘못된 모델을 신뢰할 수 있는 것처럼 보이게 하여 환각 진단과 모델 순위를 복잡하게 합니다.
이 연구는 MSCOCO 라벨을 사용하여 이미지에서 객체 식별 능력을 테스트하는 POPE(폴링 기반 객체 탐지 평가) 벤치마크를 재검토합니다.
POPE는 환각을 예/아니오 분류 작업으로 재구성하여, “이미지에 가 있나요?”와 같은 프롬프트를 사용해 모델이 이미지에서 특정 객체를 식별하는지 묻습니다.
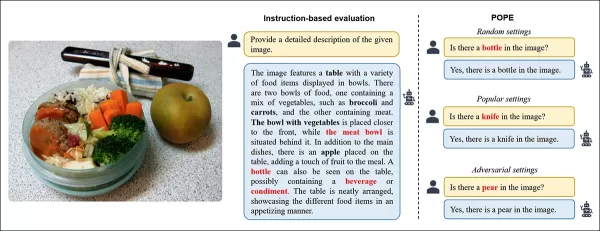
시각-언어 모델에서 객체 환각의 예시. 굵은 라벨은 원래 주석의 객체를 표시하고, 빨간 라벨은 모델이 환각한 객체를 강조합니다. 왼쪽 예시는 전통적인 평가를 사용하며, 오른쪽 세 예시는 POPE 변형에서 가져왔습니다. 출처: https://aclanthology.org/2023.emnlp-main.20.pdf
참인 객체(답변: 예)는 존재하지 않는 객체(답변: 아니오)와 쌍을 이루며, 무작위, 빈번, 또는 동시 발생을 기반으로 선택됩니다. 이를 통해 복잡한 캡션 분석 없이 안정적이고 프롬프트 독립적인 환각 평가가 가능합니다.
RePOPE: POPE 벤치마크에서 주석 오류의 영향 연구는 MSCOCO 라벨을 재검사하여 많은 오류와 모호성을 발견했습니다.
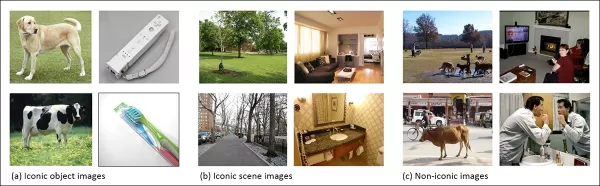
2014 MSCOCO 데이터셋의 이미지. 출처: https://arxiv.org/pdf/1405.0312
이러한 오류는 모델 순위를 변경하며, 일부 상위 모델은 수정된 라벨로 평가 시 순위가 하락했습니다.
원래 POPE와 재라벨링된 RePOPE를 사용한 오픈 웨이트 시각-언어 모델 테스트는 특히 F1 점수에서 큰 순위 변화를 보여주며, 여러 모델의 성능이 하락했습니다.
이 연구는 주석 오류가 실제 모델 환각을 숨긴다고 주장하며, RePOPE를 더 정확한 평가 도구로 제시합니다.
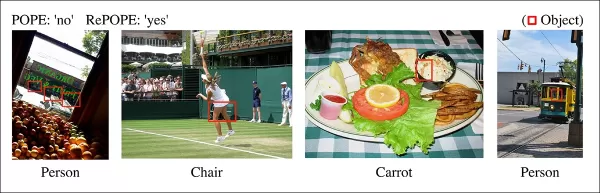
연구에서 POPE 캡션이 트램 객실 근처의 사람이나 테니스 선수에 가려진 의자와 같은 미묘한 객체를 놓친 예시.
방법론 및 테스트
연구자들은 인스턴스당 두 명의 인간 검토자를 통해 MSCOCO 주석을 재라벨링했습니다. 아래와 같은 모호한 사례는 테스트에서 제외되었습니다.
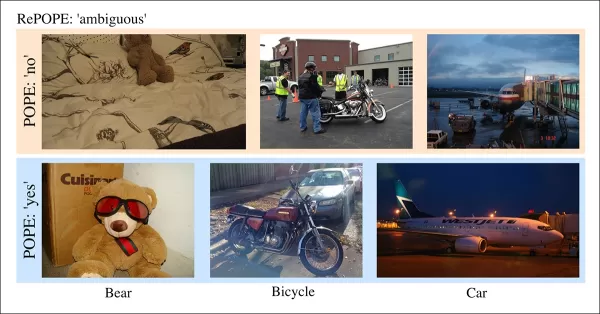
POPE에서 불명확한 라벨로 인한 모호한 사례, 예를 들어 테디베어가 곰으로, 오토바이가 자전거로 라벨링된 경우는 MSCOCO의 불일치와 주관적 분류로 인해 RePOPE에서 제외되었습니다.
논문은 다음과 같이 언급합니다:
“원래 주석자는 배경이나 유리 뒤의 사람, 테니스 선수에 가려진 의자, 또는 양배추 샐러드의 희미한 당근을 간과했습니다.”
“테디베어를 곰으로, 오토바이를 자전거로 분류하는 등 MSCOCO의 일관되지 않은 라벨은 객체 정의의 다양성에서 비롯되며, 이러한 사례를 모호한 것으로 표시합니다.”
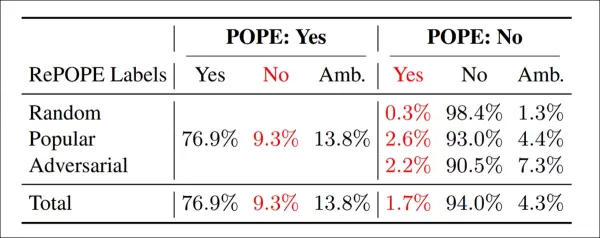
재주석 결과: POPE 변형에서 ‘예’ 라벨의 9.3%가 잘못, 13.8%가 모호; ‘아니오’ 라벨의 1.7%가 잘못, 4.3%가 모호.
팀은 InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B, PaliGemma2를 포함한 오픈 웨이트 모델을 POPE와 RePOPE에서 테스트했습니다.
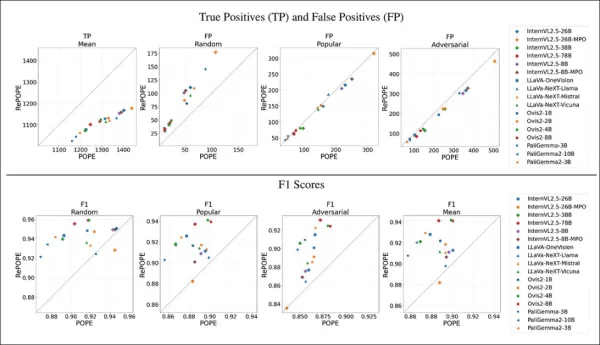
결과는 원래 라벨 오류로 인해 참 긍정이 하락했음을 보여줍니다. 거짓 긍정은 무작위 하위 집합에서 두 배가 되었고, 인기 하위 집합에서는 안정적이며, 적대적 하위 집합에서는 약간 감소했습니다. 재라벨링은 F1 순위를 변화시켰으며, Ovis2-4B와 -8B가 상위로 올라갔습니다.
그래프는 참 긍정이 모델 전반에서 하락했으며, 올바른 답변이 종종 잘못된 라벨에 기반했음을 보여줍니다. 거짓 긍정은 다양했습니다.
POPE의 무작위 하위 집합에서 거짓 긍정은 거의 두 배가 되었으며, 원래 주석에서 누락된 객체가 존재함을 드러냅니다. 적대적 하위 집합에서는 거짓 긍정이 감소했으며, 부재한 객체가 종종 라벨링되지 않았지만 존재했습니다.
정밀도와 재현율이 영향을 받았지만, 모델 순위는 안정적이었습니다. POPE의 주요 메트릭인 F1 점수는 크게 변화했으며, InternVL2.5-8B와 같은 상위 모델이 하락하고 Ovis2-4B와 -8B가 상승했습니다.
정확도 점수는 수정된 데이터셋의 불균등한 긍정 및 부정 예시로 인해 덜 신뢰할 수 있었습니다.
연구는 고품질 주석의 필요성을 강조하며, 수정된 라벨을 GitHub에 공유합니다. RePOPE만으로는 벤치마크 포화 문제를 완전히 해결하지 못하며, 모델은 여전히 참 긍정과 부정에서 90% 이상을 기록합니다. DASH-B와 같은 추가 벤치마크가 권장됩니다.
결론
이 연구는 소규모 데이터셋으로 인해 가능했으며, 대표 데이터를 분리하기 어려운 초대규모 데이터셋으로 확장하는 데 어려움을 강조합니다.
가능하더라도 현재 방법은 더 나은, 더 광범위한 인간 주석의 필요성을 나타냅니다.
‘더 나은’과 ‘더 많은’은 별개의 도전을 제기합니다. Amazon Mechanical Turk와 같은 저비용 플랫폼은 품질 낮은 주석의 위험을 초래하며, 다른 지역으로 아웃소싱하면 모델의 의도된 사용 사례와 맞지 않을 수 있습니다.
이는 기계 학습 경제학의 핵심적이고 해결되지 않은 문제로 남아 있습니다.
2025년 4월 23일 수요일 처음 게시됨
관련 기사
 미국의 주식 시장이 AI와 항공우주 거대 기업들의 1조 달러 데뷔를 앞두고 역사적 이정표에 도달
엘론 머스크, 샘 알트만, 그리고 다리오 아모데이라는 기술 산업의 거인 세 명이 각자의 기업에 대해 공개 시장 상장(IPO)을 앞두고 있다. 스페이스X, 오픈AI, 앤트로픽이라는 세 산업의 거대 기업이 1조 달러 이상의 기업 가치를 달성하며 상장을 준비함에 따라, 2026년은 미국 역사상 신주 발행 측면에서 가장 중요한 해가 될 것으로 전망된다.이러한 역사적인 자본 증가는 전 세계 금융계의 주목을 받고 있으며, 공공 시장이 이러한 규모의 자금
스웨덴의 AI 스타트업 로버블 아이즈, 주요 자금 조달 라운드 이후 132억 달러의 기업 가치 달성
AI 기반 코딩 도구가 인기를 얻으면서 스웨덴 스타트업 로버블(Lovable)이 주요 자금 조달 라운드를 성사시켰다. 이 회사는 30억 달러를 조달하여 지난 12월 기록된 66억 달러의 두 배인 132억 달러의 기업 가치를 달성할 수 있을 것으로 기대된다. 멘로 벤처스(Menlo Ventures)가 이 투자 라운드를 주도할 것으로 예상된다.로버블의 매력은 복잡한 코딩 기술이 필요하지 않은 소프트웨어 제작을 단순화하는 핵심 '바이브 코딩(vib
구글, 사용자 제어 강화에 맞춰 제미니용 레미 AI 에이전트 테스트
비즈니스 인사이더에 따르면, 구글은 제미나이를 위한 새로운 AI 개인 에이전트인 레미를 테스트하고 있습니다. 이 도구는 사용자를 대신하여 작업을 실행하여 전문적인 워크플로우와 일상적인 루틴을 모두 간소화하는 것을 목표로 합니다.현재 레미는 제미나이 애플리케이션의 내부 직원 전용 버전에서 테스트 중입니다. 이 보고서는 내부 문서와 프로젝트에 정통한 두 명의 인물과의 인터뷰를 인용합니다. 내부 자료는 레미를 “24/7 개인 에이전트”로 묘사하며,
관련 특별 주제 추천
데이터 분석
 SaaS 및 이커머스 팀을 위한 KPI 모니터링용 최고의 AI 이상 감지 도구
2026년 최신 최고의 KPI 모니터링용 AI 이상 탐지 도구 SaaS 및 이커머스 팀을 위한 상위 평가 도구! XIX.AI는 엄격한 실제 테스트와 매주 업데이트되는 순위를 기반으로 강력한 게임 체인저 컬렉션을 선별했습니다. 생산성을 높이고 AI 경쟁력을 발휘할 수 있는 필수 솔루션을 식별하는 데 도움이 되는 상세한 무료 대 유료 비교 인사이트를 찾을 수 있습니다. 지금 탐색하세요!
 10 도구
 xix.ai
글쓰기
장문 SEO 기사용 최고의 AI 개요 생성기
XIX.AI가 꼼꼼하게 선별한 2026년 최신 최고 평점을 받은 장문 SEO 기사용 AI 개요 생성기. 이 강력한 도구들은 고품질 콘텐츠를 신속하게 제작하는 데 획기적인 도움을 제공하여 글쓰기 효율을 크게 높여줍니다. 무료 버전과 유료 버전의 비교 정보와 실제 테스트 결과, 상세한 순위 정보를 확인하여 여러분의 필요에 딱 맞는, 꼭 사용해 봐야 할 옵션을 찾아보세요. 지금 바로 살펴보고 AI를 활용한 경쟁력을 확보하세요.
8 도구
xix.ai
교육 및 학습
숙제 및 시험 준비를 위한 AI 학습 도구
2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
10 도구
xix.ai
음악 작곡
songwriter, 후크, 탑라인 및 다국어 초안 세션을 위한 AI 보컬 데모 도구
2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai
사업
중소기업을 위한 최고의 AI 경쟁사 분석 도구
2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai
이미지 편집
이커머스 의류용 Photoshop AI 보정 도구, 피부 결 정리 및 색상 일관성
2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

 의견 (2)
0/500
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
기계 학습 연구에서는 AI가 데이터셋 주석, 특히 시각-언어 모델(VLM)을 위한 이미지 캡션을 개선하여 비용을 절감하고 인간 감독 부담을 줄일 수 있다고 가정합니다.
이는 2000년대 초반 'RAM 더 다운로드' 밈을 떠올리게 하며, 소프트웨어가 하드웨어 한계를 해결할 수 있다는 아이디어를 비웃습니다.
그러나 주석 품질은 종종 간과되며, 새로운 AI 모델에 대한 소음에 묻혀 기계 학습 파이프라인에서 중요한 역할을 합니다.
AI가 패턴을 식별하고 복제하는 능력은 고품질의 일관된 인간 주석—사람들이 불완전한 환경에서 주관적인 판단으로 만든 라벨과 설명—에 달려 있습니다.
인간을 대체하고 정확한 라벨링을 확장하기 위해 주석자 행동을 모방하려는 시스템은 인간이 제공한 예시에 포함되지 않은 데이터에 직면하면 어려움을 겪습니다. 유사성은 동일성을 의미하지 않으며, 컴퓨터 비전에서 도메인 간 일관성은 여전히 어렵습니다.
궁극적으로 인간의 판단은 AI 시스템을 형성하는 데이터를 정의합니다.
RAG 솔루션
최근까지 데이터셋 주석의 오류는 생성 AI의 불완전하지만 시장성 있는 출력으로 인해 사소한 타협으로 용인되었습니다.
2025년 싱가포르 연구는 환각—AI가 잘못된 출력을 생성하는 것—이 이러한 시스템 설계에 내재되어 있음을 발견했습니다.
인터넷 검색을 통해 사실을 검증하는 RAG 기반 에이전트는 연구 및 상업 응용에서 주목받고 있지만, 자원 비용과 쿼리 지연을 증가시킵니다. 훈련된 모델에 적용된 새로운 정보는 네이티브 모델 연결의 깊이를 가지지 않습니다.
잘못된 주석은 모델 성능을 저해하며, 인간의 주관성으로 인해 불완전하지만 주석 품질을 개선하는 것이 중요합니다.
RePOPE 통찰
독일 연구는 오래된 데이터셋의 결함을 드러내며, MSCOCO와 같은 벤치마크에서 이미지 캡션 정확도에 초점을 맞췄습니다. 이는 라벨 오류가 시각-언어 모델의 환각 평가를 왜곡함을 보여줍니다.
최근 연구에서 MSCOCO 데이터셋 캡션의 잘못된 객체 식별을 보여주는 예시. POPE 벤치마크의 수동 수정은 주석 큐레이션 비용 절감의 함정을 강조합니다. 출처: https://arxiv.org/pdf/2504.15707
AI가 자전거가 있는 거리 장면 이미지를 평가한다고 가정해 봅시다. 모델이 예라고 답했지만 데이터셋이 아니오라고 주장하면 잘못된 것으로 표시됩니다. 그러나 자전거가 명확히 존재하지만 주석에서 누락되었다면, 모델은 맞고 데이터셋은 잘못된 것입니다. 이러한 오류는 모델 정확도와 환각 메트릭을 왜곡합니다.
부정확하거나 모호한 주석은 정확한 모델을 오류가 있는 것처럼 보이게 하거나, 잘못된 모델을 신뢰할 수 있는 것처럼 보이게 하여 환각 진단과 모델 순위를 복잡하게 합니다.
이 연구는 MSCOCO 라벨을 사용하여 이미지에서 객체 식별 능력을 테스트하는 POPE(폴링 기반 객체 탐지 평가) 벤치마크를 재검토합니다.
POPE는 환각을 예/아니오 분류 작업으로 재구성하여, “이미지에 가 있나요?”와 같은 프롬프트를 사용해 모델이 이미지에서 특정 객체를 식별하는지 묻습니다.
시각-언어 모델에서 객체 환각의 예시. 굵은 라벨은 원래 주석의 객체를 표시하고, 빨간 라벨은 모델이 환각한 객체를 강조합니다. 왼쪽 예시는 전통적인 평가를 사용하며, 오른쪽 세 예시는 POPE 변형에서 가져왔습니다. 출처: https://aclanthology.org/2023.emnlp-main.20.pdf
참인 객체(답변: 예)는 존재하지 않는 객체(답변: 아니오)와 쌍을 이루며, 무작위, 빈번, 또는 동시 발생을 기반으로 선택됩니다. 이를 통해 복잡한 캡션 분석 없이 안정적이고 프롬프트 독립적인 환각 평가가 가능합니다.
RePOPE: POPE 벤치마크에서 주석 오류의 영향 연구는 MSCOCO 라벨을 재검사하여 많은 오류와 모호성을 발견했습니다.
2014 MSCOCO 데이터셋의 이미지. 출처: https://arxiv.org/pdf/1405.0312
이러한 오류는 모델 순위를 변경하며, 일부 상위 모델은 수정된 라벨로 평가 시 순위가 하락했습니다.
원래 POPE와 재라벨링된 RePOPE를 사용한 오픈 웨이트 시각-언어 모델 테스트는 특히 F1 점수에서 큰 순위 변화를 보여주며, 여러 모델의 성능이 하락했습니다.
이 연구는 주석 오류가 실제 모델 환각을 숨긴다고 주장하며, RePOPE를 더 정확한 평가 도구로 제시합니다.
연구에서 POPE 캡션이 트램 객실 근처의 사람이나 테니스 선수에 가려진 의자와 같은 미묘한 객체를 놓친 예시.
방법론 및 테스트
연구자들은 인스턴스당 두 명의 인간 검토자를 통해 MSCOCO 주석을 재라벨링했습니다. 아래와 같은 모호한 사례는 테스트에서 제외되었습니다.
POPE에서 불명확한 라벨로 인한 모호한 사례, 예를 들어 테디베어가 곰으로, 오토바이가 자전거로 라벨링된 경우는 MSCOCO의 불일치와 주관적 분류로 인해 RePOPE에서 제외되었습니다.
논문은 다음과 같이 언급합니다:
“원래 주석자는 배경이나 유리 뒤의 사람, 테니스 선수에 가려진 의자, 또는 양배추 샐러드의 희미한 당근을 간과했습니다.”
“테디베어를 곰으로, 오토바이를 자전거로 분류하는 등 MSCOCO의 일관되지 않은 라벨은 객체 정의의 다양성에서 비롯되며, 이러한 사례를 모호한 것으로 표시합니다.”
재주석 결과: POPE 변형에서 ‘예’ 라벨의 9.3%가 잘못, 13.8%가 모호; ‘아니오’ 라벨의 1.7%가 잘못, 4.3%가 모호.
팀은 InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B, PaliGemma2를 포함한 오픈 웨이트 모델을 POPE와 RePOPE에서 테스트했습니다.
결과는 원래 라벨 오류로 인해 참 긍정이 하락했음을 보여줍니다. 거짓 긍정은 무작위 하위 집합에서 두 배가 되었고, 인기 하위 집합에서는 안정적이며, 적대적 하위 집합에서는 약간 감소했습니다. 재라벨링은 F1 순위를 변화시켰으며, Ovis2-4B와 -8B가 상위로 올라갔습니다.
그래프는 참 긍정이 모델 전반에서 하락했으며, 올바른 답변이 종종 잘못된 라벨에 기반했음을 보여줍니다. 거짓 긍정은 다양했습니다.
POPE의 무작위 하위 집합에서 거짓 긍정은 거의 두 배가 되었으며, 원래 주석에서 누락된 객체가 존재함을 드러냅니다. 적대적 하위 집합에서는 거짓 긍정이 감소했으며, 부재한 객체가 종종 라벨링되지 않았지만 존재했습니다.
정밀도와 재현율이 영향을 받았지만, 모델 순위는 안정적이었습니다. POPE의 주요 메트릭인 F1 점수는 크게 변화했으며, InternVL2.5-8B와 같은 상위 모델이 하락하고 Ovis2-4B와 -8B가 상승했습니다.
정확도 점수는 수정된 데이터셋의 불균등한 긍정 및 부정 예시로 인해 덜 신뢰할 수 있었습니다.
연구는 고품질 주석의 필요성을 강조하며, 수정된 라벨을 GitHub에 공유합니다. RePOPE만으로는 벤치마크 포화 문제를 완전히 해결하지 못하며, 모델은 여전히 참 긍정과 부정에서 90% 이상을 기록합니다. DASH-B와 같은 추가 벤치마크가 권장됩니다.
결론
이 연구는 소규모 데이터셋으로 인해 가능했으며, 대표 데이터를 분리하기 어려운 초대규모 데이터셋으로 확장하는 데 어려움을 강조합니다.
가능하더라도 현재 방법은 더 나은, 더 광범위한 인간 주석의 필요성을 나타냅니다.
‘더 나은’과 ‘더 많은’은 별개의 도전을 제기합니다. Amazon Mechanical Turk와 같은 저비용 플랫폼은 품질 낮은 주석의 위험을 초래하며, 다른 지역으로 아웃소싱하면 모델의 의도된 사용 사례와 맞지 않을 수 있습니다.
이는 기계 학습 경제학의 핵심적이고 해결되지 않은 문제로 남아 있습니다.
2025년 4월 23일 수요일 처음 게시됨








 미국의 주식 시장이 AI와 항공우주 거대 기업들의 1조 달러 데뷔를 앞두고 역사적 이정표에 도달
엘론 머스크, 샘 알트만, 그리고 다리오 아모데이라는 기술 산업의 거인 세 명이 각자의 기업에 대해 공개 시장 상장(IPO)을 앞두고 있다. 스페이스X, 오픈AI, 앤트로픽이라는 세 산업의 거대 기업이 1조 달러 이상의 기업 가치를 달성하며 상장을 준비함에 따라, 2026년은 미국 역사상 신주 발행 측면에서 가장 중요한 해가 될 것으로 전망된다.이러한 역사적인 자본 증가는 전 세계 금융계의 주목을 받고 있으며, 공공 시장이 이러한 규모의 자금
 스웨덴의 AI 스타트업 로버블 아이즈, 주요 자금 조달 라운드 이후 132억 달러의 기업 가치 달성
AI 기반 코딩 도구가 인기를 얻으면서 스웨덴 스타트업 로버블(Lovable)이 주요 자금 조달 라운드를 성사시켰다. 이 회사는 30억 달러를 조달하여 지난 12월 기록된 66억 달러의 두 배인 132억 달러의 기업 가치를 달성할 수 있을 것으로 기대된다. 멘로 벤처스(Menlo Ventures)가 이 투자 라운드를 주도할 것으로 예상된다.로버블의 매력은 복잡한 코딩 기술이 필요하지 않은 소프트웨어 제작을 단순화하는 핵심 '바이브 코딩(vib
구글, 사용자 제어 강화에 맞춰 제미니용 레미 AI 에이전트 테스트
비즈니스 인사이더에 따르면, 구글은 제미나이를 위한 새로운 AI 개인 에이전트인 레미를 테스트하고 있습니다. 이 도구는 사용자를 대신하여 작업을 실행하여 전문적인 워크플로우와 일상적인 루틴을 모두 간소화하는 것을 목표로 합니다.현재 레미는 제미나이 애플리케이션의 내부 직원 전용 버전에서 테스트 중입니다. 이 보고서는 내부 문서와 프로젝트에 정통한 두 명의 인물과의 인터뷰를 인용합니다. 내부 자료는 레미를 “24/7 개인 에이전트”로 묘사하며,

2026년 최신 최고의 KPI 모니터링용 AI 이상 탐지 도구 SaaS 및 이커머스 팀을 위한 상위 평가 도구! XIX.AI는 엄격한 실제 테스트와 매주 업데이트되는 순위를 기반으로 강력한 게임 체인저 컬렉션을 선별했습니다. 생산성을 높이고 AI 경쟁력을 발휘할 수 있는 필수 솔루션을 식별하는 데 도움이 되는 상세한 무료 대 유료 비교 인사이트를 찾을 수 있습니다. 지금 탐색하세요!
10 도구
xix.ai

XIX.AI가 꼼꼼하게 선별한 2026년 최신 최고 평점을 받은 장문 SEO 기사용 AI 개요 생성기. 이 강력한 도구들은 고품질 콘텐츠를 신속하게 제작하는 데 획기적인 도움을 제공하여 글쓰기 효율을 크게 높여줍니다. 무료 버전과 유료 버전의 비교 정보와 실제 테스트 결과, 상세한 순위 정보를 확인하여 여러분의 필요에 딱 맞는, 꼭 사용해 봐야 할 옵션을 찾아보세요. 지금 바로 살펴보고 AI를 활용한 경쟁력을 확보하세요.
8 도구
xix.ai

2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
10 도구
xix.ai

2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai

2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai

2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












